予測精度は機序理解をどこまで支持するか
On this page
要旨
予測精度、介入効果の予測、機序の特定は異なる推定対象である。モデル選択・摂動予測・識別性の文献と公的枠組みを比較し、turnoverモデルの合成例で違いを確かめた。同程度に適合する係数でも、ゆっくり変化する投与条件の予測は近く、未観測の初期数時間では応答が大きく分かれた。予測の安定性と機序の識別は、対象とする問いと測定設計ごとに判断する必要がある。
文献・公開資料の確認日:2026年10月6日。
背景と目的
あるモデルが、未知データを非常によく予測したとする。では、そのモデルが内部で表現している関係を、病態機序や薬理機序として解釈してよいだろうか。
逆に、ODEや反応ネットワークから作った「機序的な」モデルであれば、そのパラメータや構造を生物学的機序として信じてよいだろうか。
どちらの主張にも、追加の根拠が必要になる。予測と機序推論は重なる部分を持つが、同じ最適化問題ではない。前者には予測の試験が、後者には機序の試験が要る。両方を主張するモデルには、両方の試験を求めたい。
対象と確認範囲
統計的モデル選択、因果推論、single-cell摂動予測、動的モデルの識別性、公的なモデル評価枠組みを対象とする。選択した文献と合成例による論点の比較であり、網羅的レビューや実薬の機序検証ではない。
予測と機序推論の推定対象
予測の目的を単純化すると、未知データでの期待損失を小さくする関数を選ぶことである。
\[ f^{*}=\arg\min_{f}\ \mathbb{E}\left[L\bigl(Y,f(X)\bigr)\right] \]
一方、機序について知りたいときの問いは、例えば次のようなものである。
- このタンパク質を阻害すると、下流のシグナルは変わるか。
- 曝露量を変えたときの薬効の変化は、受容体占有を介しているか。
- バイオマーカーと予後の関連は、介入可能な経路を表しているか。
これらは一種類の問いではない。本記事では、少なくとも三つの層を区別する。
- 観察のもとでの予測:同じ条件で得られる次のデータを当てる。対象は \(P(Y\mid X)\) である。
- 介入のもとでの予測:\(A\) を変えたら \(Y\) がどうなるかを当てる。対象は \(\mathbb{E}[Y\mid do(A=a)]\) や、二つの値 \(a_1,a_0\) の間でのその差である。
- 機序の主張:その効果が、どの経路・どの媒介変数を通って生じるかを述べる。二つ目の問い(受容体占有を介しているか)は、全体の介入効果ではなく媒介の問いである。
観察データで \(Y\) をよく当てられることは、二層目・三層目の問いに答えられることを意味しない。逆に、介入の結果をよく当てられること(二層目)も、それだけでは経路の主張(三層目)を支えない。
Hernánらは、データサイエンスの課題を記述・予測・反事実的予測(因果推論を含む)に分けた (1)。 臨床予測モデルの文脈でも、van Gelovenらは、治療を受けないと仮定したリスクを予測したいのか、現在の診療のもとでのリスクを予測したいのかで、推定対象とデータの扱いが変わると論じている (2)。 反事実的予測は因果推論のためだけのものではない、という指摘もある (3)。 本記事の出発点も同じで、最初に推定対象を書くことである。
なお、本記事では「識別」という語を二つの意味で使う。因果推論の識別(介入効果が観察データの分布から一意に決まるか)と、パラメータの識別性(モデルのパラメータがデータから一意に決まるか)である。前者は因果効果の識別、後者はパラメータ識別性と計算例の話題で、混同しないよう節ごとに明記する。
モデルの同定と回帰関数の推定のトレードオフ
この問題を考えるきっかけとして面白いのが、Yuhong Yangの2005年の論文である (4)。
Yangは回帰のモデル選択について、BIC型の性質(候補に真の有限次元モデルが含まれるとき、それを選ぶ確率が1に近づく一致性)と、AIC型の性質(回帰関数の推定でminimax rateを達成すること)を、一つの選択基準で同時に得られるかを調べた。結論は否定的だった。一致性を持つモデル選択基準は、回帰関数の推定で、最悪の場合(minimaxの意味で)最適な収束率を達成できない。 同じ論文は、Bayesian model averagingもこの意味でminimax-rate optimalにはなれないと示している。
ここで注意したい。Yangの定理は「予測モデルでは因果推論ができない」という一般定理ではない。対象は特定の回帰モデル選択の設定であり、示されたのは「モデルの同定」と「回帰関数の推定」の間の数学的なtrade-offである。介入効果の識別についての定理でもないし、個々のデータセットで必ず損をするという主張でもない。
それでも、この結果は重要な警告になる。一つの「最良モデル」という概念が、異なる科学的目的に対して自動的に最良になるとは限らない。 何を「正しい」とするかが変わると、最適な選び方自体が変わりうる。
Galit Shmueliも2010年に、説明(explanation)と予測(prediction)を区別する必要を体系的に論じた (5)。 説明モデルでは変数と構造の意味が重要になり、予測モデルでは未知データへの汎化性能そのものが評価対象になる。この二つを区別しないと、次の二方向の飛躍が起こる。
- 「よく予測できたので、この変数が原因だ」
- 「この機序モデルはもっともらしいので、未知の患者もよく予測できるはずだ」
Virtual Cell研究の評価指標と比較基準
single-cell perturbation predictionは、この違いを見るよい例である。詳細はVirtual Cellの評価指標を点検した別記事 (6)に書いたので、ここでは本記事の論点に必要な部分だけをまとめる。
先に一点、整理しておく。Perturb-seqのような摂動データは、もともと遺伝子への介入の結果を測ったデータである。したがってここでの課題は、推定対象の区別における一層目と二層目の違い(観察か介入か)ではない。未知の摂動や未知の細胞背景へ汎化できるかと、介入の結果を当てられたとしても、その背後の経路やネットワークを回復したと言えるか(二層目と三層目の違い)の二つである。
2025年、Ahlmann-Eltzeらは、五つのfoundation modelと二つの深層学習モデルを、意図的に単純な基準モデルと比較した。単一・二重の遺伝子摂動後の転写変化の予測で、いずれも基準モデルを上回らなかった (7)。 これは「深層学習は生物学に使えない」という結果ではない。モデルの複雑さや表現力そのものは、対象とする予測課題での価値を証明しない。
Systemaは、摂動細胞と対照細胞の間に、摂動の種類を問わず共通して現れる系統的な差(systematic variation)があり、一般的な指標ではそれを当てるだけで性能が高く見えることを、10データセットで示した (8)。 高い予測スコアは、摂動固有の応答を捉えた証拠とは限らない。
ところが2026年10月1日、Millerらは反対方向の重要な指摘を加えた (9)。 陽性対照となる予測と、摂動情報を使わない基準モデルを用いて、14データセット・18指標を点検すると、MSEや対照との差に基づくPearson相関など一部の一般的な指標は、本当に情報を持つ予測を検出する感度が低かった。感度の良い指標(論文ではwell-calibrated metricsと呼ぶ)では、深層学習モデルが摂動情報を使わない基準モデルを上回る場合が確認された。ここでのcalibrationは予測確率の校正ではなく、指標が良い予測と情報のない予測を区別できるかの点検である。
2025–2026年の文献を並べると、話は単純ではない。
- 複雑なモデルだから良いとは限らない。単純な基準モデルに負けるモデルも多い。
- しかし、評価指標そのものの感度が低ければ、実在する予測情報も見えなくなる。
- そして、介入の結果を予測できることと、正しい機序を回復したことは、さらに別の問題である。
モデル評価は「モデルだけ」の評価ではない。データ分割、baseline、損失、指標まで含めた一つの実験である。2026年のVirtual Cell Challengeが、摂動データのない細胞背景への予測(zero-shot)と、六つの指標の集約で順位を決める形を採ったのも、この問題意識と整合する (10)。 確認日時点で最終結果は未発表であり、本記事は結果を予想しない。
観察予測から介入効果を識別する条件
この節の「識別」は、因果推論の意味である。簡単な例を考える。
\[ U\rightarrow X,\quad U\rightarrow Y,\quad X\rightarrow M\rightarrow Y,\quad X\rightarrow Z \]
\(U\) は測っていない共通の原因(交絡)、\(M\) は媒介変数、\(Z\) は \(X\) の下流にあるが \(Y\) には影響しない代理変数である。観察データの範囲で \(X\) と \(M\) が非常に強く連動しているとする。
予測問題としては、\(Y=f(X)\) でも \(Y=g(Z)\) でも、高い精度で当たるかもしれない。しかし介入の問いでは、答えがそれぞれ違う。
- \(Z\) を操作しても \(Y\) は変わらない。\(g(Z)\) の予測精度は、\(Z\) の効果を何も保証しない。
- \(X\) を操作した効果は、\(U\) を経由する見かけの関連を含む \(P(Y\mid X)\) とは一致しない。\(P(Y\mid do(X))\) を得るには、\(U\) の調整、介入データ、外部の構造知識などの追加条件が必要になる。
- 薬で \(M\) だけを阻害したらどうなるか、という問いには、このデータは答えられない。観察の範囲で \(X\) と独立に \(M\) が動いた例がほとんどなく、答えは実質的な外挿になるからである(正値性がほぼ欠けている)。
なお、交絡がなく、\(X\) を変えても他の関係が変わらない単純な \(X\rightarrow M\rightarrow Y\) であれば、\(P(Y\mid do(X))=P(Y\mid X)\) となり、予測と介入の答えは一致する。両者がずれるのは、例えば交絡、選択バイアス、代理変数、データにない変動への外挿が入るときである。現実のデータでは、それがないことを示す方が難しい。
だから、SHAP値が大きい、attention weightが大きい、feature importanceが高い、という理由だけで機序を決めることはできない。これらはまず、予測器の内部で、その入力がどれだけ使われたかを表す量である。介入効果そのものではない。SHAPの公式ドキュメント自体も、予測モデルの解釈から因果的な示唆を引き出すことへの注意を独立した章で説明している (11)。
機序モデルのパラメータ識別性
ここには反対方向の落とし穴がある。この節と次節の「識別性」は、パラメータの意味である。
例えば、薬物が応答 \(R\)(標的量やバイオマーカー)の消失を速めるturnoverモデルを書いたとする。
\[ \frac{dR}{dt}=k_{\mathrm{in}}-k_{\mathrm{out}}R-k_{\mathrm{drug}}C(t)R, \qquad R(0)=R_0=\frac{k_{\mathrm{in}}}{k_{\mathrm{out}}} \]
これはJuskoらの間接反応モデル(indirect response model)のうち、消失を促進する型に線形の薬効を入れたものである。\(S=k_{\mathrm{drug}}/k_{\mathrm{out}}\) と置くと \(\dfrac{dR}{dt}=k_{\mathrm{in}}-k_{\mathrm{out}}\bigl(1+S\,C(t)\bigr)R\) と書け、\(S\) はこの型の慣用の傾きパラメータにあたる (12, 13)。 この式には、標的の産生と消失(turnover)、薬物曝露、薬物による消失の促進という機序的な解釈がある。
しかし、データから観測できるのが \(R(t)\) だけなら、\(k_{\mathrm{in}}\)、\(k_{\mathrm{out}}\)、\(k_{\mathrm{drug}}\) をそれぞれ十分に識別できるとは限らない。識別性の問題は、少なくとも二種類に分けて考える必要がある。
構造的識別性は、無限に正確なデータがあってもパラメータが一意に決まるかという問題である。例えば濃度 \(C(t)\) を測らず投与量だけが分かっている場合、1-コンパートメントのPKでは \(C(t)=\mathrm{Dose}/V\cdot e^{-k_e t}\) なので、\(R(t)\) には \(k_{\mathrm{drug}}/V\) という比としてしか現れない。分布容積 \(V\) と薬効の強さ \(k_{\mathrm{drug}}\) は、\(R(t)\) だけからは原理的に分けられない。
実用的識別性は、実際の測定時点・個数・誤差のもとで、パラメータが十分に狭く決まるかという問題である。構造的には識別可能でも、測定の設計によっては、異なるパラメータの組合せがほとんど同じ \(R(t)\) を作る。系統生物学のモデルでは、多くのパラメータの組合せに対してモデル出力が鈍感な「sloppy」な構造が広く見られることが報告されている (14)。 プロファイル尤度は、構造的・実用的な非識別性の両方を検出する実用的な方法であり、 (15) 同じ考え方で、パラメータではなく予測値そのものの信頼区間も求められる (16)。
さらに、モデル構造そのものが間違っている可能性もある。よく当てはまるODEを書けたことは、「自然がこのODEで動いている」ことの証明ではない。機序モデルにも、少なくとも次の確認が必要である。
- 構造的識別性
- 実用的識別性
- モデルの誤指定(misspecification)
- 外部データや介入実験による検証
計算例で見る非識別性と予測への影響
方法
非識別性が実際に何を意味するかを、合成データで確かめた。上のturnoverモデルで、真の値を \(k_{\mathrm{out}}=2\)/日、\(S=0.075\) L/mg(\(k_{\mathrm{drug}}=0.15\) L/mg/日)とし、100 mgを1回静注した(1-コンパートメント、\(V=5\) L、\(k_e=0.1\)/日で半減期約6.9日、\(R_0=100\))。投与後1, 2, 4, 7, 14, 21, 28日に \(R\) を測り、対数スケールで標準偏差0.10の測定誤差を加えた(乱数シード20261024)。\(R_0\)、\(C(t)\)、誤差の標準偏差は既知とし、\(k_{\mathrm{out}}\) と \(S\) の尤度を計算した。
\(C(t)\) が既知なので、このモデルは構造的には識別可能である。以下で見るのは、初回の採血を投与1日後に置いた測定設計による、実用的な非識別性である。
区間は、\((k_{\mathrm{out}},S)\) の2次元格子(\(k_{\mathrm{out}}\) は0.1〜1000/日の対数等間隔81点、\(S\) は0.03〜0.15の121点)で尤度を計算し、\(2\Delta\mathrm{NLL}\le3.84\) を満たす格子点(1,619点)での最小値・最大値として求めた。これは各量のプロファイル尤度に基づく95%区間の、格子による近似である。
結果
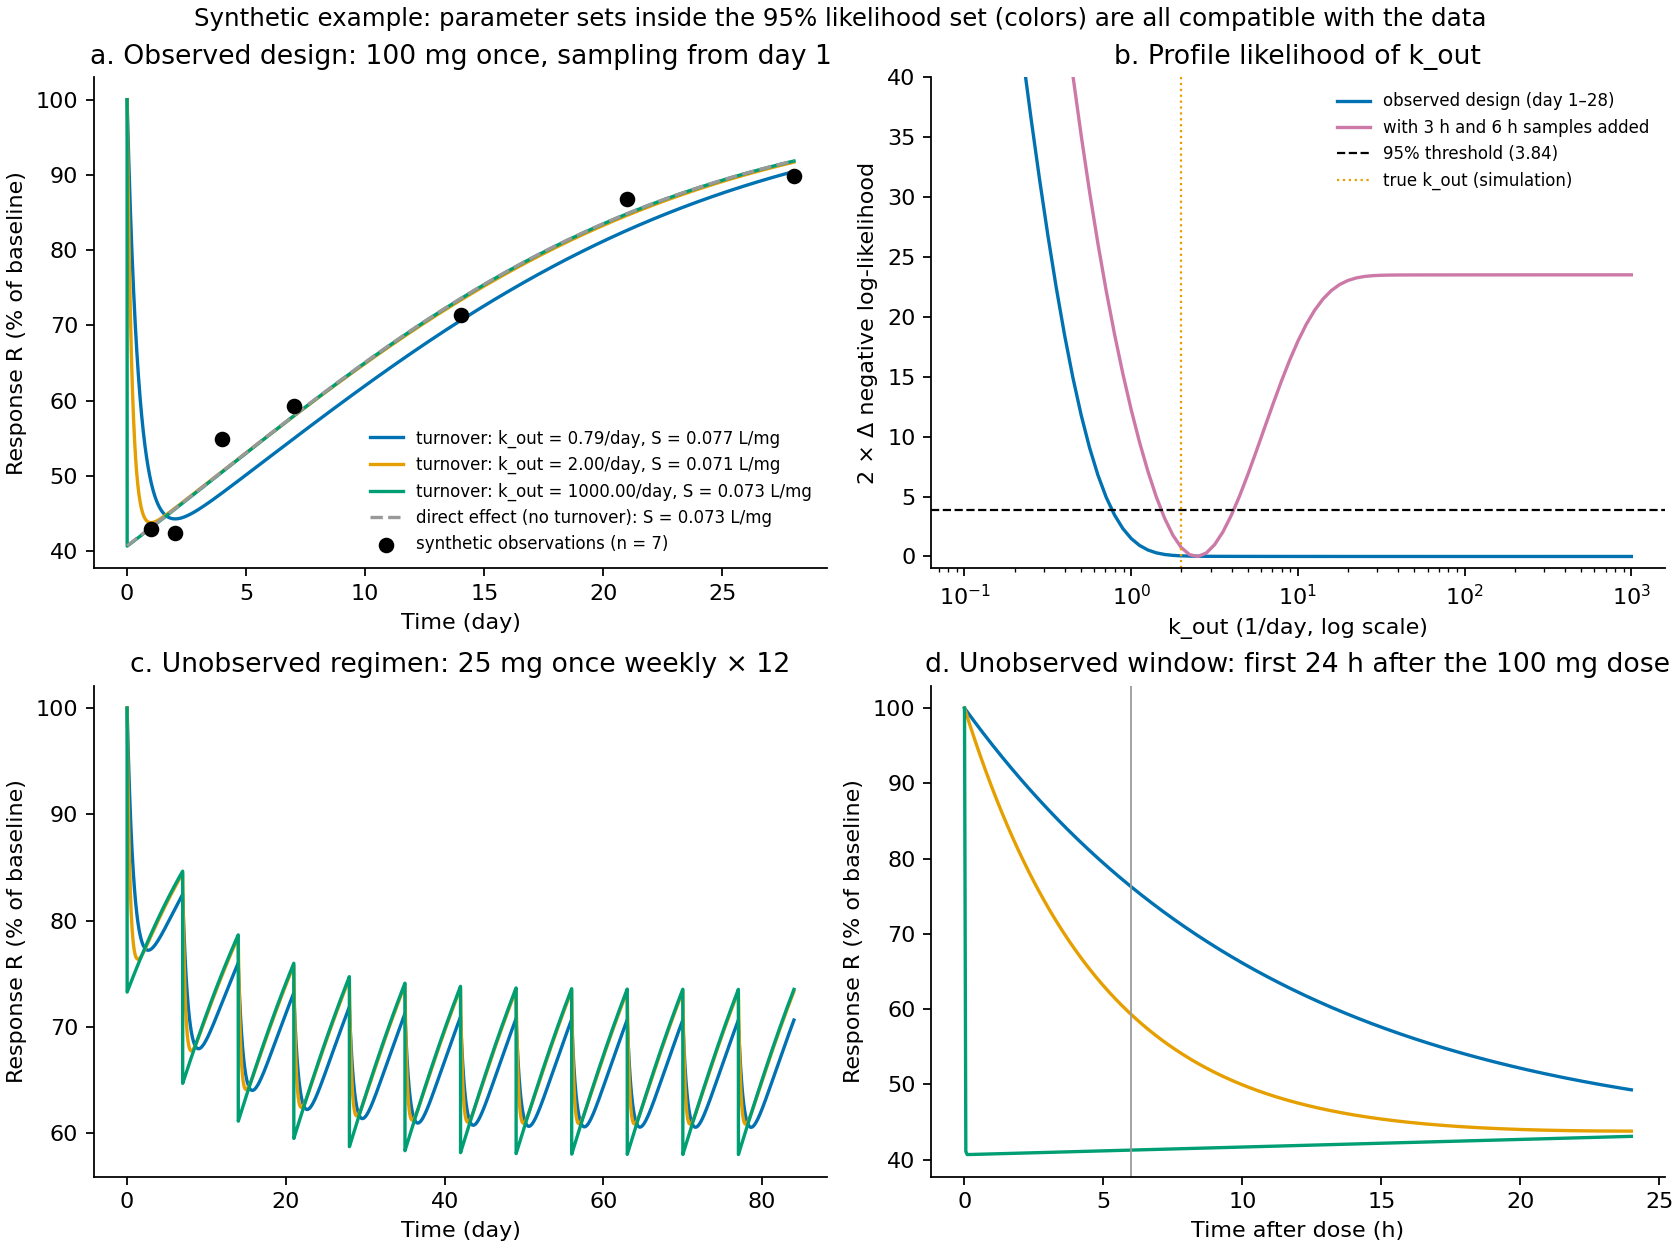
図1. 合成データによる計算例(実データではない)。(a) 観測データと、95%尤度集合に入る3組のパラメータによる当てはめ(3組は \(k_{\mathrm{out}}\) だけでなく \(S\) も少しずつ異なる)。灰色の破線はturnoverを含まない直接効果モデル \(R=R_0/(1+S\,C)\)。(b) \(k_{\mathrm{out}}\) のプロファイル尤度。青は観測設計、紫は投与3・6時間後の採血を加えた設計。破線は自由度1のカイ二乗分布の95%点(3.84)。(c) 観測していない25 mg週1回・12回投与の予測。(d) 100 mg投与後24時間の予測。縦線は6時間。
図1と表1に結果を示す(出力:results/summary.json、results/likelihood_set.csv、results/kout_profile.csv)。
表1 パラメータと予測値の区間
| Quantity | 95% interval, grid approximation | Range holding S=0.073 and varying only kout |
|---|---|---|
| kout (/day) | Lower bound about 0.77; no upper bound | — |
| S (L/mg) | 0.059–0.086; true 0.075 | — |
| R on day 84 with 25 mg weekly | 69.2–77.1 | 71.7–73.5 |
| Minimum R during 25 mg weekly | 54.0–65.2 | 58.0–61.9 |
| R six hours after 100 mg | 37.3–77.3 | 41.2–77.3 |
読み取れることを四つに分けて書く。
第一に、\(k_{\mathrm{out}}\) は下限しか決まらない。 尤度は \(k_{\mathrm{out}}\) を大きくするほどわずかに良くなり、探索した格子内では内部の最小値が得られず、上端1000/日で負の対数尤度が最小だった。ノイズを加えない真の値のデータでも、\(k_{\mathrm{out}}=1000\) での \(2\Delta\mathrm{NLL}\) は0.017にとどまった。上限が決まらないのはこの乱数の偶然ではなく、測定設計の性質である。
第二に、このデータはturnoverがある機序とない機序を区別できない。 turnoverの存在を支持も否定もしていない。turnoverを含まない直接効果モデル \(R=R_0/(1+S\,C)\) の最良の負の対数尤度(0.72033)は、turnoverモデルの最良値(0.72034)と同じだった。直接効果モデルは \(k_{\mathrm{out}}\to\infty\) の極限にあたる。濃度の変化が標的のturnoverより十分に遅いと、\(R\) はほぼ準定常状態 \(R\approx R_0/(1+S\,C)\) に従い、データには主に \(S\) だけが現れるためである。間接反応モデルでこうした時間スケールの分離が起こりうることは、古くから知られている (12, 13)。
第三に、非識別性が問題になるかどうかは、問いによって変わる。 観測していない25 mg週1回投与(図1c)の予測幅は、主に \(S\) の不確実性から来ていた。\(S\) を固定して \(k_{\mathrm{out}}\) だけを尤度集合内の範囲(約0.8〜1000/日)で動かしても、84日目の \(R\) は約2、最小値は約4しか変わらなかった。一方、測定していない投与直後の数時間(図1d)では、\(k_{\mathrm{out}}\) だけで6時間後の \(R\) が約41から約77まで変わった。前者で答えがそろうのは、週1回投与でも、各投与直後の数時間を除けば濃度の変化がturnoverより遅く、準定常近似が成り立つ範囲にとどまるからである。最小値に残る約4の差は、この投与直後の過渡応答から来ている。半減期の短い薬剤や、濃度が数時間で大きく変わる投与では、この条件は崩れる。
第四に、この計算例では追加採血で区間が狭くなった。 推定できた下限 \(k_{\mathrm{out}}\approx0.77\)/日からは、応答の時間スケールは長くても1日程度と見込める。薬物がないときの標的の半減期(\(\ln 2/k_{\mathrm{out}}\))は真の値で約8時間、投与直後は消失が速まって約3時間になる。この時間帯に当たる投与3時間後と6時間後の2点を加えると、\(k_{\mathrm{out}}\) の95%区間は約1.5〜4.1/日に収まった(図1bの紫。一つの乱数系列での結果である)。どの問いに答えたいかが決まれば、どの時点を測るべきかも決まる。
逆に言えば、「\(k_{\mathrm{out}}\) が推定できなかったので、このモデルは役に立たない」とも言えない。曝露の変化が遅い投与レジメンの比較という問いには、\(S\) の精度の範囲で答えられる。必要なのは、問いが依存するパラメータの組合せを、データが決めているかを確認することである。
ただし、この計算例はモデルの構造が正しく、投与レジメンを変えてもその構造とパラメータが変わらないと仮定している。これは因果効果の識別の仮定に相当し、計算例では正しいと決めてある。実際には、この仮定自体を介入データで検証する必要がある。また、この例が示すのは一つの仕組みであり、実在の薬剤や標的について何かを示すものではない。
数値実装の確認と限界
ODEは \(R\) について線形なので、0.002日刻みで、各区間の消失速度を中点の値に固定し、その区間を解析的に解く方法(指数積分)で順に計算した。照合用コードで独立なODEソルバー(Radau、許容誤差 \(10^{-10}\))と25 mg週1回投与で比較した差は、\(k_{\mathrm{out}}=2\)/日で \(10^{-5}\) 未満、格子上端の \(k_{\mathrm{out}}=1000\)/日で約0.001(\(R\) の単位)だった。
測定誤差の標準偏差、\(R_0\)、濃度推移は既知とした。個体間変動、PKパラメータの不確実性、モデルの誤指定は含めていない。区間は格子による近似で、端点は格子の解像度(\(S\) は0.001刻み)に依存する。\(k_{\mathrm{out}}\) の下限は格子点の間を対数スケールで線形補間した値である。カイ二乗近似による95%の閾値は、パラメータが境界へ流れる場合には近似にとどまる。
考察
例えば、次の測定時点の腫瘍径を当てたいなら、予測性能が第一になる。単純なlast-observationのモデルが複雑なtumor-growthモデルよりよく当たるなら、その目的には前者を使えばよい。
一方、「投与間隔を延ばしても薬効が維持されるのはなぜか」を知りたいなら状況が変わる。AUC、\(C_{\max}\)、\(C_{\min}\)、標的のturnover、受容体占有のどれが反応を支配しているかを区別できなければ、観察されていないレジメンへの外挿は危うい。既存の用量範囲の中で当てることと、
\[ \text{未観測の用量}\rightarrow\text{未観測の曝露プロファイル}\rightarrow\text{反応} \]
を外挿することでは、必要な仮定が違う。合成計算例でも、曝露の変化がturnoverより遅い時間帯では予測がそろい、投与直後の時間帯では割れた。機序モデルの価値が大きくなるのは、単にfitが良いからではない。介入を変えたときに、何を保存し、何を変えるべきかを明示できるからである。
規制の枠組みも、モデルの種類ではなく、問いと判断への影響から評価を組み立てている。ICH M15(MIDDの一般原則)は2026年1月29日にStep 4で採択された。question of interest(何を判断したいか)とcontext of use(モデルがその判断でどんな役割と範囲を担うか)を定め、モデルが判断に与える影響の大きさと、誤った判断の帰結からモデルリスクを評価して、必要な検証の程度を決める枠組みである。対象となる手法の例として、PopPK、PBPK、曝露–反応、QSP、疾患進行モデルに加え、AI/MLも挙げられている (17)。 FDAは2026年6月に、これを最終ガイダンスとして発出した (18)。
AIについては、FDAが2025年1月に、context of useごとに信頼性を評価する7段階のリスクベースの枠組みをドラフトガイダンスとして示した(確認日時点でドラフト) (19)。 2026年1月には、FDAとEMAが創薬・開発の全段階を対象とする10の原則を共同で公表している (20)。 FDA–EMAの原則は初期研究も含む高水準の原則で、具体的な評価手順は定めていない。一方、FDAのドラフトガイダンスは創薬段階での利用を対象外としている。その信頼性評価の枠組みをVirtual Cellのような研究用途に当てはめるのは、本記事の類推である。
この枠組みの言葉で言えば、本記事の主張は次のようになる。同じモデルでも、question of interestと、モデルがその判断で担う役割が違えば、必要な証拠は変わる。 観察条件での予測に使うモデルと、未観測の介入や機序の主張に使うモデルでは、モデルリスクも、求められる検証の種類も違う。
予測性能と機序の証拠
予測性能は利用する集団や条件に対して定義される。判別能が同じでも校正は異なり、既知条件の誤差が小さくても未知の介入への外挿は外れうる。
機序の証拠には、パラメータの識別性、固定した係数による別条件の予測、媒介変数の観測との対応など、適合度と異なる情報が含まれる。したがって、
\[ \text{モデルの品質}\neq\text{一つのスカラー値} \]
となる。今回の計算例も、一つの当てはまりの良さから、予測の安定性と機序の特定を同時には判定できないことを示した。
結論
Yangの結果は限定された統計問題についての定理だが、モデルの同定と回帰関数の推定を一つの目的にできない場合が数学的に存在することを示す。single-cell perturbation predictionでも、比較対象や評価指標によって「何が予測できたか」の結論が変わる。
本記事の計算例では、turnoverの有無が異なるモデルが同じように当てはまった。95%尤度集合内の係数は、週1回投与については近い予測を出す一方、投与直後の応答では大きく分かれた。したがって、良い適合度だけから、短時間の応答やその機序まで特定したとは言えない。
データとコードの公開状況
再実行資料ZIPを展開し、Python 3.11以上で、展開先のフォルダから以下を実行する。確認したNumPy・SciPy・Matplotlibの版はrequirements.txtに固定した。実行時間は環境によって約2〜4分である。
python -m pip install -r requirements.txt
python identifiability_demo.py
計算コードは、results/likelihood_set.csv、results/kout_profile.csv、results/summary.json、図1を生成する。
参照
- Hernán MA, Hsu J, Healy B. A Second Chance to Get Causal Inference Right: A Classification of Data Science Tasks. CHANCE. 2019;32(1):42–49. doi:10.1080/09332480.2019.1579578.
- van Geloven N, Swanson SA, Ramspek CL, Luijken K, van Diepen M, Morris TP, et al. Prediction meets causal inference: the role of treatment in clinical prediction models. European Journal of Epidemiology. 2020;35(7):619–630. doi:10.1007/s10654-020-00636-1.
- Dickerman BA, Hernán MA. Counterfactual prediction is not only for causal inference. European Journal of Epidemiology. 2020;35(7):615–617. doi:10.1007/s10654-020-00659-8.
- Yang Y. Can the strengths of AIC and BIC be shared? A conflict between model identification and regression estimation. Biometrika. 2005;92(4):937–950. doi:10.1093/biomet/92.4.937.
- Shmueli G. To Explain or to Predict?. Statistical Science. 2010;25(3):289–310. doi:10.1214/10-STS330.
- Kumakura D. What did the Virtual Cell predict? Target genes and evaluation shortcuts [Internet; technical note]. 2026 Oct 11. English article.
- Ahlmann-Eltze C, Huber W, Anders S. Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselines. Nature Methods. 2025;22(8):1657–1661. doi:10.1038/s41592-025-02772-6.
- Viñas Torné R, Wiatrak M, Piran Z, Fan S, Jiang L, Teichmann SA, et al. Systema: a framework for evaluating genetic perturbation response prediction beyond systematic variation. Nature Biotechnology. 2026;44(6):1050–1059. doi:10.1038/s41587-025-02777-8.
- Miller HE, Mejia GM, Leblanc FJA, Swain B, Wang B, de Lima Camillo LP. Deep learning perturbation models can outperform baselines on calibrated metrics. Nature Biotechnology. 2026 [published online 2026 Oct 1]. doi:10.1038/s41587-026-03307-w.
- Arc Institute. The 2026 Virtual Cell Challenge: predicting perturbation responses in cell contexts a model has never seen [Internet]. 2026 Aug 20 [cited 2026 Oct 6]. Announcement. The published schedule lists final test-set release on Oct 22 and final submissions on Nov 5.
- SHAP documentation. Be careful when interpreting predictive models in search of causal insights [Internet; cited 2026 Oct 6]. Official documentation.
- Dayneka NL, Garg V, Jusko WJ. Comparison of four basic models of indirect pharmacodynamic responses. Journal of Pharmacokinetics and Biopharmaceutics. 1993;21(4):457–478. doi:10.1007/BF01061691.
- Sharma A, Jusko WJ. Characteristics of indirect pharmacodynamic models and applications to clinical drug responses. British Journal of Clinical Pharmacology. 1998;45(3):229–239. doi:10.1046/j.1365-2125.1998.00676.x.
- Gutenkunst RN, Waterfall JJ, Casey FP, Brown KS, Myers CR, Sethna JP. Universally Sloppy Parameter Sensitivities in Systems Biology Models. PLoS Computational Biology. 2007;3(10):e189. doi:10.1371/journal.pcbi.0030189.
- Raue A, Kreutz C, Maiwald T, Bachmann J, Schilling M, Klingmüller U, et al. Structural and practical identifiability analysis of partially observed dynamical models by exploiting the profile likelihood. Bioinformatics. 2009;25(15):1923–1929. doi:10.1093/bioinformatics/btp358.
- Kreutz C, Raue A, Timmer J. Likelihood based observability analysis and confidence intervals for predictions of dynamic models. BMC Systems Biology. 2012;6(1):120. doi:10.1186/1752-0509-6-120.
- International Council for Harmonisation. General principles for model-informed drug development: M15 [Guideline; Step 4]. 2026 Jan 29. Final guideline.
- US Food and Drug Administration. M15 General Principles for Model-Informed Drug Development [Internet; final guidance]. 2026 Jun. Official guidance.
- US Food and Drug Administration. Considerations for the Use of Artificial Intelligence To Support Regulatory Decision-Making for Drug and Biological Products [Internet; draft guidance]. 2025 Jan. Official draft guidance.
- European Medicines Agency; US Food and Drug Administration. Guiding principles of good AI practice in drug development [Internet]. 2026 Jan. Joint principles. EMA announcement.