Virtual Cellは何を当てたのか。標的遺伝子と評価指標を点検する
On this page
要旨
CRISPRiの標的発現低下を当てることと、他の遺伝子の応答を予測することは区別する必要がある。文献と公開評価仕様を比較し、正解の摂動と他の摂動で標的遺伝子の扱いが異なる照合指標を検討した。3摂動・5遺伝子の合成例では、下流応答を予測しない出力もrow-maskで1.00を得たが、panel-maskとpairwise-maskでは0.50だった。この例は評価の近道を示すものであり、実モデルの順位やpairwise法の優越性を示すものではない。
文献確認日:2026年10月6日。文献の報告と、本記事で作成した合成データの計算例を区別する。
背景と目的
遺伝子を抑えた後の細胞を予測するモデルが、その遺伝子の発現低下を当てた。それだけで、細胞の応答を理解したと言えるだろうか。
Eric Kernfeldの2025年12月のブログ記事 (1) は、この素朴な疑問から、細胞への介入後の応答を計算上で予測するVirtual Cellの評価を問い直している。本記事はその問題提起を出発点に、最近の摂動予測研究と評価仕様を読み、どこまで結論を支持できるかを整理する。検討の中心は、CRISPRiの転写応答と、平均応答を候補へ照合する評価である。Virtual Cell全体の評価ではない。
細胞表現の学習と介入後の予測
Perturb-seqは、遺伝子への介入とsingle-cell RNA-seqを組み合わせ、介入後の転写状態を測定する。実験していない標的や細胞背景へ予測を広げられれば、次に行う実験の選択に使える。その期待が、Virtual Cellという言葉の魅力の一つになっている。
ここで、単一細胞基盤モデル(single-cell foundation model、scFM)は、大量の細胞データで事前学習し、その表現を複数の解析に利用するモデルを指す。Geneformerは転写データからの転移学習、scFoundationは大規模な事前学習と複数の応用課題を報告した。しかし、細胞状態の表現が良いことと、未知の介入後の発現量を正しく予測できることは、別の検証問題である (2, 3)。
評価の前に、何を未知にするかを決める必要がある。
表1 未知条件の分け方
| Intended prediction | Held out in testing | Not established by that result alone |
|---|---|---|
| A new target in the same cellular background | Perturbation target | Transfer to a new cell type |
| A known perturbation in another background | Cell type, line, donor or other context | Prediction for an unseen target |
| Combinations from single perturbations | Perturbation combination | Prediction of unseen single perturbations |
| Transfer of responses from another experiment | Dataset or experimental conditions | Prediction without any observed perturbation responses |
これは本記事での整理であり、論文ごとの分割方法はさらに確認する必要がある。Weiらの広範なベンチマークも、未知の摂動と未知の細胞背景を区別している。論文は2025年12月にオンライン公開され、2026年の巻に掲載された (4)。
細胞をランダムに分け、同じ標的・同じ実験の細胞が学習と評価の両側にある設定を、未知標的への汎化と呼ぶことはできない。また、事前学習に評価対象の実験が入っていないかも、可能な範囲で監査したい。これは標的遺伝子のマスクとは別の問題である。
標的の発現低下が示す予測能力
CRISPRiでは、標的遺伝子の転写を抑えるように実験を設計する。その直接効果が強いと、発現変化の大きい遺伝子に重みを置く評価は、標的を下げるだけの予測を高く評価しうる。
Csendesらは、scGPTとscFoundationを単純な基準モデルと比較し、Top-20 DE(差次的発現の検定で選ばれた上位20遺伝子)の評価からCRISPR標的を除く解析も実施した。標的を含むTop-20の評価ではscGPTがTrain Mean(学習摂動の平均応答を、すべてのテスト摂動へ共通に使う予測)を上回る一方、その評価には標的自身の変化が混ざる。ここで問われるのは、得点の改善がどの遺伝子の予測に由来するかである (5)。
Wongらも、深層学習との比較に適切な単純な基準モデルを置く重要性と、既存ベンチマーク用データの修正を報告した。本記事では、その原著の要旨で確認できる範囲を参照する (6)。
ただし、標的の応答を「生物学ではない」と全面的に切り捨てるのも強すぎる。ノックダウン効率、残存発現、ガイド差が予測目的なら、それ自体が研究対象になる。私が分離したいのは、介入の効き具合を予測する課題と、その条件下で起こる応答を予測する課題である。
CRISPR knockoutについても、機能喪失とmRNAの消失は同じではない。mRNAが残る場合に、その測定値を一律にゼロとすることは、目的に応じたモデル上の仮定であり、観測事実ではない。PEREGGRNの論文も、knockoutではmRNAが残ったり増加したりする可能性を記載している (7)。
評価時の情報漏洩はどこで起きるか
議論を明確にするため、介入ラベルを \(I\)、介入後の標的発現を \(Z\)、それ以外の発現を \(X\)、細胞背景を \(c\) とする。
介入ラベルから応答全体を予測するなら、対象は例えば
\[ p(Z,X\mid I,c) \]
である。一方、標的をどの程度抑えたかが既知で、その先の応答を予測したいなら、
\[ p(X\mid Z,I,c) \]
を評価する。後者は前者より多くの情報を条件として与えている。
PEREGGRNでは、closest-controlを使う設定で、標的の値を介入後の発現量へ置き換えて予測する。これは、標的の変化を条件として扱う設定の例である。ただし、未知の実験を事前に予測する用途で、その介入後の実測値が入手できるとは限らない (7)。
表2 区別すべき評価上の問題
| Problem | Consequence | What to inspect |
|---|---|---|
| Target direct effect dominates the score | High scores despite wrong downstream responses | Report scores with and without the target |
| Input availability mismatches intended use | An unknown measurement is supplied at prediction time | State what is assumed available beforehand |
| Training/evaluation contamination | The same experiment appears on both sides | Audit split units and pretraining data |
| Asymmetric target handling in retrieval | Only incorrect candidates retain their targets' direct effects | Inspect targets excluded from distances |
標的名をモデルに与えること自体は、通常の摂動予測では情報漏洩ではない。 どの遺伝子に介入したかは正当な入力である。「target-gene leakage」という表現を使う場合も、入力の漏洩なのか、評価の近道なのかを説明したい。
自分の標的だけを除く照合の近道
照合型の評価(retrieval)では、予測に近い観測結果が同じ摂動から得られたものかを順位で判定する。摂動 \(i\) の予測 \(\hat x_i\) を、正解 \(x_i\) と他の摂動の観測 \(x_j\) に照合し、正解の方が近ければ高得点になる。
問題のあるrow-mask(予測ごとに、その標的だけを除く方法)では、予測対象の摂動の標的 \(i\) だけを、すべての比較から除く。一つの予測を評価する際には、すべての候補で同じ遺伝子を使うが、正解の標的と競合候補の標的を対等に扱っていない。
\[ d_{-i}(\hat x_i,x_i),\qquad d_{-i}(\hat x_i,x_j). \]
候補 \(j\) には、その標的 \(j\) の強い低下が残る。予測側で、他の標的を逆方向に大きくしておけば、不正解候補との距離を押し上げられる。
Arcの公開仕様には、この近道を使った予測の pds_cosine が、3つの検証条件で0.798、0.757、0.761となったと記載されている。対応する基準値は0.530、0.528、0.510だった。これはArcの報告値であり、本記事で実データから再計算した値ではない (8)。
2026年8月19日付の競技仕様では、pds_cosine は評価対象のパネルに含まれる標的遺伝子を、どの比較でもすべて除く。候補ごとに残る座標が変わらない方法である。なお、競技の6指標すべてが全標的を除くわけではない。他の5指標では、その摂動自身の標的を除く (9)。
この資料の日付を、実際の運用変更日と同一視することは避ける。また、正規化前のPDSの0.5という基準と、基準モデルと反復測定に照らして正規化した競技得点の0という基準は別である。
合成例による検証
どのような予測がこの採点規則で高得点になるか、合成例で調べた。遺伝子A・B・Cをそれぞれ抑える3摂動と、下流遺伝子D・Eを用意する。以下はcontrol(非標的対照)との差を表す合成値であり、実験データではない。
表3 合成データの介入効果
| Perturbation | A | B | C | D | E |
|---|---|---|---|---|---|
| Suppress A | −5 | 0 | 0 | 1 | 0 |
| Suppress B | 0 | −5 | 0 | 0 | 1 |
| Suppress C | 0 | 0 | −5 | −1 | −1 |
評価の近道だけを使う予測は、D・Eを常にゼロとし、自分以外の標的を+10にする。例えばA摂動の予測は \((0,10,10,0,0)\) となる。下流応答の情報を使っていない。
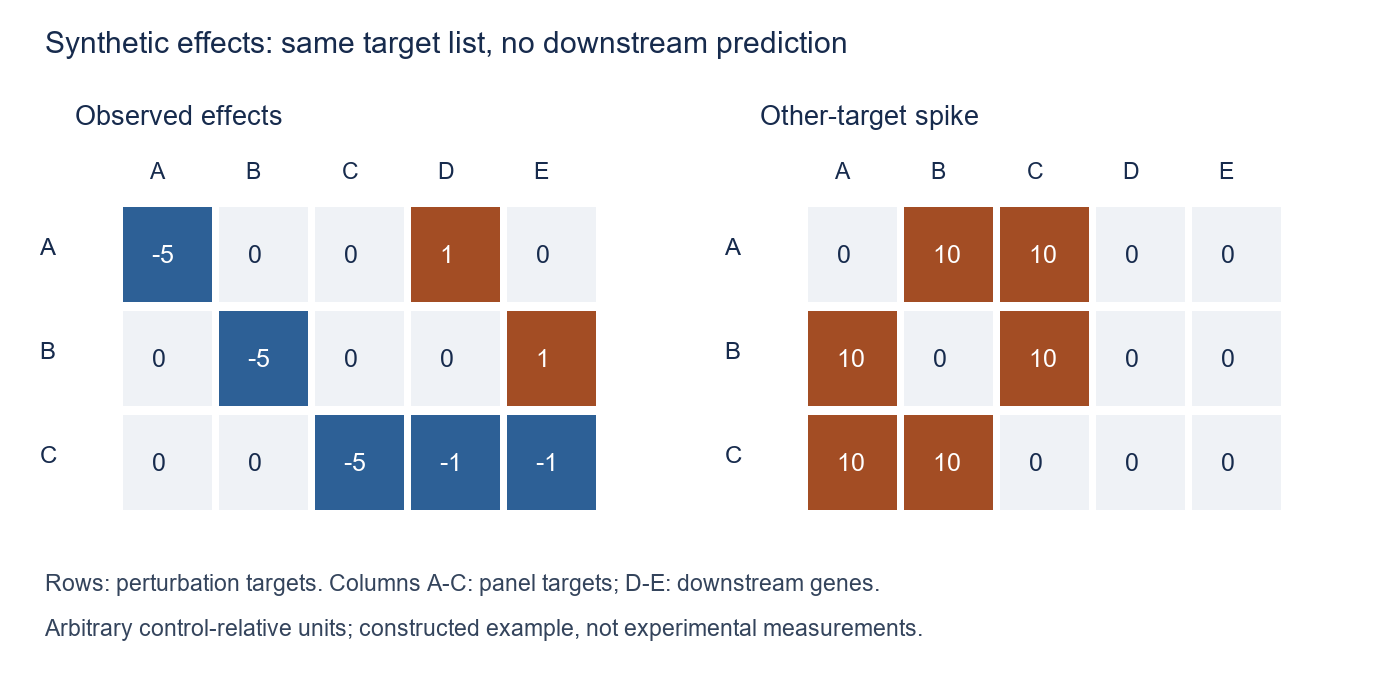
図1:本記事で作成した合成例。青は負、茶は正、灰はゼロ。色は符号だけを表し、大きさは各セルの数値で示す。自分以外のpanel標的だけを増加させた予測であり、D・Eの下流応答は予測していない。数値の単位は任意。
計算結果
コサイン距離を使うと、Aを除いた正解との内積はゼロで、距離は1になる。しかしB摂動との内積には \(10\times(-5)\) が入り、距離は1より大きくなる。Cとの比較も同様である。正解を当てたように見えるが、起きているのは不正解候補を遠ざける操作である。
比較したのは、row-mask、panel-mask(panelの全標的を一括除外)、次節のpairwise-mask(二者比較ごとに両標的を除外)である。同点は0.5点、ゼロベクトルのコサイン距離は1と定義した。計算上は距離の差が \(10^{-12}\) 以下の場合を同点として扱った。rowとpanelでは、正解と各候補の勝敗を平均することが、同点補正した正規化順位に対応する。旧実装の同点処理や前処理を完全再現する実験ではない。
表4 マスク方法による得点の違い
| Prediction | Row mask | Panel mask | Pairwise mask |
|---|---|---|---|
| Control unchanged: all effects zero | 0.50 | 0.50 | 0.50 |
| Raise other targets by +10 | 1.00 | 0.50 | 0.50 |
| Oracle providing only correct D and E | 1.00 | 1.00 | 1.00 |
| Oracle providing every correct gene | 1.00 | 1.00 | 1.00 |
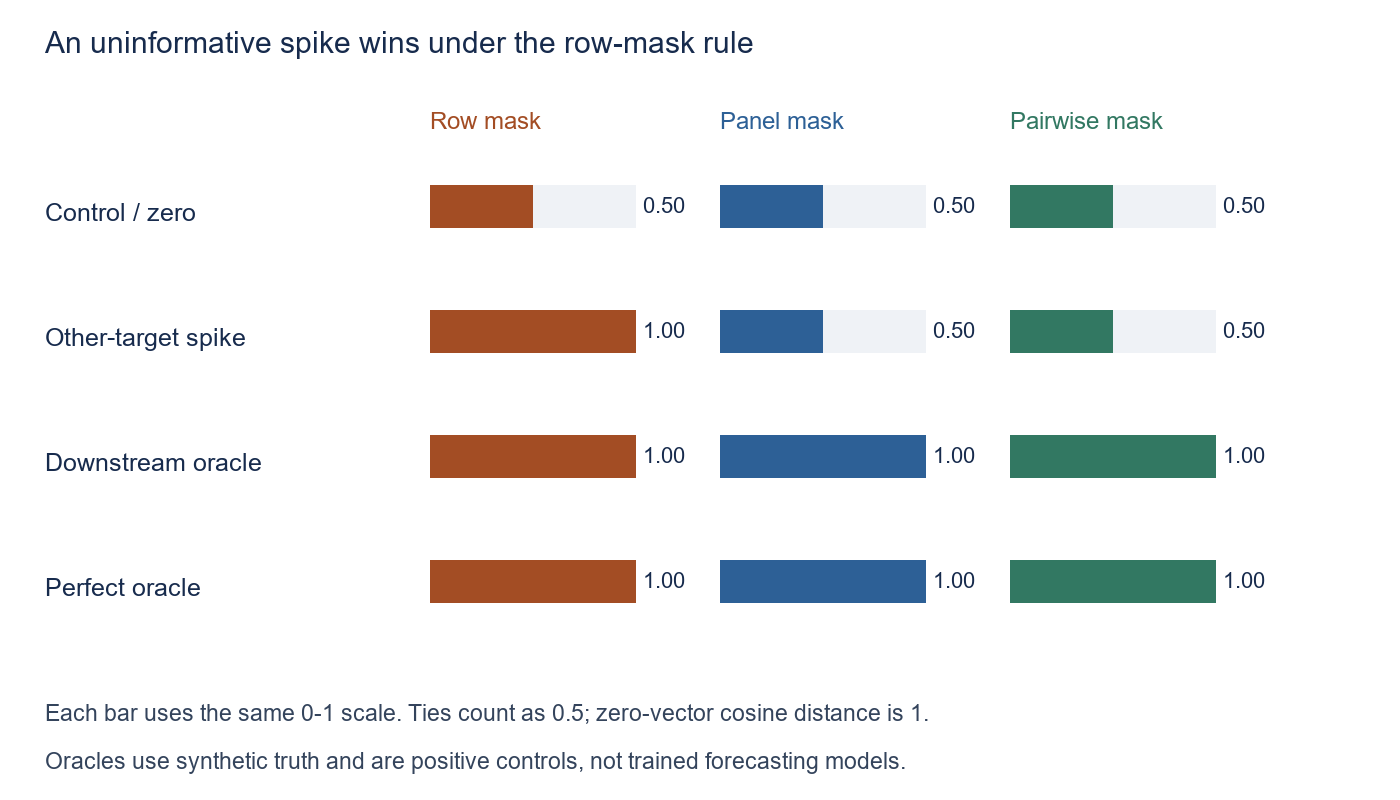
図2:合成データでの計算結果。得点は3摂動の平均。oracleは正解を使う陽性対照であり、学習した予測モデルではない。すべての棒は0〜1の同一尺度。
この例が示すのは、下流応答を予測しない出力が、特定の評価規則で満点になりうることである。実際のモデルの順位、実データでの効果量、pairwise法の優越性は示していない。計算コードと結果CSVを公開し、入力・依存ライブラリ・図を含む再実行資料ZIPも用意した。
全標的除去と二者比較での除去
panel-maskには、同じ固定座標を使える利点がある。一方、Aを抑えたときにBが変わるという応答も、Bが別の摂動の標的なら評価から消える。これは、本来測りたい情報を減らす可能性がある。
Kernfeldの記事の付録は、正解 \(i\) と候補 \(j\) の二者比較ごとに、両方の標的を除く案を提示する。以下では、原案に同点の扱いを明示的に加える。
\[ S_i=\frac{1}{N-1}\sum_{j\ne i} \left[ \mathbf 1\{a_{ij}<b_{ij}\} +\frac12\mathbf 1\{a_{ij}=b_{ij}\} \right], \]
\[ a_{ij}=d_{-(i,j)}(\hat x_i,x_i),\qquad b_{ij}=d_{-(i,j)}(\hat x_i,x_j). \]
この式と以下の解釈は、Kernfeldの原案を基にした本記事の整理である (1)。各二者比較では同じ遺伝子を使い、最後に勝率を平均する。候補ごとに違う座標で求めた距離を、そのまま一列に並べて順位付けする方法とは異なる。
AUCに似た勝率と考えると理解しやすいが、通常のROC-AUCや、一つの固定距離から作る順位と同じものではない。比較ごとに座標が変わるため、全候補に共通する距離順序があるとも限らない。
この方法では、比較に無関係な第三の標的を残せる。ただし、それが常に有利とは言えない。残る標的の直接効果、遺伝子間の依存、複数標的の摂動、弱い応答、マスクによるベクトルのノルムの変化がコサイン距離に及ぼす影響を含めた検証が必要である。この合成例で点数が上がらなくなったことだけでは、どのマスク方法が適切かは決まらない。
最近の論文が支持する範囲
2025年のAhlmann-Eltzeらは、検討した遺伝子摂動予測で深層学習が単純な線形モデルを上回らないと報告した。Systemaは、多くの摂動に共通する系統的変動と、摂動固有の応答を区別して評価する必要を示した。これらは、単純な基準モデルを省略できない理由になる (10, 11)。
一方、2026年10月のMillerらは、14データセット・18指標を用い、陽性対照と陰性対照を区別できるかという意味で指標を点検した。感度の良い指標では、複数の深層学習モデルが基準モデルを上回った。これは予測確率の校正ではなく、評価指標が有用な予測を識別する能力の点検である。論文も、未知の細胞背景への予測は扱っていないと述べる (12)。
この二つの見方は、単純に片方が他方を否定する関係ではない。全遺伝子の平均誤差は弱い応答を埋もれさせることがあり、変化の強い遺伝子だけの指標は標的の直接効果を強調することがある。何を検出したい指標なのか、陽性対照を識別できるか、近道でも高得点になるかを、それぞれ調べる必要がある。
最近のモデルも、同じ課題を解いているわけではない。
表5 近年の研究と評価対象
| Study or model | Principal reported capability | Relation to this article's concern |
|---|---|---|
| UCE, Nature 2026 | Shared representations across diverse cells | Embeddings alone do not validate unseen-intervention prediction |
| State, Cell 2026 | Context transfer with cellular heterogeneity | Population responses need evaluation beyond means |
| Stack, 2026 preprint | In-context learning with inference-time cellular prompts | Specify which conditions have already been observed as prompts |
| PIE, October 2026 preprint | Population-level perturbation effects informed by biological knowledge | Separate unseen target, unseen context and both unseen |
| Miller et al., Nature Biotechnology 2026 | Metric sensitivity and comparisons on unseen targets or combinations | Interpret scores together with metric properties |
能力の概要は、UCE・State・Stackの各原著とMillerらの報告に基づく (13, 14, 15, 12)。表の「Relation to this article's concern」(今回の問題との関係)の列は本記事の解釈である。Stackは、この調査ではプレプリントとして扱う。
PIEは2026年10月5日に公開された新しい例である。公開READMEと発表資料では、知識源、予測先の細胞背景で測った対照データ、学習データ内の摂動応答を利用すると説明されている。未知条件を予測するという主張も、何も観測せずに予測するという意味ではない。本記事では公開資料で確認できる設計の紹介に留め、詳細な性能値や独立検証を済ませたという主張は採用しない (16)。
データ側では、2026年9月のTahoe-100Mが、50のがん細胞株・1,100の薬剤・用量の組み合わせを含む大規模な薬剤摂動アトラスを報告した。ただし、薬剤によるタンパク質の阻害と、CRISPRiによる標的mRNAの抑制は同じ介入ではない。本記事の標的マスクを、薬剤摂動へそのまま適用する根拠にはならない (17)。
さらに、Nicolらの2026年プレプリントは、予測側と観測側から同じ対照群の発現推定値を引くと、共有される推定誤差で相関が膨らむ問題を報告した (18)。
直感を得るため、互いに独立な推定誤差 \(\epsilon_p,\epsilon_t,\epsilon_c\) を仮定する。本記事での代数的な説明では、
\[ \operatorname{Cov}(\epsilon_p-\epsilon_c,\epsilon_t-\epsilon_c) =\operatorname{Var}(\epsilon_c) \]
となる。独立な予測誤差と観測誤差にも、同じ対照群の推定値を引くことで共通成分が入る。この式は一般の細胞データで常に独立性が成立するという主張ではない。標的を除くことだけでは、こうした別の評価上の問題は解決しない。
同じ指標名でも評価条件は一致しない
標的マスク、遺伝子集合、前処理、同点処理が異なれば、同じ指標名でも数値の意味が変わる。今回の人工例でも、標的だけの予測や全摂動に共通する予測が、採点方法によって異なる得点を得た。
SchäferらのscPertEvalプレプリントは、評価をデータの表現、評価指標、スコアの変換、結果の集計・報告方法へ分解している。この区別で読むと、前処理や正規化まで異なる成績を指標名だけで比較できないことが分かる (19)。
本記事のpanel-maskとpairwise-maskの比較は、数式と人工例の範囲に限られる。実測での予測性能や細胞集団の分布を検証したわけではなく、得点の差だけを下流応答の機序理解へ置き換えることはできない。
結論
Kernfeldの問いは、標的を下げることを当てた得点を、下流の応答を理解した証拠として読んでよいか、という問いだった。Arcの公開仕様は、retrievalでの標的の扱いの非対称性が実際に得点の近道になることも示している。
本記事の合成例でも、その仕組みを再現できた。しかし、そこから「scFMは役に立たない」「pairwise-maskで評価問題は解決した」とは言えない。
評価の解釈を決めるのは、予測前に何を知っていて、何を未知にし、どの応答を、どの対照より良く予測したのかである。その条件を明示すれば、Virtual Cellの進歩と限界を、同じ土台で議論できる。
データとコードの公開状況
再実行資料ZIPを展開し、Python 3.11以上で、展開先のフォルダから以下を実行する。NumPyとPillowの確認済みの版は同梱したrequirements.txtに固定した。フォントが環境によって異なる場合、図の文字の見た目は変わるが計算値は変わらない。
python -m pip install -r requirements.txt
python toy_metrics.py
toy-results.csv、toy-data.json、図1・2を生成する。3摂動・5遺伝子の人工的な平均効果を直接与えており、実データの取得、scFMの学習、単一細胞レベルの分布の再現、Arc競技パイプラインの再実行は行っていない。
陽性対照2種類と、共通予測100種類の基準得点を検査した。pairwise法については、この計算例と数式上の性質の確認までであり、実データでの比較検証は実施していない。
参照
- Kernfeld E. We predict that the transcript abundance from the gene we are knocking down will (checks notes) decrease [Internet; blog]. 2025 Dec 5. Original post.
- Theodoris CV, Xiao L, Chopra A, Chaffin MD, Al Sayed ZR, Hill MC, et al. Transfer learning enables predictions in network biology. Nature. 2023;618(7965):616–624. doi:10.1038/s41586-023-06139-9.
- Hao M, Gong J, Zeng X, Liu C, Guo Y, Cheng X, et al. Large-scale foundation model on single-cell transcriptomics. Nature Methods. 2024;21(8):1481–1491. doi:10.1038/s41592-024-02305-7.
- Wei Z, Wang Y, Gao Y, Wang S, Li P, Si D, et al. Benchmarking algorithms for generalizable single-cell perturbation response prediction. Nature Methods. 2026;23(2):451–464. doi:10.1038/s41592-025-02980-0.
- Csendes G, Sanz G, Szalay KZ, Szalai B. Benchmarking foundation cell models for post-perturbation RNA-seq prediction. BMC Genomics. 2025;26:393. doi:10.1186/s12864-025-11600-2.
- Wong DR, Hill AS, Moccia R. Simple controls exceed best deep learning algorithms and reveal foundation model effectiveness for predicting genetic perturbations. Bioinformatics. 2025;41(6):btaf317. doi:10.1093/bioinformatics/btaf317. Only the abstract was consulted for the scientific claims discussed here.
- Kernfeld E, Yang Y, Weinstock JS, Battle A, Cahan P. A comparison of computational methods for expression forecasting. Genome Biology. 2025;26(1):388. doi:10.1186/s13059-025-03840-y.
- Arc Institute. cell-eval2 metrics reference [Internet; software documentation]. Commit 0ce25cf4c495e76e60dfca4ddc8f822507aa0e18. Pinned document.
- Arc Institute. VCC2026 metrics brief [Internet; software documentation]. Commit 0ce25cf4c495e76e60dfca4ddc8f822507aa0e18. Pinned document. Dated 2026 Aug 19; implementation 0.15.0, rule version 3.
- Ahlmann-Eltze C, Huber W, Anders S. Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselines. Nature Methods. 2025;22(8):1657–1661. doi:10.1038/s41592-025-02772-6.
- Viñas Torné R, Wiatrak M, Piran Z, Fan S, Jiang L, Teichmann SA, et al. Systema: a framework for evaluating genetic perturbation response prediction beyond systematic variation. Nature Biotechnology. 2026;44(6):1050–1059. doi:10.1038/s41587-025-02777-8.
- Miller HE, Mejia GM, Leblanc FJA, Swain B, Wang B, de Lima Camillo LP. Deep learning perturbation models can outperform baselines on calibrated metrics. Nature Biotechnology. 2026 [published online 2026-10-01]. doi:10.1038/s41587-026-03307-w.
- Rosen Y, Roohani Y, Agrawal A, Samotorčan L, Tabula Sapiens Consortium, Quake SR, et al. Universal cell embedding provides a foundation model for cell biology. Nature. 2026;656(8126):183–191. doi:10.1038/s41586-026-10689-z.
- Adduri AK, Gautam D, Bevilacqua B, Naghipourfar M, Imran A, Shah R, et al. Predicting cellular responses to perturbation across diverse contexts with State. Cell. 2026;189(19):5914–5931.e20. doi:10.1016/j.cell.2026.07.052.
- Dong M, Adduri A, Gautam D, Carpenter C, Shah R, Ricci-Tam C, et al. Stack: In-Context Learning of Single-Cell Biology. bioRxiv [Preprint]. 2026. doi:10.64898/2026.01.09.698608.
- Verma R, Adduri A, Bevilacqua B, Eraslan B, Burke DP, Goodarzi H, et al. PIE: Generalizing perturbation effects across unseen perturbations, contexts and datasets. bioRxiv [Preprint]. 2026. doi:10.64898/2026.10.02.756297. Public implementation; author announcement. The announcement, public README and abstract were consulted; the full paper was not examined in detail.
- Zhang J, Ubas AA, Svensson V, Thomas N, Subramanyam V, Carpenter C, et al. Tahoe-100M: Mapping drug-induced molecular phenotypes at single-cell resolution. Cell. 2026;189(19):5945–5961.e8. doi:10.1016/j.cell.2026.08.035.
- Nicol PB, Shivakumar S, Irizarry RA. Spurious correlation inflates performance in single-cell perturbation prediction. bioRxiv [Preprint]. 2026. doi:10.64898/2026.05.07.723486.
- Schäfer PSL, Reid KA, Boldyga Z, Aksu ED, Hakem H, Saez-Rodriguez J. Towards Principled Evaluation of Single-Cell Perturbation Prediction Models. bioRxiv [Preprint]. 2026. doi:10.64898/2026.07.23.740433.