モデルが勝てないときに追加する観測
On this page
要旨
摂動予測の改善が見えない理由は、データの情報不足、モデルによる情報の利用不足、評価指標の感度不足に分かれる。関連文献を比較し、指数減衰モデルの情報行列と全遺伝子MSEの期待値で違いを示す。同じ条件の反復は平均を精密にしても識別不能なパラメータを必ずしも分離せず、変化しない遺伝子を増やすと全体MSEでの改善は薄まる。必要な観測と評価は、予測対象や実験の目的によって異なる。
文献確認日:2026年10月9日。以下では査読済み論文、プレプリント、開発元の報告を区別する。図と数値表は本記事の数式例であり、実測の摂動データを再解析した結果ではない。
背景と目的
平均値を返すだけの予測に新しいモデルが勝てないとき、予測したい違いがデータに含まれているか、その違いを評価が拾えているかを区別する必要がある。
この二つは別の問題だ。情報のない観測から推定できないことはある。一方、情報があってもモデルが使えていない、あるいは評価が改善を見落としていることもある。「勝てなかった」という結果だけでは区別できない。
Eric Kernfeldは2025年5月のブログ記事 (1)で、遺伝子制御ネットワークの推論ではモデルの工夫に先立ち、データの情報量と必要な追加観測を考えるべきだと論じた。本稿もこの問いから始める。ただし、これは研究方針についての意見であり、すべての摂動予測に対する不可能性の証明ではない。
細胞数と区別できる条件数
単一細胞データでは細胞数が大きくなりやすい。しかし、同じ条件から細胞を増やすことと、別の時点・摂動・背景を測ることは同じではない。
同じ条件の細胞を増やせば、その条件の平均や分布は詳しくなる。だが、一つの時点しかなければ、その前に何が起きたかは直接にはわからない。同じ細胞株しかなければ、別の細胞株への移行は検証できない。多数の細胞があっても、独立した実験バッチやドナーの反復が少なければ、その不確実性は細胞数だけでは解消しない。
例えば、一つの培養から得た1万細胞を、そのまま1万回の独立した生物学的反復とは数えない。細胞内・条件内のばらつきと、培養・ドナー・実験日を跨ぐばらつきを分け、後者を一般化したいなら独立した反復を用意する。
これは「細胞を増やしても無意味」という話ではない。追加する観測が、どの不確実性を減らすのかを分けて考えるという話だ。
観測条件による情報量の違い
減衰する応答を考える。
\[ y(t)=A\exp(-kt)+\varepsilon,\qquad \varepsilon\sim N(0,\sigma^2). \]
ここでは各測定の誤差は独立、分散は既知で一定と仮定する。振幅\(A\)が既知なら、減衰速度\(k\)についてのFisher情報は
\[ I_k=\frac{A^2}{\sigma^2}\sum_r t_r^2\exp(-2kt_r) \]
になる。時刻0を何回測っても、\(k\)の情報は0だ。一観測あたりの情報は\(t=1/k\)で最大になるが、これは振幅既知・独立な一定分散誤差・このモデルの条件下での話である。未知パラメータが増えれば、最適な時点も変わる。
振幅も未知なら、一つの正の時点\(t_0\)を繰り返し測ってわかるのは\(A\exp(-kt_0)\)だけだ。同じ値を与える振幅と速度の組は無数にある。反復数を増やせばその時点の平均は精密になるが、この二つは分離できない。
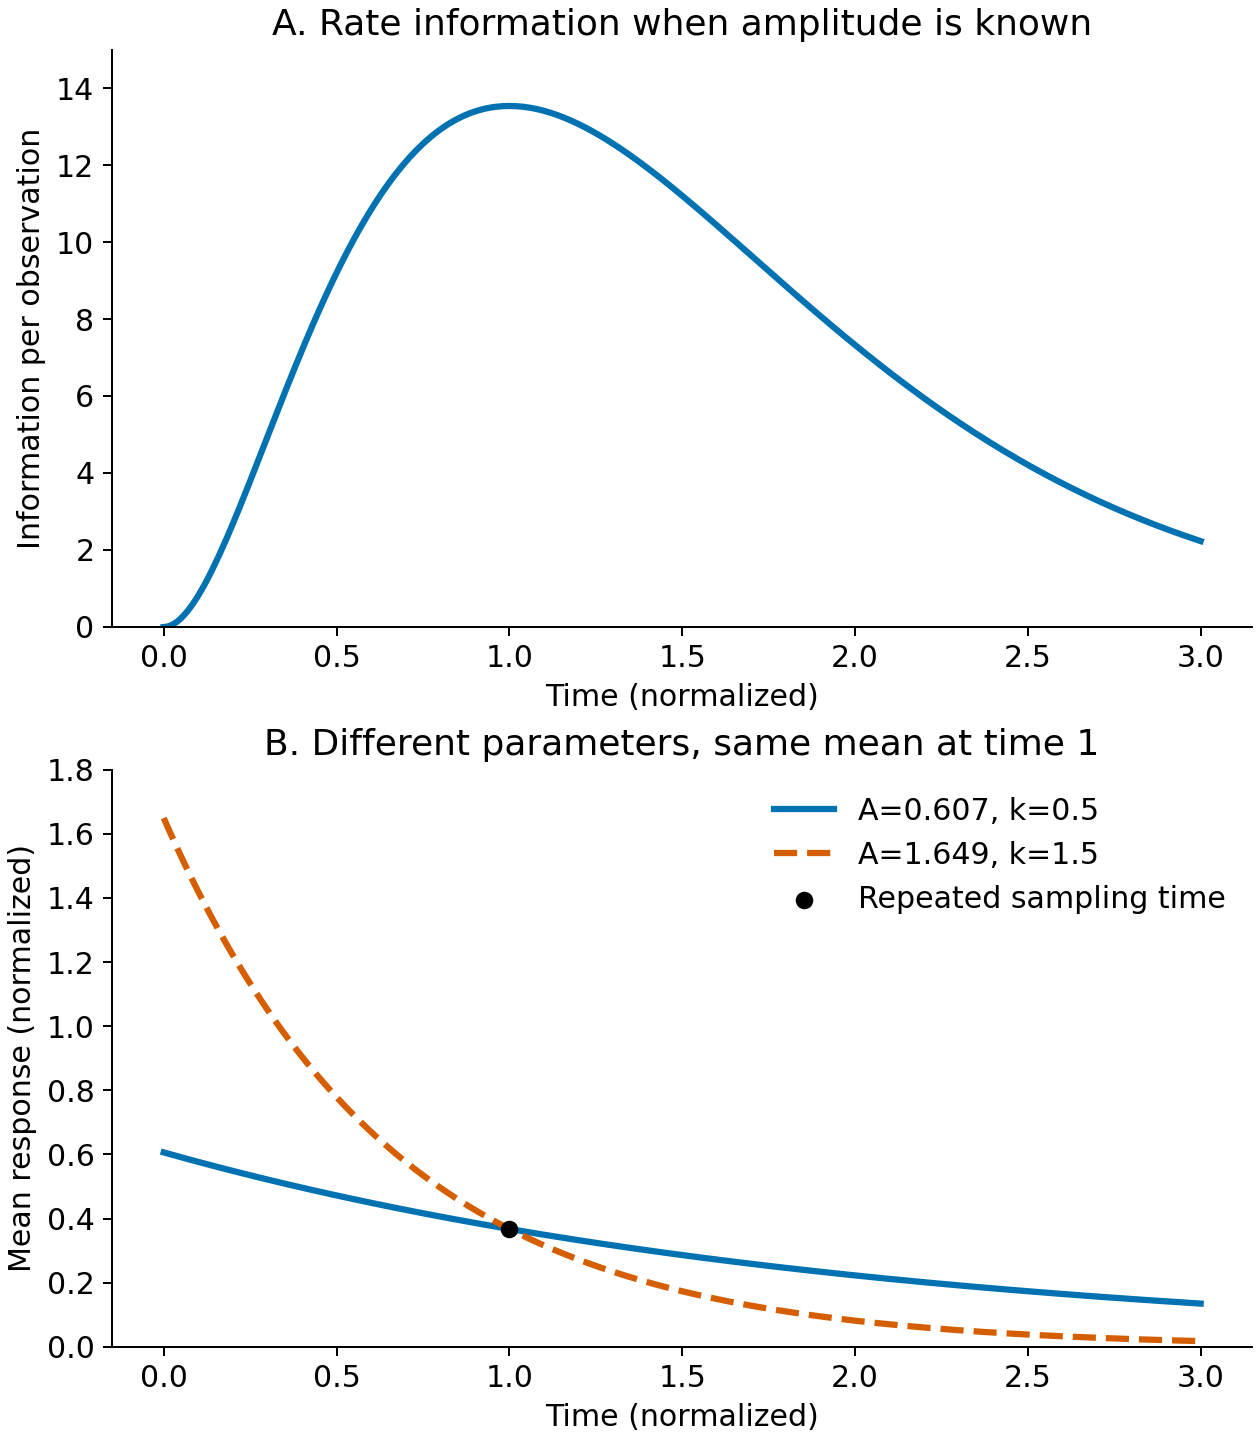
図1.観測時点と識別可能性。 正規化した単位で計算した説明用の例。上段は\(A=k=1,\sigma=0.1\)。下段の二曲線は時刻1の平均が一致する。実際の細胞応答に指数減衰を当てはめたものではない。
同じ10測定でも設計を変えると、振幅と速度についての情報行列の階数が変わる。表1はパラメータ\((\log A,\log k)\)についての局所計算である。
表1 測定時点の配置と局所情報
| Allocation of ten measurements | Information matrix rank | Local information about log k accounting for uncertain amplitude |
|---|---|---|
| All at time zero | 1 | 0 |
| All at time one | 1 | 0 |
| Five at time zero and five at time one | 2 | 59.60 |
出力:results/designs.csv。振幅を固定した条件付き情報と、振幅を未知として扱う情報を混同しないことが重要だ。二時点ならこの例では局所的に分離できるが、実データで十分に精密に推定できるかは別途確認する必要がある。
実際のモデルでは、パラメータを一つずつ固定し、他を再推定するprofile likelihoodが役立つ。Raueら (2)は、構造上の識別不能と、有限データによる実用上の識別困難を扱っている。平坦な尤度だけで一般的な不可能性を断定するのではなく、モデルの対称性、観測設計、誤差モデル、探索範囲を併せて調べたい。
摂動予測の論文が比較するもの
近年の議論を「深層学習は勝てる/勝てない」の二択にすると、肝心な違いを見失う。比較するベースライン、評価する出力、未知条件の定義が違うからだ。
表2 摂動予測研究の比較対象
| Primary source | Release and status | Point examined here |
|---|---|---|
| Ahlmann-Eltze et al. (3) | August 2025; peer-reviewed | Strong simple linear baselines in the examined settings, rather than a conclusion about all future models |
| Systema (4) | Online August 2025; peer-reviewed | Separate evaluation of shared perturbation variation and target-specific responses |
| Wei et al. (5) | Online December 2025; peer-reviewed | Comparison of 27 methods, 29 datasets and six metrics; unseen perturbations and unseen backgrounds require separate interpretation |
| Miller et al. (6) | October 1, 2026; peer-reviewed | Fourteen datasets and 18 metrics; positive controls test metric sensitivity and detect deep-model improvements in some settings |
| AmbiModBench (7) | September 26, 2026; preprint | Training-mean comparisons, gene-coordinate permutation and representation-space coverage probe what a score measures |
Millerらの論文は特に重要だ。同じ摂動の細胞を二分したtechnical duplicateと、弱い応答を平均値へ寄せるinterpolated duplicateを用い、陽性・陰性対照の差を指標がどれだけ拾うかを調べた。前者は有限細胞から作る推定なので、弱い信号では平均ベースラインよりばらつくこともある。真の条件付き平均を知る仮想的な予測器とは違い、独立した生物学的実験の再現性を保証するものでもない。
線形・加算ベースラインとの比較も含み、Wessels23の組合せ予測では加算を上回るモデルが報告された。一方、Norman19では加算が強かった。学習範囲だけでなく、応答の強さやデータ構成、モデル世代も異なるため、差の原因を一つに決められない。「どの設定でも勝てない」も「常に勝つ」も適切でなく、この研究は未知の細胞背景への一般化を検証したものでもない。
ここでのcalibrationは評価指標の感度の点検であり、予測確率の較正と同義ではない。また、評価用の実測応答を使う陽性対照は、未知条件に投入できる予測器ではない。試験データに基づく対照を採点のために使うことと、その情報を学習やモデル選択へ戻すことを分ける必要がある。
評価が改善を隠す状況は、簡単な期待値でも説明できる。評価する\(G\)遺伝子のうち10遺伝子だけが1だけ変化し、各遺伝子の独立な観測誤差の分散を1とする。変化なしを予測するモデルの期待MSEは\(1+10/G\)、真の条件付き平均を知る仮想的な予測器は1になる。
表3 評価遺伝子数と期待MSE
| Evaluated genes | Expected MSE predicting no change | Expected MSE knowing the true mean | Difference |
|---|---|---|---|
| 100 | 1.100 | 1.000 | 0.100 |
| 1,000 | 1.010 | 1.000 | 0.010 |
| 10,000 | 1.001 | 1.000 | 0.001 |
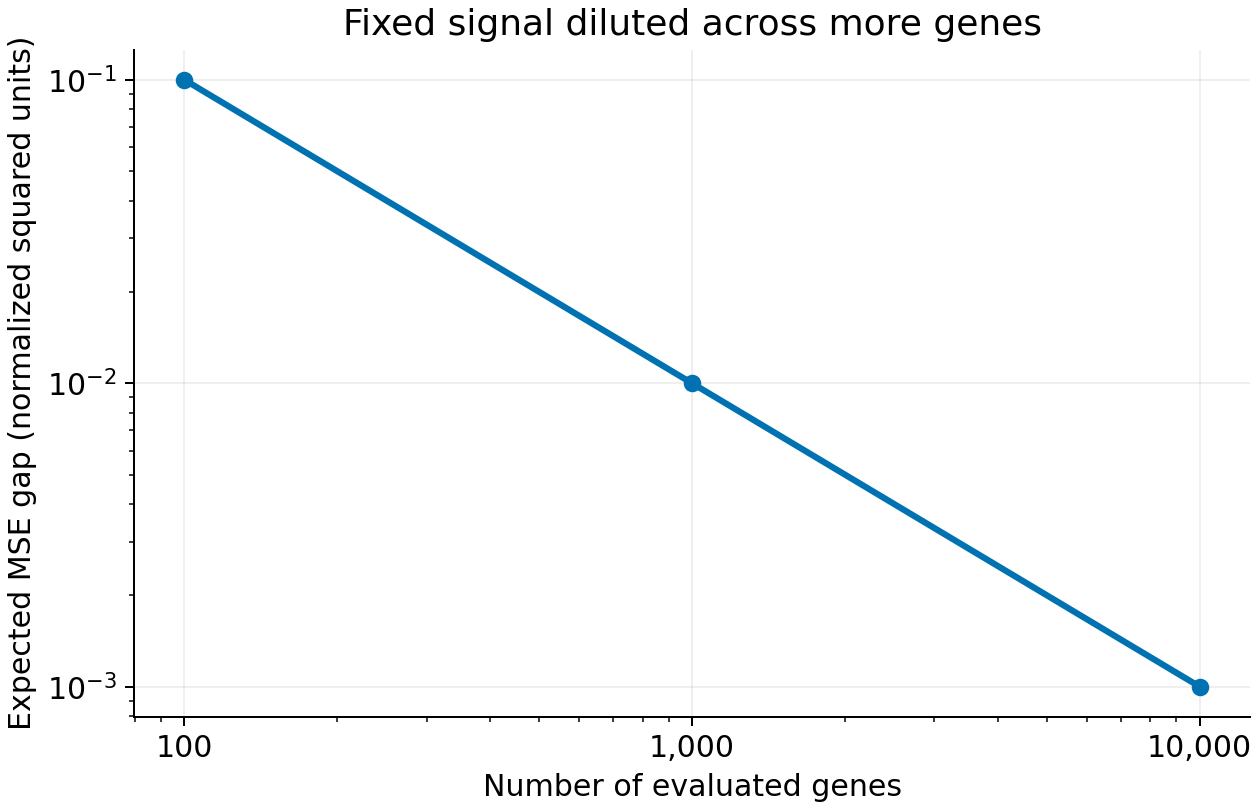
図2.固定した信号の希釈。 両軸は対数。出力:results/metrics.csv。この例では順位は逆転せず、真の平均を知る予測器が常に良い。差が小さいことと統計的に検出不能なことも同じではない。十分な独立反復があれば小さな差を検出できる可能性がある。
これはMillerらの評価を再現した図ではなく、全体指標における信号の薄まりを示す例だ。実データで「変化した遺伝子だけ」を選ぶ場合も、選択方法と対照を明示しなければ、新たな評価の偏りが入る。
細胞数以外の情報を増やす方法
RNAだけでは区別しにくい関係が、別の観測層や背景情報で区別できることがある。LINGER (8)はRNAとクロマチンの情報、外部の情報を利用して制御ネットワークを推論する。ベンチマーク上の改善は、推定された全ての辺が因果的だという保証ではないが、入力を増やすという方向を具体化している。
2026年には、観測の質と背景の広がりを扱う報告も出た。Wangらのプレプリント (9)は、摂動が十分に効いているか、共通応答と特異的応答を区別できるかを点検する。そこでの分類は研究固有の定義に依存するため、「公開データの一定割合は使えない」という一般則にはしない。
査読済みのState論文 (10)は、細胞の集合と背景間の移行を扱う。10月5日公開のPIE (11)は、既存の生物学的知識と摂動データから集団レベルの応答を予測するプレプリントだ。PIEの開発元の解説 (12)では、細胞背景と摂動が両方未知になると精度が落ちることも示されている。これは独立した追試ではなく、著者による報告として読む。
PIEのように入力する知識や出力の定義を変えた改善を、単純に「大きなモデルが勝った」とまとめるのは適切でない。比較するときは外部知識の出所、利用可能な時点、事前学習の対象、評価条件との重なりも確認したい。外部知識の利用そのものは不正ではなく、その情報を使える用途かどうかが問題になる。
また、Arcの2026年のデータ生成報告 (13)では、複数の細胞株で手順を揃え、ノックダウンと対照を点検している。背景を広げ、測定の一貫性を上げる試みだ。ただし、時点を揃えることと時系列を測ることは違う。こうしたデータから時間変化まで検証できるとは限らない。
追加実験を選ぶ目的
追加実験を選ぶ目的も一つではない。モデルの不確実性を減らすことと、関心のある状態へ細胞を動かすことは違う。
パラメータ\(\theta\)、既存データ\(D\)、実験\(e\)の結果\(Y_e\)について、期待情報利得を使うなら
\[ e^*=\arg\max_e I(\theta;Y_e\mid D,e) \]
と書ける。これは、結果を見る前に、事後分布が平均的にどれだけ変わるかを評価する考え方だ。ただし、事前分布、誤差モデル、実験候補、関心パラメータを決めて初めて意味を持つ。モデルが間違っていれば、そのモデルの中でだけ効率の良い実験を選ぶ可能性がある。
期待情報利得と効用に基づく設計の一般的な整理は、ChalonerとVerdinelliの総説 (14)を参照できる。候補モデルが違う応答を予測するだけでは十分でなく、その差を測定誤差の中で検出でき、実施できることも必要だ。
Zhang et al. (15)は、望む応答に近づく介入の選択を扱う。Sandor and Antal (16)は、ネットワーク構造の不確実性を減らすBayesian active learningを扱い、シミュレーション等で検討した。後者を、前向きの実験で普遍的な有効性が確立した方法とは扱わない。
NAIAD (17)は組合せ摂動の応答予測と探索を扱う。大きな効果を持つ組合せを見つけたい場合と、ネットワークを区別したい場合では、同じ実験を選ぶとは限らない。情報量が多い実験が、実務上最も有用とも限らない。費用、実施可能性、意思決定の損失まで含めた効用が必要になる。
考察
識別不能なパラメータが残っても、関心のある予測は安定することがある。逆に、既存条件での予測が近い候補モデルでも、新しい時点や背景への外挿は分かれうる。モデルを識別できることと、ある予測が実用的な幅に収まることは、異なる性質である。
各論文でいう「情報が足りない」も同一ではない。測定誤差で差が見えない場合、独立反復が少ない場合、背景が評価集合を覆わない場合、そもそも採点指標が関心の違いを拾わない場合がある。細胞数の増加だけですべてが解消するわけではない。
本記事で比較した議論から、万能な実験配分は得られない。候補モデルが同意している場合にも共通の誤りは残り、モデル間の予測差だけでは独立検証の代わりにならない。
結論
データの情報量と評価の感度は別々に検討すべき性質である。本稿の計算例は観測条件と評価対象による違いを示すが、実際の摂動データでどちらが性能を制限しているかは判定していない。追加実験の価値も、構造の識別、予測の精密化、望む応答の探索のいずれを目的とするかによって変わる。
データとコードの公開状況
図と数値表はinformation_demo.pyから生成した。PythonとNumPy、Matplotlibが必要で、乱数や外部データは使わない。python information_demo.pyで生成し、python -m unittest test_demo.py -qで数式と情報行列の性質を検査する。文献の大規模モデルを再実装・検証した資料ではない。
参照
- Kernfeld E. [Blog post on guiding questions for gene regulatory network inference; descriptive title] [Internet]. 2025 May [cited 2026 Oct 9]. Original post.
- Raue A, Kreutz C, Maiwald T, Bachmann J, Schilling M, Klingmüller U, et al. Structural and practical identifiability analysis of partially observed dynamical models by exploiting the profile likelihood. Bioinformatics. 2009;25(15):1923–1929. doi:10.1093/bioinformatics/btp358.
- Ahlmann-Eltze C, Huber W, Anders S. Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselines. Nature Methods. 2025;22(8):1657–1661. doi:10.1038/s41592-025-02772-6.
- Viñas Torné R, Wiatrak M, Piran Z, Fan S, Jiang L, Teichmann SA, et al. Systema: a framework for evaluating genetic perturbation response prediction beyond systematic variation. Nature Biotechnology. 2026;44(6):1050–1059. doi:10.1038/s41587-025-02777-8.
- Wei Z, Wang Y, Gao Y, Wang S, Li P, Si D, et al. Benchmarking algorithms for generalizable single-cell perturbation response prediction. Nature Methods. 2026;23(2):451–464. doi:10.1038/s41592-025-02980-0.
- Miller HE, Mejia GM, Leblanc FJA, Swain B, Wang B, de Lima Camillo LP. Deep learning perturbation models can outperform baselines on calibrated metrics. Nature Biotechnology. 2026 [published online 2026 Oct 1]. doi:10.1038/s41587-026-03307-w.
- Huang S, Yang Z, Yu K, Chen J, Li SZ. AmbiModBench: Benchmarking Gene Perturbation Prediction Beyond Shared Responses. arXiv [Preprint]. 2026 Sep 26;2609.32527v1. Preprint.
- Yuan Q, Duren Z. Inferring gene regulatory networks from single-cell multiome data using atlas-scale external data. Nature Biotechnology. 2025;43(2):247–257. doi:10.1038/s41587-024-02182-7.
- Wang X, Kuipers J, Hugi F, Platt RJ, Beerenwinkel N. Reliable single-cell perturbations explain and improve model performance. bioRxiv [Preprint]. 2026 Aug 12. doi:10.64898/2026.08.11.744177.
- Adduri AK, Gautam D, Bevilacqua B, Naghipourfar M, Imran A, Shah R, et al. Predicting cellular responses to perturbation across diverse contexts with State. Cell. 2026;189(19):5914–5931.e20. doi:10.1016/j.cell.2026.07.052.
- Verma R, Adduri A, Bevilacqua B, Eraslan B, Burke DP, Goodarzi H, et al. PIE: Generalizing perturbation effects across unseen perturbations, contexts and datasets. bioRxiv [Preprint]. 2026 Oct 5. doi:10.64898/2026.10.02.756297.
- Arc Institute. PIE [Internet; developer report]. 2026 Oct 5 [cited 2026 Oct 9]. Developer explanation.
- Arc Institute. Generating high-quality Perturb-seq data for the 2026 Virtual Cell Challenge [Internet; developer report]. 2026 Oct 1 [cited 2026 Oct 9]. Report.
- Chaloner K, Verdinelli I. Bayesian Experimental Design: A Review. Statistical Science. 1995;10(3):273–304. doi:10.1214/ss/1177009939.
- Zhang J, Cammarata L, Squires C, Sapsis TP, Uhler C. Active learning for optimal intervention design in causal models. Nature Machine Intelligence. 2023;5(10):1066–1075. doi:10.1038/s42256-023-00719-0.
- Sándor D, Antal P. Efficient structure learning of gene regulatory networks with Bayesian active learning. BMC Bioinformatics. 2025;26(1):150. doi:10.1186/s12859-025-06149-6.
- Qin J, Wessels HH, Fernandez-Granda C, Hao Y. Active Learning for Efficient Discovery of Optimal Combinatorial Perturbations. In: Proceedings of the 42nd International Conference on Machine Learning. Proceedings of Machine Learning Research. 2025;267:50363–50383. Conference paper.