同じ摂動の別の半分を評価指標は見分けられるか
On this page
要旨
公開Perturb-seqデータ3件で、同じ摂動の細胞を二分した平均が、他の摂動の平均より良いと判定される割合を5指標で調べた。MSEの勝率はWesselsで0.804、Normanで0.933、Replogle K562 essentialで0.262だった。上位50遺伝子のPearson、重みつきMSE、順位は、3件すべてで事前の区切り0.90を超えた。技術的な重複の期待二乗誤差は、信号の強さだけでなく半分の細胞の平均の分散にも依存する。この点検は指標の性質を示し、深層学習モデルの優劣や生物学的妥当性は評価しない。
文献の確認日:2026年10月12日。指標の定義は10月13日に査読済み論文の本文で追加照合した。使ったのは公開論文と、公開された単一細胞データだけである。深層学習モデルは動かしていない。本記事が点検するのは、モデルではなく、評価指標である。
遺伝子を操作した後の細胞を予測するモデルについて、2025年のAhlmann-Eltzeらは、5つの基盤モデルと2つの深層学習モデルを、単純なベースラインと比べ、遺伝子の単独・二重摂動の予測で、調べた条件では、いずれも単純なベースラインを上回らなかったと報告した (1)。これに対し、2026年のMillerらは、評価指標の較正の問題を指摘し、指標を較正すると、複数の深層学習モデルがベースラインを上回ると報告した (2)。
どちらが正しいのか。この記事では、この問いには直接答えない。代わりに、後者の主張が置く前提の一部を、公開データで確かめる。前提とは、「同じ摂動の別の半分の細胞(技術的な重複)を、平均ベースラインより良いと判定できない指標では、モデルの優劣を測りにくい」ということである。この前提は、モデルを動かさなくても、公開データで点検できる。
背景:何が争われているのか
予測モデルを評価するとき、単純な基準(ベースライン)を置く。ここでの基準は二つある。
- 平均ベースライン: どの摂動に対しても、全摂動の平均を予測する。摂動に特異的な情報を持たない。
- 線形ベースライン: 遺伝子の埋め込みなどから、摂動の効果を線形に予測する。
Ahlmann-Eltzeらの結論は、調べた条件で深層学習がこれらを上回らないことだった。Millerらは、評価指標の側に問題があるとした。全遺伝子の平均誤差(MSE)では、ほとんどの遺伝子が変化しないため、摂動に特異的な効果が埋もれ、陽性対照ですら、陰性対照に勝てないことがある。そこで、陽性対照(技術的な重複)と陰性対照(平均ベースライン)の差が十分に出る指標を「較正された指標」と呼び、その指標では、深層学習が勝つ場合があると報告した。
以下の「論文の定義」は、2026年10月13日に読んだ、Nature Biotechnology版(2026年10月1日にオンライン公開、査読済み)の本文に基づく。論文の利益相反の記載では、著者のうち5人がShift Bioscience(摂動予測に関わる企業)の社員で、1人がXaira Therapeuticsの役職者である。ただし、著者の所属は、どちらの論文についても、結果の妥当性の根拠にはならない。論文自身も、較正された指標が生物学的に意味があるとは限らないと述べている。これらの指標の議論は、以前の記事(Virtual Cellは何を予測できたのか) (3)でも扱った。本記事はその続きとして、指標を実データで点検する。
評価指標を陽性対照で点検する
解析の前に、問いと使い道を文章で固定し、そのハッシュ値を記録した。
- 問い(QOI): 公開されたPerturb-seqデータで、5つの指標のうち、どれが、技術的な重複を平均ベースラインより良いと判定できるか。その判定は、摂動の効果の大きさでどう変わるか。
- 使い道(COU): 評価指標の点検に限る。特定のモデルの優劣、深層学習が線形ベースラインに勝つかの判断には使わない。誤判断の帰結は、区別できない指標でモデルの優劣を論じること(結論が指標の産物になる)である。
データと方法
データ: WesselsらのCas13 RNA Perturb-seq (4) を、scPerturb (5) の公開データ(CC BY 4.0)から取得した (6)。THP-1細胞にCRISPR-Cas13で遺伝子を操作し、30,707細胞、187の摂動(多くは2遺伝子の同時操作)、非標的の対照細胞424個。整数のカウント表で、規格化(細胞ごとに合計1万、log1p)して使った。解析する遺伝子は、全細胞の1%以上で検出された12,060個。細胞数が50以上の161摂動を対象にした。
予測と基準(摂動ごと): 摂動 \(p\) の細胞を無作為に半分ずつ(\(A\)、\(B\))に分け、\(B\) の平均発現を経験的な参照値とする(10回の分割)。
- 技術的な重複(陽性対照): \(A\) の平均発現。同じ条件から有限個の細胞を採った平均であり、測定誤差に加えて細胞間の不均一性と標本抽出の変動を含む。真の条件付き平均でも、独立した生物学的反復実験でもない。
- 平均ベースライン(陰性対照): \(p\) を除く全摂動の平均(leave-one-out)。
- control: 何もしない(非標的細胞の平均)。
本記事の実装は、Millerらのコードを使わず、論文(Nature Biotechnology版)の記述から私が組んだもので、次の点が異なる。
- 平均ベースライン:論文は、学習した全摂動の平均のさらに平均(データセット全体で1つ、摂動を等しく重みづけ)と定義している。本記事は、評価する摂動自身を除いて作った(leave-one-out)。
- 重みつきMSE:重みは、差次発現解析から作る(論文は、以前の報告の重みと同じとしている)。本記事は、全細胞から作った。
- 上位遺伝子の指標:論文には、摂動ごとに上位100のDEGに絞る変種がある(原論文のExtended Data Fig. 5)。本記事は、上位50遺伝子を使った。
- 順位:論文は、正規化した逆順位(NIR)を使う。本記事は、Δの二乗誤差を距離にした。
- 陽性対照:論文は、補間した重複(interpolated duplicate)を、より安定な陽性対照として使い、技術的な重複も定義している。本記事は、技術的な重複だけを使った。DRFの式は、論文と同じ(陽性対照と陰性対照の差を、理想との差で割る)。
- 前処理:論文は、細胞数が12未満の摂動を除き、摂動あたりの細胞数に上限を設ける。本記事は、50細胞以上の摂動を使い、上限は設けていない。
- 「較正されている」の数値の基準:論文には見当たらない(DRFの比較で、定性的に述べられている)。0.90は、本記事の区切りである。
指標(5つ): MSE、Pearson(全遺伝子のΔ、Δは controlとの差)、上位50遺伝子のPearson、重みつきMSE(変化の有意性で重みづけ)、順位(NIR:全摂動の真値のうち、予測が \(p\) の真値に何番目に近いか)。
陽性対照が陰性対照より良ければ「勝ち」とし、勝率が0.90以上の指標を「区別できる指標」とした。0.90は、本記事が計画で事前に決めた区切りで、Millerらの基準ではない(技術的な重複が、ほとんどの場合に勝つことを求める、という以上の根拠はない)。指標ごとに、動的範囲の割合(DRF)も出した。
\[ \mathrm{DRF}=\frac{s_{\text{duplicate}}-s_{\text{mean}}}{s_{\text{ideal}}-s_{\text{mean}}} \]
\(s\) は指標の値(良いほど大きくなる向き)で、理想値は、MSEで0、Pearsonと順位で1である。陽性対照が、陰性対照から理想までの差を、どれだけ埋めるかを表す。
結果
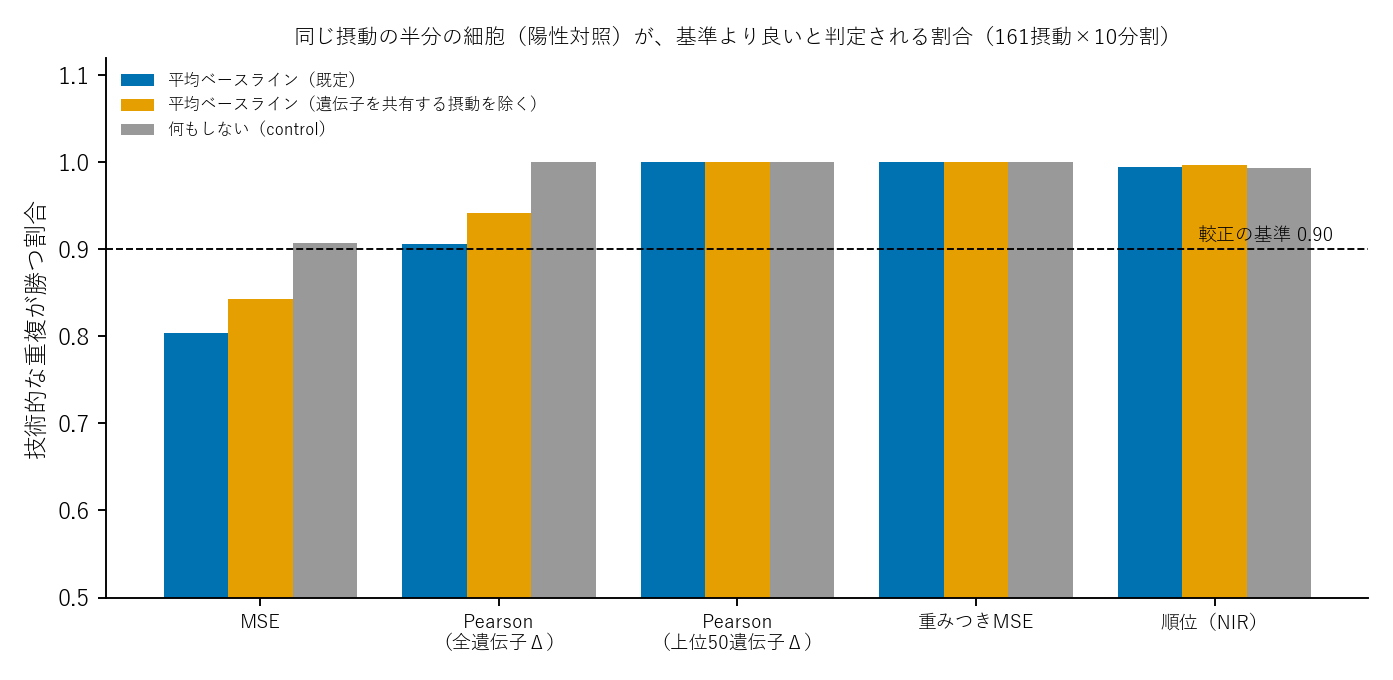
図1. 技術的な重複が、平均ベースラインやcontrolに勝つ割合。
表1.Wesselsデータでの勝率とDRF。
| 指標 | 勝率(95%区間) | DRF(中央値) | 感度解析(遺伝子を共有する摂動を除いた平均)の勝率 |
|---|---|---|---|
| MSE | 0.804(0.748〜0.858) | 0.26 | 0.843 |
| Pearson(全遺伝子Δ) | 0.906(0.870〜0.939) | 0.33 | 0.942 |
| Pearson(上位50遺伝子Δ) | 1.000(1.000〜1.000) | 0.97 | 1.000 |
| 重みつきMSE | 1.000(1.000〜1.000) | 0.93 | 1.000 |
| 順位(NIR) | 0.995(0.989〜0.999) | 1.00 | 0.997 |
95%区間は、摂動を単位に、5,000回のブートストラップで求めた。1,610(161摂動×10分割)は独立ではない。再標本化の単位は161摂動だが、遺伝子を共有する摂動間の依存まで除けるわけではない。1.000〜1.000という区間も、この標本と再標本化法の結果であり、別の実験で完全に区別できる保証ではない。
事前に決めた区切り(0.90以上)を満たしたのは、Pearson(全遺伝子Δ)、上位50遺伝子のPearson、重みつきMSE、順位である。MSEだけが、区切りを下回った(0.804)。Pearson(全遺伝子Δ)は0.906だが、区間(0.870〜0.939)は0.90をまたぎ、0.90と区別できない。MSEのDRFの中央値は0.26で、技術的な重複は、陰性対照から理想までの差の約4分の1しか埋めない。
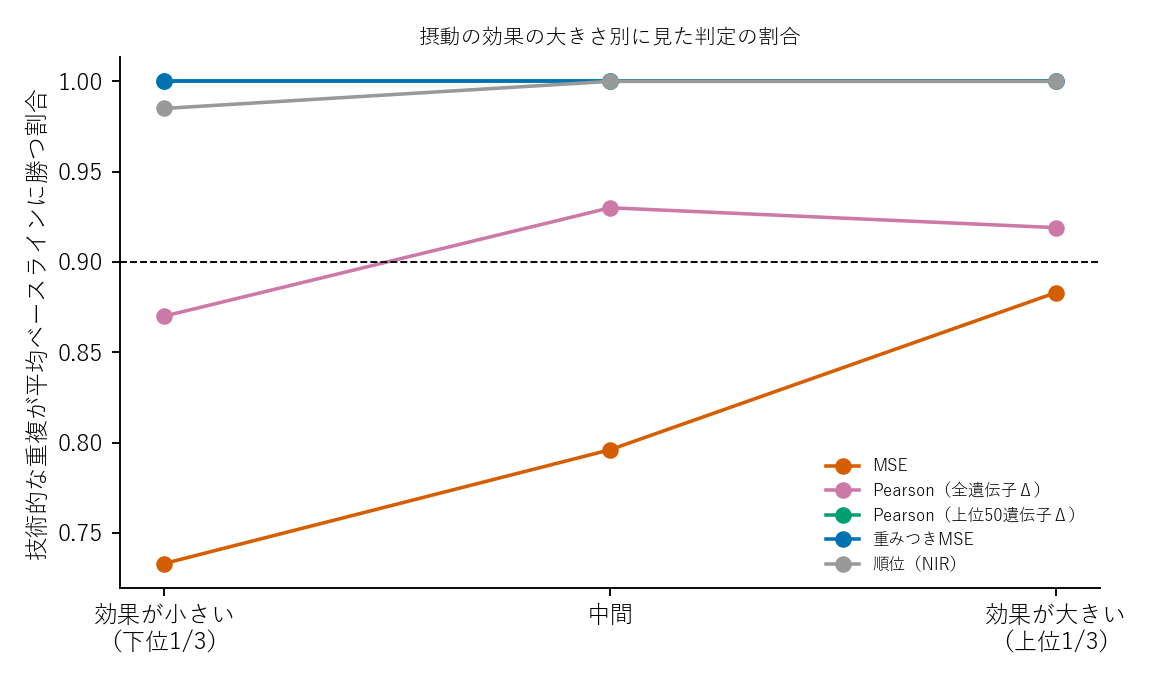
図2. 摂動の効果の大きさ別に見た、勝率。
効果の大きさ(全細胞でのΔのL2ノルム)で3分位に分けると、MSEの勝率は、効果が小さい群で0.733、中間で0.796、大きい群で0.883と、効果が大きいほど上がった。それでも、上位3分の1で基準に届いていない。重みつきMSE、上位遺伝子のPearson、順位は、どの群でもほぼ1である。
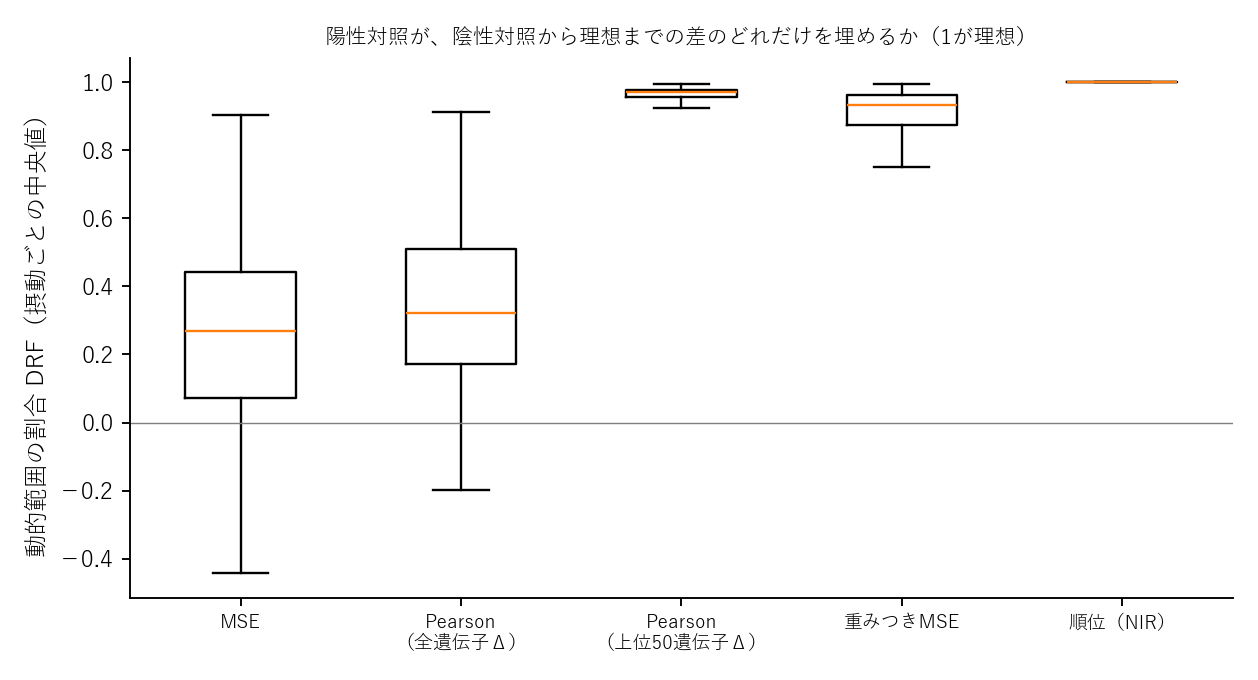
図3. 動的範囲の割合(DRF)の分布。
MSEの期待誤差と信号の大きさ
これは、簡単な式で説明できる。遺伝子 \(g\) で、摂動の真の平均を \(\mu_g\)、1細胞あたりの分散を \(\sigma_g^2\)、半分の細胞数を \(h\) とする。技術的な重複 \(A\) も、参照値 \(B\) も、それぞれ \(h\) 細胞の平均で、互いに独立に、分散 \(\sigma_g^2/h\) のノイズを持つとする(細胞数が奇数のときは、1細胞を捨てる)。平均ベースラインの値 \(m_g\) は、ほかの摂動から推定する。以下はその推定値を固定した条件付きの比較で、\(A\) と \(B\) の細胞が独立に抽出されると仮定する。期待される二乗誤差(全遺伝子の合計。MSEは、これを遺伝子数で割った平均で、両辺に同じ係数がかかるので、条件は変わらない)は、
\[ \text{技術的な重複: } 2\sum_g \frac{\sigma_g^2}{h},\qquad \text{平均ベースライン: } \sum_g(\mu_g-m_g)^2+\sum_g\frac{\sigma_g^2}{h}. \]
したがって、技術的な重複の期待二乗誤差が小さくなる条件は、
\[ \sum_g(\mu_g-m_g)^2 \;>\; \sum_g\frac{\sigma_g^2}{h}. \]
摂動に特異的なずれの二乗の合計が、半分の細胞の平均の分散(\(\sigma_g^2/h\))の合計を超えなければ、平均ベースラインの期待MSEが小さい。この比較は期待値について成り立つもので、個々の分割の勝敗を保証しない。 効果が小さい摂動や、細胞数が少ない摂動(\(h\) が小さい)は、右辺が大きく、左辺が小さいので、負けやすい。これは、図2の傾向と一致する。
この基準を、全細胞での推定から計算し(ずれの二乗は、標本分散の偏りを補正した)、観測された勝敗の多数決と比べた(探索的で、計画の外に、主結果を見た後で追加した)。161摂動のうち158(98.1%)で一致した。ただし、常に「勝つ」と答えるだけでも、一致は80.1%になる(基準率)。また、基準も観測も同じ細胞から作るので、独立な検証ではない。この結果は、MSEの勝敗が、細胞数と効果の大きさの比と整合することを示すにとどまる。
他の2つのデータでも確かめる
ここまでは、1つのデータ(Wessels)の結果である。そこで、同じ点検を、他の2つのデータに、解析計画の追記(analysis-plan-addendum.md、計算の前に固定)に従って行った。Norman (7)(K562、CRISPRa、組合せ摂動、236摂動)と、Replogle (8) の K562 essential(CRISPRi、必須遺伝子、1832摂動)である。方法は同じで、メモリを抑えるために、データを分割して読む実装に変えた(Wesselsでは、元の実装と、すべての数値が一致することを確認した)。Replogle は、メモリの制約で、分割を5回にした(他は10回)。
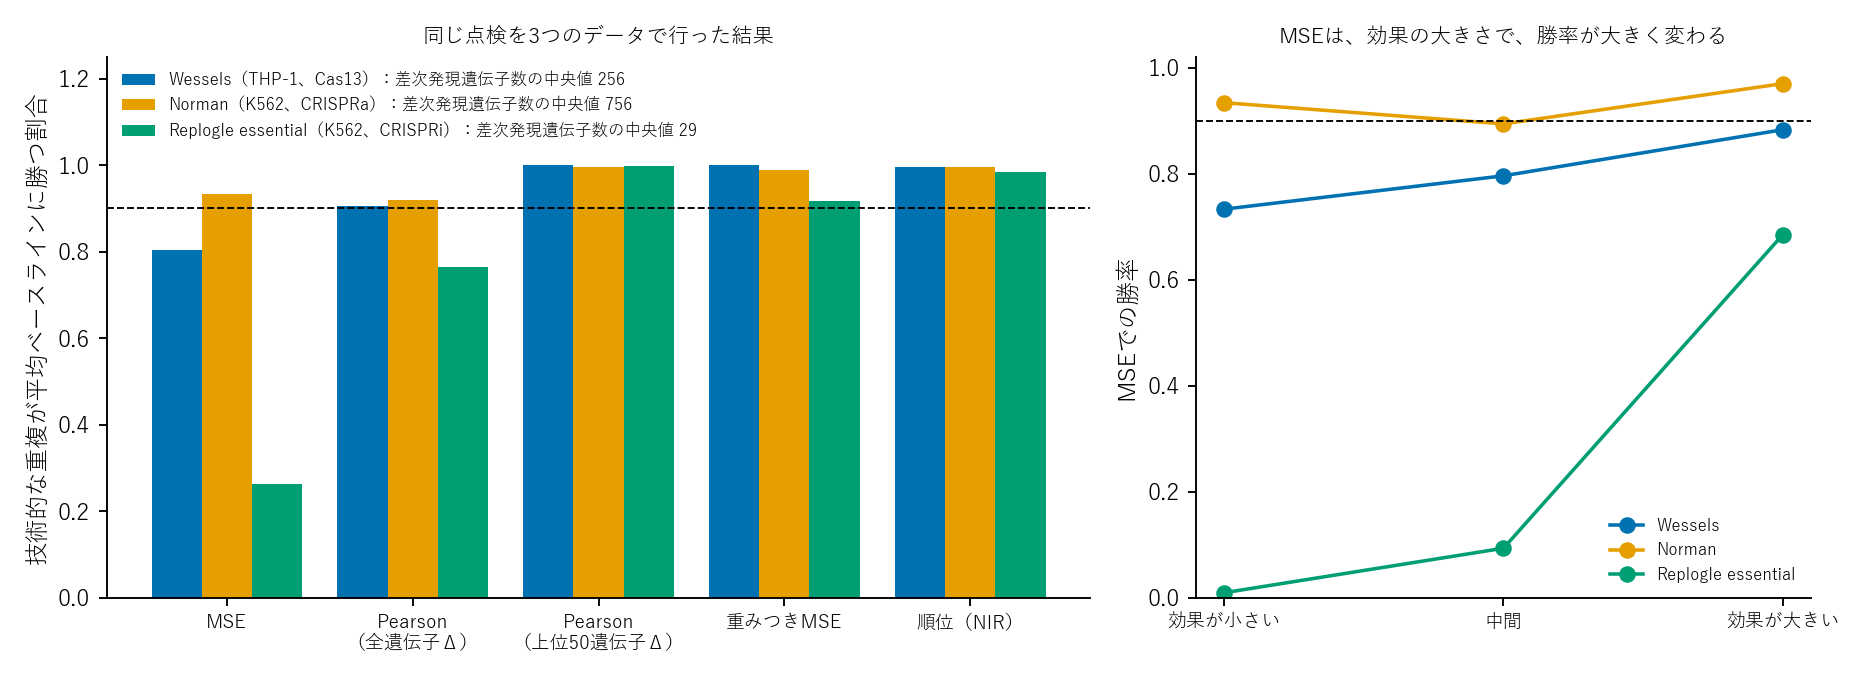
図4. 3つのデータでの、勝率と、効果の大きさ別のMSEの勝率。
表2.3データセットの勝率。MSEのみ95%ブートストラップ区間を併記した。
| データ | 摂動の数 | 摂動あたりの差次発現遺伝子数(中央値) | MSE | Pearson(全遺伝子Δ) | 上位50遺伝子 | 重みつきMSE | 順位 |
|---|---|---|---|---|---|---|---|
| Replogle essential | 1832 | 29 | 0.262(0.243〜0.282) | 0.764 | 0.997 | 0.917 | 0.984 |
| Wessels | 161 | 256 | 0.804(0.748〜0.858) | 0.906 | 1.000 | 1.000 | 0.995 |
| Norman | 236 | 756 | 0.933(0.904〜0.958) | 0.919 | 0.995 | 0.989 | 0.996 |
差次発現遺伝子数は、Welch検定のp値が、解析した遺伝子数でのBonferroni補正後に0.05未満の遺伝子の数である。
- MSEの勝率は、データで大きく違った。 Replogle では 0.26(技術的な重複が、平均ベースラインに、約74%で負けた)、Wessels では 0.80、Norman では 0.93 だった。順序は、差次発現遺伝子数の中央値(29、256、756)の順と一致した(3つなので、検定はしていない)。Replogle の結果は、論文が、より大きい全ゲノム版で報告した「約95%で負けた」と、方向が同じである(全ゲノム版は、本記事では解析していない)。
- Replogle では、効果の大きさで、MSEの勝率が大きく変わった。 効果が小さい3分の1で 0.01、中間で 0.09、大きい3分の1で 0.69。Norman は 0.93、0.89、0.97。
- 重みつきMSE、上位50遺伝子、順位は、3つのデータで高かった(Replogle でも、順位 0.98、上位50遺伝子 1.00、重みつきMSE 0.92)。Pearson(全遺伝子Δ)は、Replogle で 0.76 に下がった。
- 期待誤差からの探索的基準は、3つのデータで、観測の多数決と、ほぼ一致した。 一致率は、Wessels 98.1%(基準率 80.1%)、Norman 98.7%(94.1%)、Replogle 99.1%(26.4%)。Replogle では、基準率が 26%(常に「負ける」と答える一致率は 74%)なのに対し、基準は 99% で一致した。ただし、基準も観測も、同じ細胞から作るので、独立な検証ではない。
つまり、MSEで、技術的な重複が平均ベースラインに勝てるかは、データ(摂動の効果の強さと細胞数)で決まり、一つのデータの結果を、他に一般化できない。 区別できるかを、先に確かめる必要がある、という結論は、3つのデータで強まった。
考察
Wesselsでは、MSEは、「同じ摂動の別の半分」を、平均ベースラインに対して、約2割で勝たせられず、Replogle K562 essentialでは約74%で勝たせられなかった(Normanは約7%)。指標の選び方で、ベースラインとの優劣の読みが変わりうるという見方(Millerらの主張の前提の一部)と、整合する結果である。3つのデータでの確認で、論文の結論そのものの検証ではない。
重みつきの指標、上位遺伝子の指標、順位は、3つのデータで、事前の区切り0.90を超えた(Replogle essential でも、順位 0.98、上位50遺伝子 1.00、重みつきMSE 0.92)。MSEで区別できない摂動は、細胞数と効果の大きさの比と整合する。
深層学習が線形ベースラインに勝つかどうかは判断しない。 本解析は、モデルを評価していない。指標が区別できることは、モデルの優劣を正しく測れることとは別である。
較正された指標の生物学的な妥当性も別の問題である。 上位遺伝子と重みは、信号の強い遺伝子を選ぶので、摂動に特異的でない平均ベースラインには、構造的に勝ちやすい。区別できる指標は、「摂動に特異的な情報を持つか」を測る道具で、「生物学的に正しい予測か」を測る道具ではない。
一般化できるデータの範囲にも限界がある。 本記事は、3つのデータ(Wessels、Norman、Replogle K562 essential)を調べた。論文が報告した、より大きい全ゲノム版(Replogle K562 GWPS、約8.8 GB)は、解析していない。論文は、そこで、MSEでは約95%の摂動で技術的な重複が平均ベースラインに負けたと報告し(原論文のExtended Data Fig. 1e)、信号の希釈(平均で、1摂動あたり差次発現遺伝子が3.25個、Norman19では102個)で説明している。本記事のReplogle essentialでも、MSEの勝率は低く(0.26)、差次発現遺伝子の中央値は29だった。
限界
- 3つのデータは、それぞれ特定の細胞株と操作法である(Wessels:THP-1・Cas13・組合せ摂動、Norman:K562・CRISPRa・組合せ摂動、Replogle:K562・CRISPRi・単独摂動)。Wesselsでは、多くの摂動が同じ遺伝子(INTS1など)を共有するため、平均ベースラインが強い。共有する摂動を除く感度解析では、勝率が上がったが、結論は変わらなかった(Replogleは、単独摂動なので、この感度解析はない)。Replogleの分割は5回、他は10回である。
- 技術的な重複は、細胞を半分にするので、ノイズが大きく、MSEで平均ベースラインに不利になる。これは、Millerらの定義と同じ性質である。
- 上位50遺伝子と重みは、全細胞から作るので、真値と独立ではない。
- 1つの指標(Pearson)は、controlを予測とすると定義されないので0とした。
- 主解析の細胞分割と指標計算は変更していない。DRFの列、期待誤差からの探索的基準、ブートストラップ区間は、主結果を得た後の検討・査読で追加した。元の結果の値は追加前後で同じだった。
- 同じ分割・同じ細胞から、基準(平均ベースライン、上位遺伝子、重み)を作っているので、独立な検証ではない。別の実装(seed 777、20分割)でも、MSEの勝率0.801、Pearson(全遺伝子Δ)の勝率0.910と、同等の値が得られた(査読者による再計算)。
データとコードの公開
解析計画(と、他の2つのデータへの追記)、コード、結果、図の作成コードを、配布ZIPにまとめた(calibrated-metrics-audit.zip)。データは再配布せず、取得スクリプトと、取得時のSHA-256を同梱した。Wesselsは、python fetch_data.py && python analysis.py && python figures.py で再現できる(約219 MB、numpy、scipy、anndata、matplotlib、約3分、乱数のseed固定)。NormanとReplogleは、python fetch_data.py all(約0.7 GBと約1.5 GB)の後に、python analysis_stream.py data/raw/NormanWeissman2019_filtered.h5ad control norman と python analysis_stream.py data/raw/ReplogleWeissman2022_K562_essential.h5ad control replogle_essential 5 で再現できる(メモリを抑えた実装。Wesselsでも、python analysis_stream.py data/raw/WesselsSatija2023.h5ad control wessels_stream で、元の結果と一致する)。
参照
- Ahlmann-Eltze C, Huber W, Anders S. Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselines. Nature Methods. 2025;22(8):1657–1661. doi:10.1038/s41592-025-02772-6.
- Miller HE, Mejia GM, Leblanc FJA, Swain B, Wang B, de Lima Camillo LP. Deep learning perturbation models can outperform baselines on calibrated metrics. Nature Biotechnology. 2026 Oct 1. Published online. doi:10.1038/s41587-026-03307-w.
- Kumakura D. What did the Virtual Cell predict? Target genes and evaluation shortcuts. 2026 Oct 11. Article.
- Wessels HH, Méndez-Mancilla A, Hao Y, Papalexi E, Mauck WM, Lu L, et al. Efficient combinatorial targeting of RNA transcripts in single cells with Cas13 RNA Perturb-seq. Nature Methods. 2023;20(1):86–94. doi:10.1038/s41592-022-01705-x.
- Peidli S, Green TD, Shen C, Gross T, Min J, Garda S, et al. scPerturb: harmonized single-cell perturbation data. Nature Methods. 2024;21(3):531–540. doi:10.1038/s41592-023-02144-y.
- Peidli S, Green TD, Shen C, Gross T, Min J, Garda S, et al. scPerturb Single-Cell Perturbation Data: RNA and protein h5ad files [Dataset]. Version 1.4. Zenodo; 2022. doi:10.5281/zenodo.13350497.
- Norman TM, Horlbeck MA, Replogle JM, Ge AY, Xu A, Jost M, et al. Exploring genetic interaction manifolds constructed from rich single-cell phenotypes. Science. 2019;365(6455):786–793. doi:10.1126/science.aax4438.
- Replogle JM, Saunders RA, Pogson AN, Hussmann JA, Lenail A, Guna A, et al. Mapping information-rich genotype-phenotype landscapes with genome-scale Perturb-seq. Cell. 2022;185(14):2559–2575.e28. doi:10.1016/j.cell.2022.05.013.