2遺伝子の同時摂動は「足し算」でどこまで説明できるか:Norman 2019をノイズを除いて読み直す
2遺伝子同時のCRISPRa(Norman 2019、131組)で、同時摂動の発現変化のうち単独の変化の和で説明できない部分を、ノイズを除いて見積もった。中央値は9%で、大きく外れる組の多くは全体の大きさがずれるだけで、係数1つで説明できた。
On this page
製薬で知りたいのは、2つの標的を同時に動かしたときの細胞の応答であることが多い。併用療法の組み合わせや、合成致死の探索である。単独の摂動のデータから組み合わせの応答を予測するモデルも、次々に提案されている。GEARSはその代表例である(1)。
こうしたモデルの評価では、単独の摂動による発現変化を足しただけの「加法モデル」が、比べる相手(ベースライン)になることが多い。Ahlmann-Eltzeらは、深層学習のモデルが、加法モデルを含む単純な線形のベースラインをまだ上回らないと報告した(2)。では、加法モデルを超えて改善できる余地は、そもそもどれだけあるのか。
本記事では、2遺伝子の同時活性化の公開データ(Normanら、2019年(3))で、同時摂動の発現変化のうち足し算で説明できない部分を、細胞の抽出に伴うノイズを抑える推定量で見積もった。特定のモデルの性能は評価していない。
加法モデルを超えて改善できる余地
問い(QOI:question of interest): 2遺伝子のCRISPRaで、同時摂動の発現変化のうち、単独の変化の和で説明できない成分(非加法的な成分)は、ノイズを除くとどれだけあるか。
使いみち(COU:context of use): 組み合わせ摂動の予測モデルの評価を読むときの物差し。今回の測定・細胞分割条件で加法モデルと比較する目安にする。特定のモデルの性能は評価しない。
データ
Normanらは、白血病細胞株K562で、単独と2遺伝子同時の遺伝子活性化を行い、1細胞ずつRNAを測った。活性化には、CRISPRの仕組みで標的遺伝子の転写を高めるCRISPRaを使った。1細胞ずつRNAを読む方法はPerturb-seqと呼ばれる。本記事では、scPerturbの公開版(4)(CC BY 4.0、登録不要)を使った。 - 111,445細胞。 - 単独の摂動105種、2遺伝子の摂動131組、対照11,855細胞。 - 131組すべてで、2つの遺伝子の単独摂動もある。
方法
発現変化: 1. 各細胞のカウントを総数10,000に揃え、log1p(1を足して自然対数を取る変換)をかけた。 2. 全細胞の10%以上で検出された7,812遺伝子を使った。 3. 摂動ごとに細胞の平均を取り、対照の平均との差を発現変化とした。
加法の予測: 遺伝子Aの単独の変化と、Bの単独の変化の和を、AとBの同時摂動の予測とする。足し算は対数をとった値の上で行う。発現量そのもので足すなど、別の定義を使うと、結果は変わりうる。
ノイズを除く工夫: - 同時摂動の細胞を、乱数で無作為に3つに分けた。乱数シードを固定し、同じ分け方を再現できるようにした。 - 1つ目で、変化の大きい上位50遺伝子を選んだ。同じ細胞で選んで評価すると、ノイズで大きく見えた遺伝子を選んでしまうためである。 - 活性化した標的遺伝子AとB自身は、評価から除いた。標的自身の大きな変化が指標を支配しないようにするためである(最初の計算の後に見直して変更した。変更前後の値は後述)。なお131組のうち97組では、標的の少なくとも一方が、もともと7,812遺伝子に入っていなかった。 - 残りの2つを、重複しない細胞からなる二つの観測として使った。同じ実験内の分割であり、独立した生物学的反復ではない。
非加法的な成分の割合F: - 計算: 2回の観測それぞれと加法の予測とのずれを掛け合わせ、変化そのものの大きさ(2回の観測の積)で割った。 - ノイズの扱い: 各分割の誤差が平均ゼロで互いに独立なら、誤差を掛け合わせた項の期待値はゼロになる。そのため、ノイズで大きく見える分を除いて、本当のずれの大きさを見積もれる。 - 読み方: Fが0なら完全に足し算で、0.2なら発現変化の二乗ノルムを基準にした非加法成分が2割である。遺伝子の2割が変わるという意味ではない。 - 注意: Fは推定値なので、0〜1の外に出ることがある。ずれが変化そのものより大きければ1を超え、ノイズで負になることもある。
係数を掛けた加法: - 係数1つ: 足し算の予測に係数cを1つ掛けた。cは1つ目の分割で推定し、評価に使う2回の観測とは独立にした。cが1より小さければ足し算より弱く、1より大きければ強い。 - 係数2つ: Normanらと同じく、AとBの変化に別々の係数を掛ける形(c1 × Aの変化 + c2 × Bの変化)も計算した。係数1つの形は、これのc1 = c2の場合にあたる。Normanらは、この2つの係数などをもとに、組み合わせを相乗・抑制・一方の優位などの型に分類している(3)。本記事は、その分類を量の側から見直したものである。
評価の指標: 加法の予測の当たり具合を、R²(決定係数)でも示した。R²は、変化の大きさのうち予測で説明できた割合で、1なら完全な予測になる。ここでは変化そのものの二乗和に対する割合で計算した。遺伝子間平均を引いた分散を分母にする通常の中心化R²とは区別する。
事前の計画と事後の追加: 解析計画は計算前に固定した。結果を見た後に加えたものは次のとおりである。 - 単独摂動側のノイズによる偏りの補正。 - cの要約。 - 組み合わせごとの解釈(CEBPEを含む組など)。
足し算で説明できない部分は中央値で見ると小さい
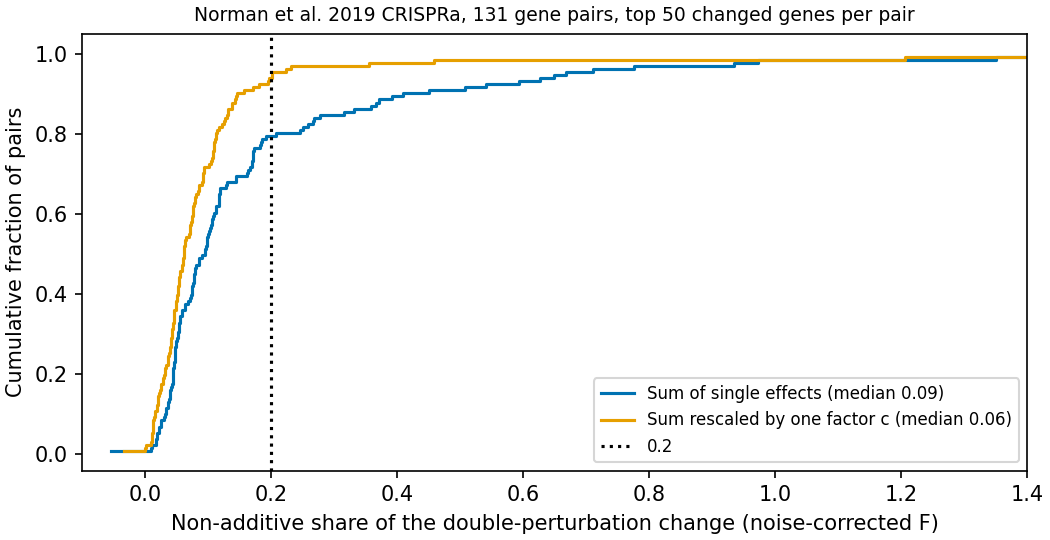
図1は、131組のFの累積分布である。青が足し算の予測、橙が係数を1つ掛けた予測を表す。
表1.非加法成分と加法予測の要約。
| Metric, top 50 genes excluding targets | Value |
|---|---|
| Median F, interquartile range | 0.09 (0.05–0.17) |
| Pairs with F >0.2 | 27 (21%) |
| Median F after one coefficient | 0.06 |
| Pairs with F >0.2 after one coefficient, among all 131 | 8 |
| Median F after two coefficients, Norman form | 0.05 |
| Median F after single-perturbation noise correction, post hoc | 0.08 |
| Median additive R², including noise | 0.89 |
| Median R² between two observation groups | 0.96 |
事前に決めた判断の規則は「中央値が0.2未満なら、加法モデルを超える余地は小さい」だった。結果は、この「余地は小さい」側に入る。
R²で見ても、加法の予測は0.89だった。同じ組み合わせの細胞を二つに分けたときの一致度は0.96である。この差が、加法モデルを超えて改善できる幅の目安になる。
標的遺伝子を除く前後: 最初の計算では、標的A・B自身が評価に入っていた。除いて計算し直した結果は次のとおりで、主な結論は変わらなかった。 - Fの中央値:0.090 → 0.094 - F > 0.2の組:27組 → 27組 - 係数1つを掛けたFの中央値:0.047 → 0.061。係数の推定を1つ目の分割に変えたことも影響している。
設定による感度: - 細胞の分け方(乱数シード)を変える(主解析を含め4通り): Fの中央値は0.08〜0.09。 - 評価する遺伝子の数を変える: 上位20遺伝子で0.09、上位200遺伝子で0.09。 - 2回の観測の一致が低い3組(R² < 0.5)を除く: 中央値0.09。 - 7,812遺伝子すべて: 0.21と大きくなった。ただしこの値には、単独摂動側のノイズによる偏りが含まれる。単独摂動の細胞を半分にするとFが大きくなったので、その差から偏りを除いた(結果を見た後の補正)。補正後は0.13だった。変化の小さい遺伝子まで含めると、足し算で説明できない部分はやや増える。
大きくずれる組み合わせの多くは全体の大きさがずれる
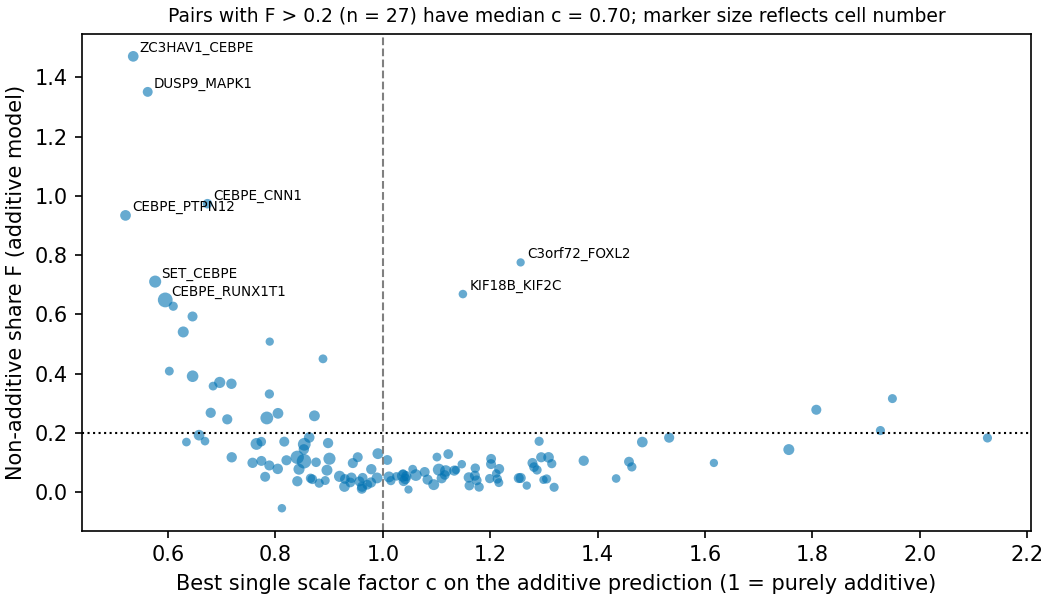
図2は、横軸に係数c、縦軸にFをとり、131組を並べたものである。点の大きさは細胞数を表す。
Fが0.2を超えた27組を、Fの大きい順に挙げる。
表2.Fが0.2を超えた27組の内訳。
| Pair | Cells | F | c | F after one coefficient | R² between observation groups |
|---|---|---|---|---|---|
| ZC3HAV1 + CEBPE | 410 | 1.47 | 0.54 | 0.106 | 0.91 |
| DUSP9 + MAPK1 | 290 | 1.35 | 0.56 | 0.121 | 0.81 |
| CEBPE + CNN1 | 237 | 0.97 | 0.67 | 0.223 | 0.92 |
| CEBPE + PTPN12 | 415 | 0.93 | 0.52 | 0.090 | 0.95 |
| C3orf72 + FOXL2 | 59 | 0.78 | 1.26 | 1.825 | 0.50 |
| SET + CEBPE | 658 | 0.71 | 0.58 | 0.113 | 0.99 |
| KIF18B + KIF2C | 96 | 0.67 | 1.15 | 1.205 | -0.16 |
| CEBPE + RUNX1T1 | 1219 | 0.65 | 0.59 | 0.041 | 0.99 |
| CEBPE + CEBPA | 180 | 0.63 | 0.61 | 0.015 | 0.97 |
| MAP2K6 + SPI1 | 302 | 0.59 | 0.65 | 0.124 | 0.94 |
| CEBPE + KLF1 | 468 | 0.54 | 0.63 | 0.202 | 0.96 |
| CEBPB + CEBPA | 64 | 0.51 | 0.79 | 0.107 | 0.87 |
| CDKN1B + CDKN1A | 134 | 0.45 | 0.89 | 0.232 | 0.88 |
| IGDCC3 + PRTG | 140 | 0.41 | 0.60 | 0.001 | 0.81 |
| MAP2K3 + MAP2K6 | 571 | 0.39 | 0.65 | 0.025 | 0.95 |
| MAPK1 + PRTG | 500 | 0.37 | 0.70 | 0.196 | 0.97 |
| IGDCC3 + MAPK1 | 368 | 0.37 | 0.72 | 0.142 | 0.95 |
| CDKN1C + CDKN1A | 126 | 0.36 | 0.68 | -0.001 | 0.91 |
| LYL1 + CEBPB | 192 | 0.33 | 0.79 | 0.172 | 0.93 |
| FEV + CBFA2T3 | 159 | 0.32 | 1.95 | 0.156 | 0.96 |
| PTPN12 + UBASH3A | 311 | 0.28 | 1.81 | 0.117 | 0.97 |
| PTPN12 + OSR2 | 339 | 0.27 | 0.68 | 0.091 | 0.86 |
| FOSB + UBASH3B | 426 | 0.27 | 0.80 | 0.130 | 0.92 |
| ETS2 + IGDCC3 | 441 | 0.26 | 0.87 | 0.180 | 0.95 |
| UBASH3B + OSR2 | 796 | 0.25 | 0.78 | 0.138 | 0.95 |
| CEBPB + PTPN12 | 331 | 0.25 | 0.71 | 0.076 | 0.94 |
| CNN1 + UBASH3A | 178 | 0.21 | 1.93 | 0.195 | 0.95 |
(cと「F after one coefficient(係数1つを掛けたF)」は1つ目の分割で推定したcを使う。細胞の少ない組や変化の小さい組では、係数を掛けたFの方が大きくなることがある:C3orf72 + FOXL2、KIF18B + KIF2C。)
係数cの向き: - 足し算より弱い組: 27組のうち22組でcが1未満だった(cの中央値0.70、事後の要約)。変化の向き(どの遺伝子が上がり、どれが下がるか)は足し算とほぼ同じで、大きさが弱まっている形である。2つの係数で見ると、CEBPEを含む上位の組では、CEBPE側の係数だけが小さかった(例:ZC3HAV1 + CEBPEでは、ZC3HAV1側0.96、CEBPE側0.46)。全体が一様に弱まる形のほか、一方の摂動の寄与が弱まる形(Normanらの分類の「一方の優位」に近い)も含まれる。 - 足し算より強い組: FEVとCBFA2T3、PTPN12とUBASH3A、CNN1とUBASH3Aの3組は、cが1.8を超えた。 - 係数を掛けても残る組: 27組のうち5組は、係数1つを掛けてもFが0.2を超えたままだった。一方、もともと0.2以下だった3組は、係数を掛けると0.2を超えた(131組全体で8組)。C3orf72 + FOXL2(59細胞)では、係数を掛けたFが1.83と、足し算のまま(0.78)より悪くなった。細胞の少ない組では、係数の推定そのものが不安定になる。
細胞数が少ないか分割間の一致が低い組: KIF18BとKIF2Cの組は、重複しない2分割の観測どうしのR²が−0.16で、変化そのものがほとんど測れていない。C3orf72とFOXL2は細胞が59と少なく、2回の観測の一致も0.50だった。変化が小さい組や細胞の少ない組では、Fの値は信頼できない。
CEBPEを含む組(探索的な観察): 27組のうち7組がCEBPEを含んでいた。CEBPEは顆粒球への分化に関わる転写因子で、単独でも大きな変化を起こす。相手と組み合わせると、その変化が弱まる傾向があった。ただしこれは、相互作用のほかに、ガイドの効き方の違いや、細胞の構成(分化の段階の割合)の変化でも説明できる。本解析では区別していない。
131組全体のc: 中央値は0.99(四分位範囲0.82〜1.19)で、0.8未満の組は22%だった。組全体で見ると、足し算より弱い組と強い組の両方がある。
予測モデルの評価をどう読むか
加法モデルは強いベースラインである: 中央値で見ると、足し算は変化の9割程度を説明する。組み合わせ予測モデルが「加法モデルより良い」と報告していても、その差は、残りの部分の中での改善である。改善の幅を、細胞を分割したときの一致度と並べて示すとよい。
改善の余地の多くは、大きさにある: 足し算から大きく外れる組み合わせの多くは、変化の向きは足し算どおりで、大きさがずれていた。全体が一様に弱まる形と、一方の寄与が弱まる形がある。係数1つでも多くが説明できた。モデルに求められるのは、まず「どの組み合わせで、全体の大きさがどれだけ変わるか」を当てることである。この点は、Normanらが2つの係数で組み合わせを分類した見方とも合う。
評価の指標は、ノイズと遺伝子の選び方で変わる: 次のような評価では、非加法的な成分が大きく見える。評価に使う遺伝子の選び方と、ノイズの補正を明記する必要がある。 - 同じ細胞で遺伝子を選んで評価する。 - 全遺伝子で評価する。 - 標的遺伝子自身を含めて評価する。
限界
- 一般化: CRISPRa以外(ノックアウト、阻害剤、薬剤の併用)や、他の細胞種に当てはまるかは分からない。CRISPRaでは、活性化の強さがガイドによって違い、同時摂動では1つずつの活性化が弱まることもありうる。
- 組の選び方: 131組は、Normanらが相互作用を見るために選んだ遺伝子の組であり、無作為な組み合わせではない。
- 加法の定義: 足し算は、対数をとった発現の上で行った。cが1より小さいことは、発現の飽和のような技術的な理由でも起こりうる。
- 扱っていない表現型: 細胞の増殖や生存(合成致死など)は扱っていない。扱ったのはRNAの発現変化だけである。
- 細胞数: 細胞が少ない組(最少54細胞)では、3分割後の各群は18細胞で、推定の不確かさが大きい。組ごとの信頼区間は計算していない。
実装の確かめ
- 独立の再実装: 12組について、別のコード(scanpyによる正規化と、密行列での平均)で計算し直した。Fは小数第5位まで一致した。細胞の分け方は同じ規則で書き直したため、分け方そのものの誤りは、この検証では検出できない。
- 単体の検査: 合成データで、次の4点を確かめた。
- ノイズがFを膨らませないこと。
- 非加法的な成分の割合を回復できること。
- 細胞の分け方が正しいこと。
- 完全に加法的なデータでFが0、cが1になること。
- 再現性: 同じ乱数シードで再実行すると、結果のファイルがバイト単位で一致した。入力はSHA-256で固定した。
データとコードの公開状況
再実行:python acquire.py && python test_analysis.py && python analysis.py && python figures.py && python validate.py(Python 3.12、anndata、scanpy、numpy、scipy、pandas、matplotlib、requests)。
解析計画・コード・入力の取得手順とチェックサム・結果・検証結果は配布資料に含めた(配布資料)
参照
- Roohani Y, Huang K, Leskovec J. Predicting transcriptional outcomes of novel multigene perturbations with GEARS. Nature Biotechnology. 2024;42(6):927-935. doi:10.1038/s41587-023-01905-6.
- Ahlmann-Eltze C, Huber W, Anders S. Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselines. Nature Methods. 2025;22(8):1657-1661. doi:10.1038/s41592-025-02772-6.
- Norman TM, Horlbeck MA, Replogle JM, Ge AY, Xu A, Jost M, et al. Exploring genetic interaction manifolds constructed from rich single-cell phenotypes. Science. 2019;365(6455):786-793. doi:10.1126/science.aax4438.
- Peidli S, Green TD, Shen C, Gross T, Min J, Garda S, et al. scPerturb: harmonized single-cell perturbation data. Nature Methods. 2024;21(3):531-540. doi:10.1038/s41592-023-02144-y. Data: Zenodo, CC BY 4.0.