Virtual Cellに何を測らせるか。Biohub構想とデータの作り方
同じ28,800細胞を測定条件・ドナー・各側の細胞数へ配分する合成例。未測定条件の補完、独立反復、試料調製の負担を分け、予測したい介入からデータ生成を設計する。
On this page
背景と目的
「もっと多くの細胞を測れば、細胞への介入を予測できるようになる」。この期待に、測定を始める側から一つ問いを加えたい。増やすのは、同じ条件の細胞数か、独立したドナーか、それともまだ測っていない条件の組合せか。
2026年10月7日、BiohubはVirtual Biology Initiativeの拡張を発表した。DOE・NIHなどとの連携で、介入への細胞応答を予測するモデルの基盤となるデータと測定技術を整備する構想である。共有標準、共通識別子、データへのアクセスも計画に含まれる (1, 2)。
これは、普遍的な細胞モデルが完成したという報告ではない。モデルのためのデータを大規模に作る段階だからこそ、何を測るかという設計が重要になる。本記事では、同じ28,800細胞を四通りに配分する合成例を作った。Biohubの実データや予算を再現する解析ではなく、訓練データを作る前に比較したい選択を具体化する計算である。
予測したい条件を測定計画の表にする
例えば、ある摂動のRNA応答を、複数の細胞背景と時点で知りたいとする。今回の予測対象は、4背景×6摂動×3時点の72通りについて、処置と対照の差をドナー集団で平均した値とした。72条件を同じ重みで評価する。
細胞一つの将来や、新しい患者個人の応答を当てる課題ではない。また、RNAの平均差が分かっても、タンパク質機能や疾患の改善が分かるとは限らない。別のモダリティを足す必要があるなら、その測定も計画の軸に置く。ただし本計算は一つの応答量に絞り、モダリティ追加の効果を測ってはいない。
この表を書いておくと、「何万細胞あるか」とは別に、どの条件を実測したか、どのドナーに対応するか、どこがモデルによる補完かを記録できる。新しい背景や摂動の種類への汎化を調べたい場合は、その軸を別途保持する必要がある。今回、背景・摂動・時点の各水準は全て学習側にあり、未測定なのはその組合せだけである。
同じ細胞数を深さ・広さ・反復へ配分する
四つの設計を固定した。表の細胞数は、各条件・各ドナーの処置側または対照側の一方に回収する数である。総数には両側を数えた。
表1. 同じ総細胞数を四通りに配分する設計。
| Design | Measured combinations | Donors | Cells per arm | Total cells including both arms |
|---|---|---|---|---|
| Depth | 18 | 2 | 400 | 28,800 |
| Breadth | 72 | 2 | 100 | 28,800 |
| Replication | 36 | 8 | 50 | 28,800 |
| Balanced | 72 | 4 | 50 | 28,800 |
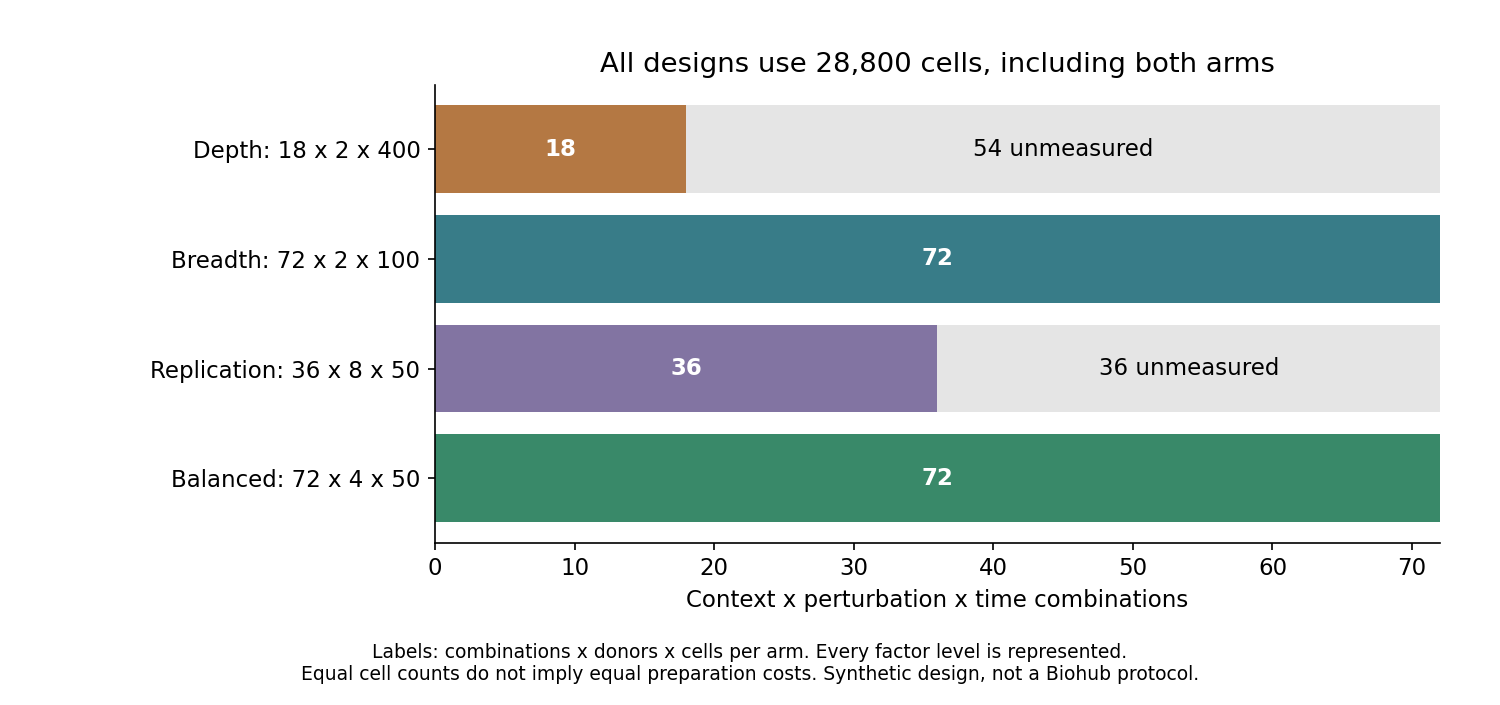
図1.灰色は未測定の組合せ。全設計に全ての背景・摂動・時点が含まれるので、ある摂動を一度も測らないために予測できない、という比較ではない。図のラベルは組合せ数×ドナー数×一方の細胞数を表す。実際の費用が等しいことを示した図ではない。
18条件を選ぶ設計にも、背景・摂動・時点の加法的な効果を推定できる組合せを入れた。実装では各設計の加法モデル行列が11列のフルランクであることを確認している。ただし、各水準を一度以上測っていることや、行列がフルランクであることだけでは、条件固有の応答まで分かるとは言えない。
細胞数で減らせる誤差と残る誤差
各条件の応答を、ドナーごとの処置・対照差から推定する。ドナー×条件の応答差の標準偏差を \(\tau\)、各側の細胞ノイズの標準偏差を \(\sigma\) とした。ドナー数を \(D\)、各側の細胞数を \(c\) とすると、直接平均の分散は
\[ \operatorname{Var}(\widehat{\Delta}) =\frac{\tau^2}{D}+\frac{2\sigma^2}{Dc} \]
になる。両側の細胞を独立に測るため、細胞ノイズの項には2が付く。\(c\) を増やして小さくできるのは第二項であり、同じドナーを深く測っても第一項は残る。
例えば \(\tau=\sigma=1\) の仮定で、2ドナー・各側50細胞の直接平均の標準誤差は0.721。各側400細胞へ8倍に増やしても0.709である。一方、4ドナー・各側50細胞なら0.510になる。これらは実測された生物学的な誤差ではなく、仮定から計算した応答単位の値である。
逆に、ドナー差がない設定では細胞数を増やす価値が相対的に大きい。全ての実験で「細胞よりドナーを増やせ」と結論することはできない。その判断には、先行データでドナー差、測定ノイズ、細胞型ごとの回収数を分けた推定が必要になる。
今回の式は、異なる条件のドナー応答差も独立と置いている。同じドナーを複数条件で使う実験で、応答が条件間に相関するなら、予測の共分散も変わる。この仮定は実験計画に戻したときに確認が必要だ。
未測定の組合せはどの仮定で埋めるか
真の平均応答を、背景・摂動・時点の加法成分に、条件固有の非加法成分を足して作った。例えば、ある摂動が特定の背景の遅い時点でだけ効くような、各軸の足し算では表せない応答を考える。ただし今回のパターンは実際の現象から推定したものではない。非加法成分は固定乱数で生成し、加法成分と直交させ、全72条件での二乗平均平方根を1に揃えている。その強さ \(\lambda\) を0、0.5、1、2と変えた。真値を使って設計を選び直してはいない。全比較で細胞ノイズの標準偏差 \(\sigma=1\) を固定した。
推定の規則も全設計で同じにした。実測した組合せには、その条件の直接平均を使う。未測定の組合せだけを、実測条件から最小二乗で推定した加法モデルで補完する。これは説明用の単純な規則で、基盤モデルを訓練した比較ではない。
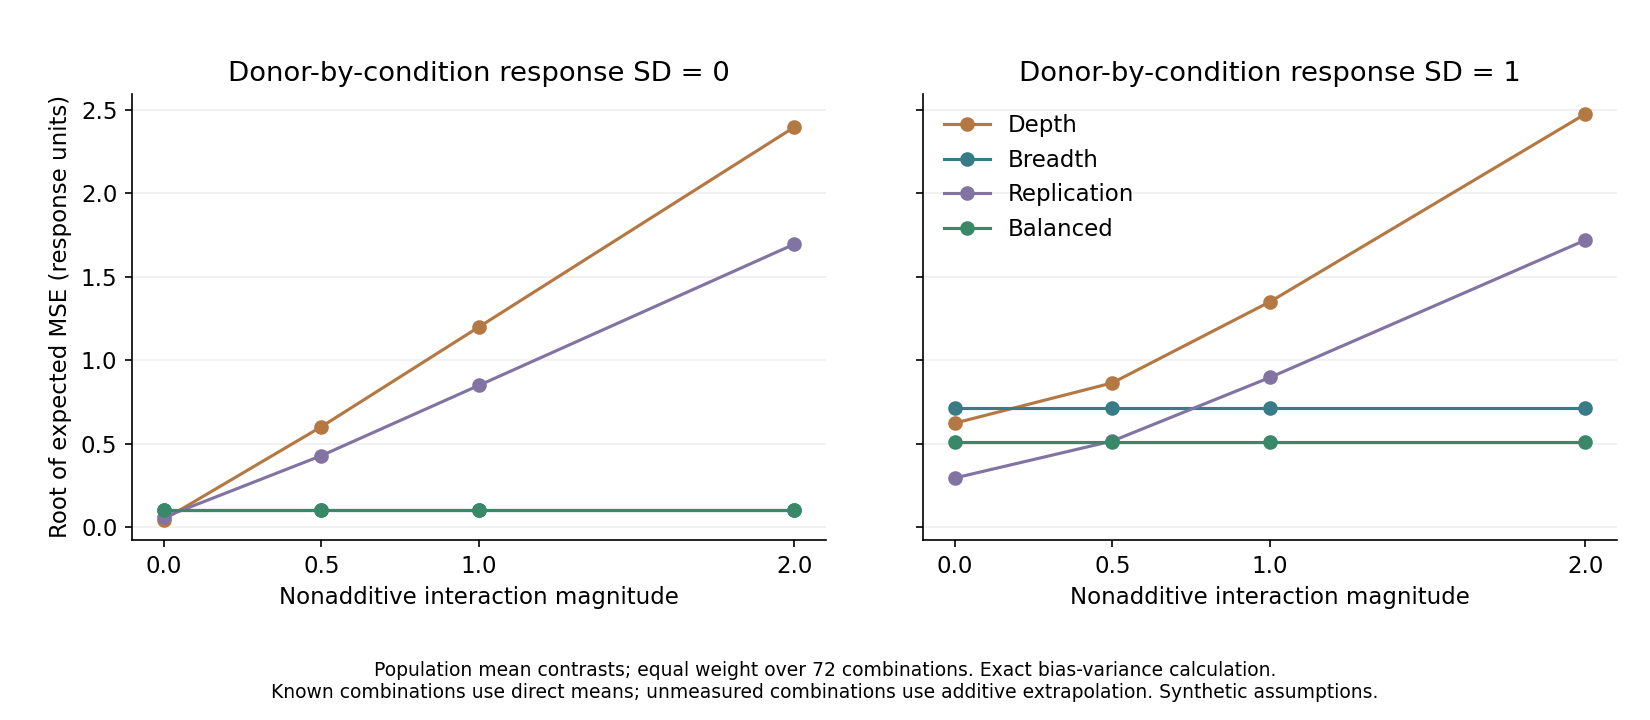
図2.縦軸は全72条件の期待二乗誤差を平均してから平方根を取った値で、誤差のバイアスと分散を厳密に計算した。独立な実験で得た生物学的な信頼区間ではない。左のBreadthとBalancedは値が同じで線が重なる。
表2. ドナー差を固定した場合の設計別期待誤差。
| Design | No nonadditive component, \(\lambda=0\) | Nonadditive component present, \(\lambda=1\) |
|---|---|---|
| Depth | 0.622 | 1.350 |
| Breadth | 0.714 | 0.714 |
| Replication | 0.294 | 0.896 |
| Balanced | 0.510 | 0.510 |
加法仮定が正しい場合、36条件を8ドナーで測る設計は、未測定条件を他の条件から効率よく補完し、この四案で最も小さい誤差になった。しかし、非加法成分があると、測っていない組合せの補完にバイアスが入る。\(\lambda=1\) では、72条件を4ドナーで測る設計の誤差が最も小さくなった。
BreadthとBalancedの線が水平なのは、全条件を直接測る推定規則なので、非加法成分を補完する必要がないからだ。どんなモデルでも条件を増やせばこの性能になる、という意味ではない。全条件のデータがあっても、加法モデルだけで全てを予測する規則なら、非加法成分の誤差は残る。
2,000回の合成実験も生成し、厳密な期待二乗誤差と乱数で得た平均を照合した。四設計×三つのドナー差×四つの非加法強度の48設定で、差は最大でもモンテカルロ平均の標準誤差の約1.53倍だった。これは実装の確認であり、仮定の生物学的な検証ではない。
今回の順位は、固定した一つの非加法パターン、四設計、同じ推定規則、均等な評価重みの結果である。未測定条件だけの誤差は配布表に別記し、未測定条件がない設計では未定義とした。実測条件を含む全条件の得点を、未知条件への汎化得点と呼ばない。特定の細胞背景が使用目的の大半を占めるなら、重みから設計し直す必要がある。
同じ28,800細胞でも試料調製の負担は違う
各条件・ドナー・処置側/対照側を一つずつ数えると、試料数はDepthが72、Breadthが288、ReplicationとBalancedが576となる。ここでは共通対照やプーリングを使わない計数であり、実際のライブラリー数を一般化したものではない。
仮に、試料一つの調製に「100細胞を測るのと同じ費用」が加わると置けば、細胞と試料を合わせた費用は順に36,000、57,600、86,400、86,400細胞相当になる。価格表ではなく、固定費があるだけで同じ細胞数の設計を同予算とは呼べなくなる、という感度分析である。固定費を0・25・100・400とした表も配布した。
実際にはドナーの取得、培養・摂動の成功率、組織や細胞型の回収、マルチモーダル測定、装置稼働、品質管理を費用へ入れる。今回の計算は金額で固定した予算の最適化を解いていない。
考察
Biohub構想で重要なのは、データの量に加えて、介入を測れる技術と、測定を結び付ける基盤を整備する点だ。4月の立ち上げでも、分子・空間・動的な次元の測定を広げる方針が示されていた (3)。
本計算では、深く測ることで小さくなるノイズ、ドナーを増やすことで小さくなるばらつき、条件を増やすことで避けられる補完のバイアスを分けた。どれが律速かによって、同じ細胞数でも予測誤差が異なった。
ただし、これは固定した仮想条件の比較であり、Biohubの実測データに対する最適配分を推定したものではない。細胞背景、摂動、時点、ドナーの組合せを欠く条件は、測定済み条件の細胞数だけでは埋まらない。
データとコードの公開状況
解析コード・設定・集計表・独自図をダウンロード。PythonとNumPyで計算・10件のテストを実行でき、図の再描画にはMatplotlibを使う。
全入力は独自の合成設定で、実データ、原著図、第三者コード、Biohubの内部計画は含まない。設定、乱数、推定対象、未測定条件の定義、費用の仮定は REPRODUCE.md とコードに記録した。結果は実験設計の考え方を示すもので、実際の基盤モデルの性能、最適なドナー数、臨床的な有用性を検証したものではない。
参照
- Biohub. International, cross-sector collaboration commits nearly $2 billion to build foundational data for AI models to predict and treat disease. 2026 Oct 7. Announcement.
- US Department of Energy. DOE, NIH, and Biohub Partner to Build Foundational Data for Predictive Biological Super Intelligence Models. 2026 Oct 7. Announcement.
- Biohub. Biohub Launches the Virtual Biology Initiative to Galvanize a Global Effort to Create the Open Data Foundation for AI-Accelerated Biology. 2026 Apr 29. Announcement.