AI創薬のボトルネックはどこにあるか
AI創薬の実験接続、公開業績、臨床移行を点検し、実験量と開発判断に使える証拠を区別する。
Summary in English
Where are the bottlenecks in AI-enabled drug discovery?
A Japanese essay reviewing experimental workflows, industry disclosures and clinical progress. It distinguishes experimental throughput from evidence useful for development decisions; revenue growth and individual clinical advances do not establish an AI-driven supply shortage or a causal improvement in clinical success.
On this page
文献・公開資料の確認日:2026年10月6日。2026年の動向を、ボトルネックの移動から考える。
AI創薬について気になるのは、どのモデルが最も賢いかより、ある工程が速くなったとき、開発全体では何が次の制約になるのかという問いである。
分子を大量に提案できても、全部を作って試すことはできない。実験を高速化しても、その測定が患者での有効性を予測するとは限らない。臨床試験の登録や運営の待ち時間を減らしても、病態や長期安全性を観察する時間まで同じように短縮できるわけではない。
私の見方は、AI創薬で重要性が増しているのは、候補を生む能力に加え、実験結果を開発の判断に使える証拠へ変える能力だ、というものである。これは産業全体で実験設備が不足している、という断定とは違う。公開資料で確認できる変化と、そこから考えられる仮説を分けて見たい。
1. AIは、設計から実験への接続を進めている
2026年には、生命科学へ直接取り組むAI開発組織の動きが目立った。OpenAIは4月にGPT-Rosalindを発表し、9月に対象組織向けの提供を拡大した。Microsoft Researchは9月29日にQuineを発表し、生物学の予測モデルと研究を進める仕組みを組み合わせる構想を示した。いずれも、薬の臨床的成功を証明する発表ではない。OpenAI、Microsoft Research
実測に接続した例として、Anthropicは8月、Claudeと専門的なタンパク質設計ツールを組み合わせた実験を報告した。複数の設定を合わせた1,320設計から、15標的中14標的に対する354のbinder、つまり標的へ結合するタンパク質が得られた。単純な合算では26.8%だが、これは一つのモデル・一つの48時間実行の成績ではない。設定別の成績も異なる。Anthropicの実験報告、技術報告
AdaptyvのTREM2設計イベントでも、人間が設計ツールを運用する10チームと、自律エージェント6チームが候補を提出し、計算上の順位で選んだ100候補を実験した。結合は37件で、人間側25/65、エージェント側12/35だった。差が明確でなかったことを、両者の能力が一般に同等だと読むことはできない。標的は一つで、実験対象は全141候補から選別されている。Adaptyvの結果と選別条件
この二つの例から支持できるのは、限定された設計課題でエージェントが実験で結合を確認できる候補を作れる、という点である。結合、機能、体内動態、安全性、患者での便益は、それぞれ検証すべき別の段階になる。
ここで紹介した実験は主にタンパク質・抗体設計であり、その成績を低分子、RNA、細胞治療などの設計全体へ外挿することはできない。また、標的へ作用できることと、その標的への介入がヒトの疾患を改善することは別の問いである。前臨床リードが得られた後も、製造・製剤・品質や非臨床安全性などの検証が残る。
さらに10月2日、XairaはX-Designによる抗体設計の二つの事例を公表した。一つは標的への結合だけでなく、選択性、種間交差反応性、開発に必要な物性を評価し、7週間で前臨床リードへ進めたという報告である。ただし、抗原・試薬や狙うエピトープは事前に用意されていた。これは標的探索から臨床までの7週間ではなく、研究主体による限られた事例の報告でもある。「結合した」から「次の開発へ進める」へ、評価の焦点が移る例として読みたい。Xairaの10月2日の報告
2. 速い設計は、開発全体をどこまで速くするか
創薬の反復を、Design–Build–Test–Learn、すなわち設計・作製・測定・学習のループとして見ると、計算の改善が届く範囲を考えやすい。
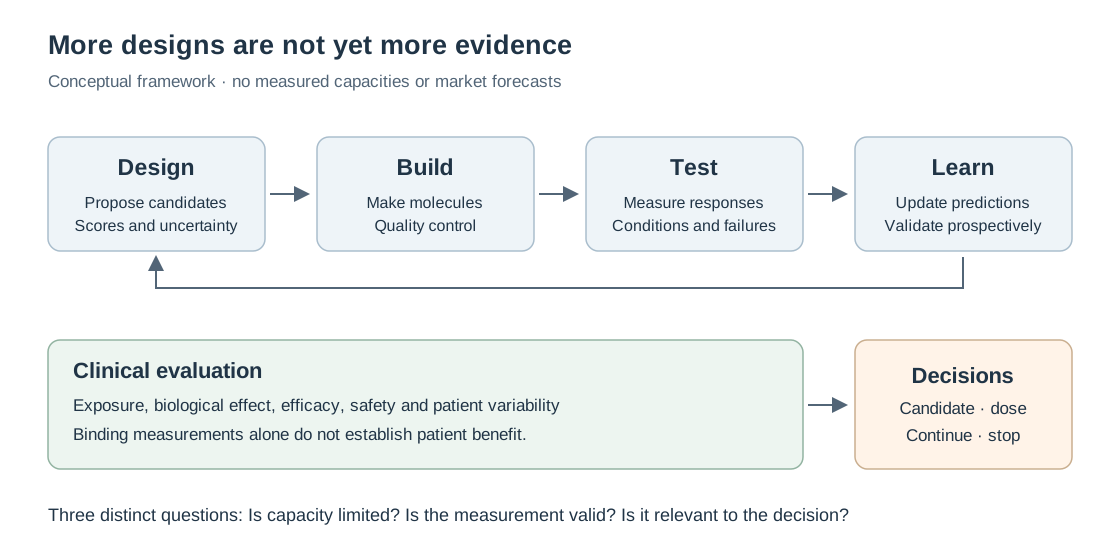
図1:筆者作成の概念図。工程ごとの処理量は異なるため、単純な処理速度の大小を描いたものではない。設計スコアから、実測、臨床的な証拠へ進むには別の検証が必要になる。
設計を速くすると、作製や測定の待ち時間が相対的に目立つ場合がある。ただし、候補の選別が良くなれば、必要な実験数が減ることもある。自動化、並列実行、工程の重なりによっても、制約の位置は変わる。
したがって、「AIが強くなるほど実験需要は必ず増える」とは言えない。産業動向として検証したいのは、設計数そのものより、同じ予算・期間で、次の開発判断をどれだけ改善できたかである。
同じ品質の候補をより少ない費用・時間で得られることや、従来は探索できなかった標的に候補を得ることにも価値がある。その局所的な価値と、開発全体の成功率を改善したという主張は、異なる比較条件で評価すべきだ。
9月のNature CommunicationsのPerspectiveも、生成化学では活性だけでなく、薬物動態や安全性を含む複数の目的をどう両立するかを論じている。評価関数が一つだけ良くても、開発可能な候補へ近づいたとは限らない。Torren-Peraire et al.
3. 決算から実験需要の変化をどこまで読めるか
実験需要の増加という仮説を確かめるため、合成、実験、装置、研究受託に関わる公開決算を調べた。以下は同じ市場を測る統計ではなく、変化の幅を確認するための個別例である。
| 対象 | 対象期間・範囲 | 公表された変化 | 解釈で注意する点 |
|---|---|---|---|
| Twist Bioscience | 2026年度第3四半期、6月30日までの全体売上 | 1億1,840万ドル、前年同期比+23% | 売上全体であり、AI向け実験の数量ではない |
| GenScript Life Science Group | 2026年上期の部門売上 | 3億1,900万ドル、+28.8% | グループ全体の比較可能ベース+27.3%とは範囲が異なる |
| Tecan | 2026年上期、全体売上の現地通貨ベース | +3.4% | 為替調整後の指標。AI関連売上だけを分離していない |
| Revvity Life Sciences | 2026年第2四半期、pro forma organic売上 | −3% | 事業範囲・為替等を調整した指標 |
| Charles River DSA | 2026年第2四半期、Discovery and Safety Assessment部門 | 報告売上−1.9%、organicでは+0.2% | 事業売却・為替調整で見え方が変わる |
| Evotec | 2026年上期、全体売上 | 3億100万ユーロ、−19.2% | 提携収益の計上時期なども影響する |
出典:Twistの決算、GenScriptの決算説明、Tecanの上期決算、Revvityの四半期決算、Charles Riverの決算、Evotecの上期報告。
この表を、成長率の順位表やAIの恩恵を受ける企業の順位としては使えない。期間、事業、調整方法が違うからだ。一方、実験・研究サービスがすべて同じ方向へ伸びているわけではないことは分かる。
逆に、全体売上が減っていることも、特定の実験や地域で供給制約がないという証拠にはならない。全体の成長と、局所的な待ち時間や不足を分けて確かめる必要がある。
GenScriptはAI創薬関連事業が前年同期から倍増したとも説明している。AI向け需要の存在を示す報告としては重要だが、同事業の売上額や範囲をここから完全には再構成できない。また、売上増加だけでは供給不足を示せない。価格、製品構成、顧客獲得、外注への移行でも売上は増える。
供給制約を主張するなら、納期、稼働率、受注残、実験単価、断った案件、増設後の待ち時間といった情報が必要になる。今回確認した資料だけでは、AIが原因の産業全体の供給不足までは立証できない。
4. 実験のAPI化とデータの蓄積は、何を変えるか
Adaptyvは4月、標的の照会、実験の注文、費用見積もり、状態確認、構造化結果の取得を可能にするAPIを発表した。これはモデルの出力を実験へ渡し、測定を次の設計へ戻す手間を減らす方向にある。ただし、APIがあることと、実験が無人・即時に完了することは同じではない。Adaptyv APIの発表
データを作る規模も増している。Illuminaは7月、Billion Cell Atlasで3億5,000万超の細胞を測定し、6ペタバイト超のデータを生成したと報告した。これは進捗の報告であり、名称にある10億細胞がすでに完成したという意味ではない。Lilaも8月、95万のRNA配列を物理的に合成し、細胞で測定した独自データについて説明している。後者は研究主体の発表であり、全データが独立に検証できる形で公開されたことまでは示さない。Illumina、Lila
共有の仕方にも変化がある。Lilly TuneLabは、参加者がモデルを利用し、分子情報を直接共有せずに学習へ貢献するfederated learningの仕組みを説明している。これはデータの持ち方を工夫する例であって、誰でも全学習データを使えるという話ではない。TuneLabの説明
ここで私が重視したいのは、データ量より、その意味を再現できるかである。例えば、タンパク質の実験で「結合しなかった」と記録された候補が、本当に非結合なのか、そもそも発現しなかったのかでは、次のモデルへ渡す情報が変わる。
TREM2の例では100件中、結合37件、非発現11件、非結合52件だった。この区別は、残り63件をまとめて同じ負例にするより有用である。ただし非結合にも、濃度範囲や検出限界などの条件が付く。測定値、失敗の理由、選別の過程、測らなかった候補を残すことが、次の学習の質を決める。
測定系、陽性・陰性対照、反復測定の結果も必要になる。また、高得点の候補だけを測れば、それ以外の領域については評価できない。予算内で独立に選んだ探索候補や対照を含めることは、この偏りを点検する方法の一つである。
5. データを増やすことへの、重要な反論
8月公開のBenderらのNature Reviews Drug DiscoveryのPerspectiveは、データ生成そのものより、それを臨床に関係する判断へ結び付けることを重視している。本記事では公開されている該当部分を参照した。これは「物理的な実験が次の不足になる」という見方への重要な反論である。Bender et al.
私はこの反論を、実験への投資が不要だという意味には読まない。測定が増えても、解きたい問いと測定系が合っていなければ、判断の不確実性はあまり減らないという指摘として受け止める。
例えば、結合を改善したい場面と、患者で十分な曝露を得たい場面では、必要な実験が違う。病態への作用を確認したいなら、測りやすい細胞系の応答だけでは足りないこともある。大量の似た測定を追加するより、予測の前提が崩れる条件を一つ調べる方が、候補の選択を変える場合がある。
この見方では、ボトルネックは一列に並ぶ装置の最も遅いものとは限らない。次の判断を変える証拠が、どの条件で手に入るかが問題になる。
仮に、候補Aは試験管内の活性が高い一方、効果に必要な曝露をヒトで安全に達成できるかが不確かで、候補Bは活性がやや低くても曝露の見通しが良いとする。このとき結合実験を増やすより、曝露予測や安全性の前提を点検する方が、AとBの優先順位を変えうる。必要な曝露を安全に達成できないとの結果なら、Aの継続を見直す理由になる。これは説明用の仮想例であり、具体的な候補薬の比較結果ではない。必要な測定は、まず何を決めたいかを定め、その決定を変える不確実性から選ぶ。単に最も不確かな項目ではなく、測定結果が候補の選択や継続・中止を変えうる項目を、費用と所要時間も含めて優先する。
6. 実験需要は増えるのか:仮定を分けて計算する
議論を整理するため、一定の判断点まで進めるプログラム群の総実験数を、プログラム数\(P\)、1プログラムあたりに必要な反復回数\(R\)、1反復あたりの候補数\(B\)の積として近似する。
\[ E=P\times R\times B \]
これは同程度の判断点と作業量を持つプログラムを想定した説明用のモデルである。\(R\)と\(B\)を共通の代表値としておき、実験の種類、反復測定、費用、工程間の重複を省いている。プログラムごとの異質性が大きい場合は個別の実験数を足し合わせる必要がある。
| 仮定の例 | プログラム数の倍率 | 反復回数の倍率 | 1反復の候補数の倍率 | 実験数の倍率 |
|---|---|---|---|---|
| 選別だけが改善する | 1.0 | 1.0 | 0.5 | 0.5 |
| 着手数が増え、選別も改善する | 3.0 | 1.0 | 0.5 | 1.5 |
| 着手数が増え、必要な反復回数も減る | 3.0 | 0.5 | 0.5 | 0.75 |
表の値は筆者が設定した仮定であり、市場予測・実測値ではない。倍率は基準シナリオとの比較。年間の実験需要を直接予測する表ではない。
ここで反復回数の減少は、1回の所要時間の短縮とは異なる。実験が速くなれば同じ期間に実行できる反復が増える場合もあるため、この表では時間の短縮効果を直接モデル化していない。
同じ「1反復の候補数が半減する」という改善でも、全体の実験数は増えうるし、減りうる。さらに、実験数が増えても単価が下がれば、外部サービスの売上が同じ倍率で増えるとは限らない。内製化すれば外注先の売上には現れない。
したがって、需要増を論じるなら、AIでどの因子が変わったのかを測りたい。今の公開決算は、その一部を見る材料であり、式の全因子を同定できるデータではない。
7. 臨床への前進と、AIの優位性の証明を分ける
AIを用いた設計の候補が、臨床で検証される段階へ進んでいることは重要である。
Generate:Biomedicinesのパイプラインは、重症喘息を対象とする抗TSLP抗体GB-0895をPhase IIIとして掲載している。Insilicoは9月10日、特発性肺線維症(IPF)を対象とするrentosertibのPhase IIIで最初の患者への投与を発表した。一方、Reutersは1月、Isomorphic Labsの最初の臨床試験開始目標が、前年末から2026年末へ変更されたと報じた。最後の例は予定についての報道であり、試験開始の確認ではない。Generateのパイプライン、Insilicoの発表、Reutersの報道
同じPhase IIIでも、標的の検証段階は異なる。TSLPには既承認薬tezepelumabによる重症喘息でのヒトの検証がある。一方、rentosertibはIPFでのTNIKへの介入を検証している。前者の進展を新標的の妥当性の証明と読むことはできず、既存薬があることもGB-0895自体の有効性・安全性を保証しない。FDAのtezepelumab承認説明、rentosertibの原著
rentosertibには、2025年に査読論文として報告されたPhase IIa試験もある。71人を無作為化した12週間の試験で、主要目的は安全性・忍容性、肺機能の変化は副次的評価だった。これは候補薬について患者で得られた証拠である。しかし、非AI設計の候補と同条件で比較した試験ではなく、AIが成功確率を上げたことの直接的な因果証明にはならない。Xu et al., Nature Medicine
IQVIAは5月、AIの関与を確認した新興バイオ企業のプログラムを、同じ企業区分・規模の非AI群と比較し、直近3年間のPhase I成功率が75%、Phase IIは非AI群と同程度、Phase IIIは分析に十分な件数がないと説明した。小規模なコホートであることも明記している。本記事で利用したのは公開解説であり、有料レポートの全プログラム・分母を独立に再計算したものではない。IQVIAの公開解説
この結果は前向きな兆候だが、AI使用の有無だけが違う比較ではない。適応疾患、標的、モダリティ、資金、経験、候補の選び方による違いが残る。Phase Iの前進から、患者での有効性や承認までの改善を自動的に推論することもできない。
標的探索、分子設計、既存候補の最適化など、AIが関わった工程も同一ではない。また、公開された成功例が目立つこと自体による報告・選択の偏りがあり、進展例だけから全候補の成功率は求められない。
私が次に知りたいのは、候補を提案した時間だけではなく、同じ種類の課題で、失敗をどれだけ早く見抜き、どれだけ良い候補を臨床へ進められたかである。
8. 非臨床評価の変化も、証拠の省略ではない
FDAは3月、New Approach Methodologies(NAMs)の利用と検証についてドラフトガイダンスを公表した。規制当局への提出に用いる開発段階の評価を対象とし、創薬研究そのもののガイダンスではない。ヒト由来の試験系や計算モデルなどを、どの目的で、どの範囲まで信頼して使うかという問題である。ドラフトを最終的な実施基準として扱うことはできない。FDAのドラフト
9月には、規則中のanimal等の表現をnonclinicalへ整理するdirect final ruleも公表された。ただし、2026年10月6日時点ですでに施行済みではない。掲載文書では施行日を2027年2月4日とし、重大な反対意見があれば撤回する手続きを定めている。Federal Register掲載文書
FDAは、この用語変更が特定の方法を要求したり、証拠の基準を変えたりするものではないと説明している。したがって「動物試験が不要になり、計算だけで薬を開発できる」と読むのは誤りである。FDAのNAMs説明
試験系の選択肢が広がるほど、測定が何を代表しているか、ヒトへの予測にどの程度使えるかの検証が重要になる。実験を減らすことと、必要な証拠を減らすことは別である。
9. これから追いたいのは「どの不確実性が減ったか」
ここまでを踏まえると、AI創薬の進歩を確認する指標も分けたい。
| 問い | 追いたい情報 | それだけでは判断できないこと |
|---|---|---|
| 設計は改善したか | 同じ標的・予算・選別条件での実測成績 | 患者での便益 |
| 実験は制約になっているか | 納期、稼働率、受注残、単価、検証可能な測定の割合 | 売上増のAIへの因果帰属 |
| 次の設計に学習できているか | 負例、失敗理由、測定条件、前向きの独立評価 | データ量だけから見た学習価値 |
| 臨床への移行は改善したか | 疾患・標的等を揃えた成功率、時間、費用 | 個別候補の進展だけから見たAI全体の優位性 |
| 開発判断は改善したか | 事前に固定した予測と基準、後の観測、継続・中止候補の追跡 | 判断が速くなっただけでの妥当性 |
例えば用量を選ぶ場面なら、単に高い活性を示す候補を選ぶだけでは足りない。ヒトで達成できる曝露、標的への作用、効果と安全性の関係、患者間のばらつきをつなぎ、どの仮定が用量の選択を変えるかを調べる必要がある。この部分は、分子の生成とは別のモデル化・検証の仕事になる。
判断の改善を測るには、結果を見る前に予測と評価基準を固定したい。進めた候補だけを評価すると、早期に中止した候補の情報が失われる。中止候補の一部を独立に再評価するなどの設計がなければ、誤った中止が減ったかは確かめにくい。
実験の選択には、判断への影響だけでなく費用と所要時間も含める。例えばヒト曝露の不確実性を減らしたい場合でも、直接測れない段階では、必要な前提をまず非臨床で調べることになる。12週間の臨床試験で得た成績から、長期の便益・安全性や異なる併用条件まで同じ確度で判断することもできない。
ここからは私の解釈である。AIによって候補を提案する敷居が下がるほど、価値が増すのは「候補が多い」ことより、候補のどこに不確実性が残り、その不確実性を減らすために次に何を測るかを説明できることだと思う。
ボトルネックは、計算から実験、実験から臨床へ必ず一方向に移るわけではない。標的や薬の種類、データの質、予算によって異なる。だからこそ、データ量やパイプラインの件数だけでなく、どの判断に使える証拠が増えたのかを追いたい。AI創薬の進歩を、患者へ届くところまで確かめるには、その問いが必要になる。
調査範囲と限界
本記事は、査読論文・Perspective、AI研究組織の技術報告、生命科学関連の決算・発表、FDAとFederal Register、Reuters等の報道を横断して確認した論考である。検索日は2026年10月6日。ニュースやSNSを含む全媒体の網羅的調査、産業全体の統計調査、投資収益の予測を実施したものではない。
発表主体の自己報告と独立した検証を区別し、有料資料を全文確認できない場合は公開部分だけを用いた。表の数値はそれぞれの公表指標であり、統一基準へ換算していない。図と仮定計算は筆者作成であり、特定の研究開発プログラムの実測ではない。