AI親和性予測の「R² 0.43」を測定ノイズの上限から読む
ChEMBLで同じ化合物・標的のIC50を報告した文献の組から、論文由来の親和性ベンチマークで届きうるR²の上限を見積もった。再引用を除くと上限は0.59〜0.70で、AtomwellのR² 0.434はその6〜7割にあたる。
On this page
2026年10月、Bindwellは親和性予測モデルAtomwellを発表した。論文と特許からLLMで抽出した7,600万件の測定値で学習したモデルである。Announcement blogでは、学習に使っていない論文・特許の1,885件のIC50で、3つのモデルを比べている (1)。 - Atomwell:R² 0.434 - Nesso-1(Recursion傘下のValence Labsが公開したモデル (2)):R² 0.237 - Boltz-2(タンパク質と化合物の複合体の立体構造から親和性を予測する公開モデル):R² 0.034
R²(決定係数)は、ここでは1から平均二乗誤差を測定値の総分散で割った値を引く指標である。負にもなりうる。1なら完全な予測、0なら全件に平均値を答えるのと同じになる。3つの値はいずれもブログの記載値で、本記事ではこれらのモデルを実行していない。
この0.434は高いのか、低いのか。評価に使うIC50そのものに測定のばらつきがあるので、観測できない独立な測定誤差が残れば、潜在値を完全に当てても期待するR²は1に届かない。本記事では、ChEMBLで同じ化合物・同じ標的のIC50を別々の文献が報告している組を集めた。その文献間のばらつきから、独立誤差と分散の移植を仮定したR²上限のシナリオを計算した。測定のばらつきのために、どのモデルも下回れない誤差を、本記事では「ノイズの床」と呼ぶ。上限は、1からこの床を引いたものにあたる。
Atomwellの評価データは公開されていない。本記事は、Atomwellの性能を検証したものではない。ベンチマークの値を読むときの物差しを、公開データで作ったものである。
文献間の測定差から予測上限を見積もる
問い(QOI:question of interest): 同じ化合物・同じ標的のIC50を、別々の文献が報告したとき、一方の値で他方をどこまで予測できるか。そこから、「学習に無い論文で評価する」ベンチマークのR²の上限はどの程度か。
使いみち(COU:context of use): AI親和性予測モデルの分布外ベンチマークの値(R²、MSE、FVU)を読むときの物差し。特定のモデルの順位や優劣は判断しない。
方法
データ: ChEMBL 37(2026年5月リリース、REST APIから取得)(3)。15標的のヒトの単一タンパク質について、IC50のうちpChEMBL値があるものを使った。合計123,300件である。pChEMBL値は、IC50をモル単位で表して−log10を取った値で、以下pIC50と書く。1違うと10倍の差になる。 - キナーゼ: EGFR、HER2、ABL1、JAK2、CDK2、BRAF、VEGFR2、PI3Kα - プロテアーゼ: BACE1、トロンビン、第Xa因子、DPP4 - その他: HDAC1、PARP1、hERG
組の作り方: 1. 同じ文献の中で同じ化合物・標的に複数の値があれば、中央値にまとめた(104,759件)。 2. 2つ以上の文献で測られている化合物・標的の組は、10,580組(全体の12%)だった。 3. 化合物ごとに文献を2つ無作為に選び、pIC50の差を取った。こうすると、10,580組が1組ずつ同じ重みで入る。多くの文献で測られた参照化合物が結果を左右しないようにするためである。可能なすべての文献の組(165,494組)も、感度解析として計算した。 4. pChEMBL値は小数第2位までなので、差も小数第2位に丸めてから判定した。差が0なら「完全一致」、1以上なら「10倍以上ずれる」とした。
上限の換算: - 各文献の値が、同じ潜在値に、平均ゼロ・同分散で互いに独立な誤差を足したものだと仮定する。このとき、文献間の差の分散の半分が、1つの測定の誤差の分散(ノイズ分散)になる。 - Atomwellのベンチマークの総分散は、報告値から MSE ÷ (1 − R²) = 0.885 ÷ 0.566 = 1.56 と逆算できる。R² = 1 − MSE ÷ 総分散 で計算されていることが前提である。Nesso-1とBoltz-2の報告値から逆算しても、同じ1.56になった。3つの報告値は互いに整合している。 - 真の値を完全に当てるモデルでも、ノイズ分散の分は外れる。したがって上限は 1 − ノイズ分散 ÷ 1.56 である。
この換算には、ChEMBLの文献間変動を非公開ベンチマークへ移せるという追加仮定がある。アッセイ条件による系統差は、条件を入力にすれば予測できる部分も含む。したがって普遍的な不可約誤差を求めたものではない。
上限シナリオの95%区間は、化合物を単位にしたブートストラップ(2,000回)で求めた。
事前の計画と、結果を見た後の変更: - 解析計画は計算前に固定した。事前に決めた主解析は「完全一致を含む」である。判断の規則は「上限が0.9以上なら、上限まで余地が大きいと書く」だった。主解析の上限は0.91で、規則の上では「余地が大きい」側に入る。 - しかし結果を見ると、完全一致が多かった(結果1)。そこで本記事は、独立測定に近づける意図で表1の「Exclude exact matches」(完全一致を除く)と「Exclude ChEMBL duplicate flags (post hoc)」(ChEMBLの重複フラグを除く)の値を物差しに使う。この判断は結果を見た後のものである。 - 重複フラグによる除外と、差の分布の山の計数も、結果を見た後に加えた。
文献間の完全一致と重複の扱い
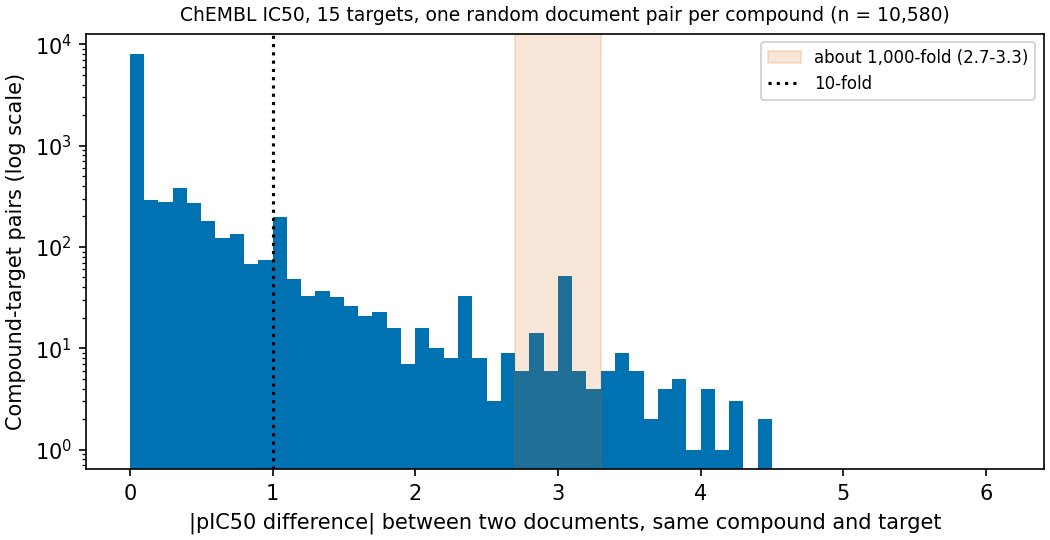
図1は、10,580組の文献間の差の分布である。縦軸は対数目盛で、差0の棒が突出して高い。
10,580組のうち70.2%で、2つの文献の値が完全に一致した。再引用の可能性がある一方、丸めや実測の一致でも同じ値になる。値の一致だけで再引用を確定していない。ChEMBLも、123,300件のうち15,396件(12.5%)に「重複の可能性」のフラグを付けていた。
表1. 重複処理によるR²上限シナリオの変化。
| Handling | Pairs | Difference SD (log units) | At least tenfold disagreement | R² ceiling scenario (95% interval) |
|---|---|---|---|---|
| Include exact matches (planned primary analysis) | 10,580 | 0.53 | 6.2% | 0.91 (0.90–0.92) |
| Exclude exact matches | 3,151 | 0.97 | 20.9% | 0.70 (0.67–0.72) |
| Exclude ChEMBL duplicate flags (post hoc) | 2,810 | 1.13 | 30.9% | 0.59 (0.56–0.62) |
今回の完全一致を含む解析では、文献間の値はよく一致して見え、上限シナリオは0.91になった。そこに再引用が含まれるなら、見かけの一致は独立な再現性を表さない。しかし再引用は独立な測定ではない。ベンチマークの1件のラベルに含まれるばらつきを表すのは、独立な測定どうしの差の方である。その場合、差の標準偏差は約1 log単位(約10倍)で、10倍以上ずれる組が2〜3割あった。
ただし、完全一致を除くと、別々の実験で本当に一致した組も一緒に除かれる。残るのは値が食い違った組だけなので、ばらつきは大きめに、上限は低めに見積もられる。重複フラグによる除外は、これを別の方法で確かめたものだが、こちらも完全ではない。0.59〜0.91は、重複処理と分散移植の仮定を変えたシナリオの範囲である。真のベンチマーク上限がこの間にあると保証する区間ではない。0.59〜0.70も、独立性が確認された上限ではない。
この傾向は先行研究とも合う。Kramerらは、公開のKiの「繰り返し測定」の多くが、同じ測定の再掲であることを示した (4)。LandrumとRinikerは、文献をまたいでIC50やKiを合わせると、大きなノイズが入ることを示した (5)。
10倍付近と1,000倍付近に山がある
差の分布(図1)は、なだらかに減っていくだけではない。いくつかの位置に鋭い山があった。山が無いと仮定したときに期待される数(両隣の区間の平均)を超える組を数えた(結果を見た後の計数)。
表2. 文献間差の山の事後的集計。
| Difference (log units) | Approximate ratio | Pairs | Expected without peak | Excess (fraction of all pairs) |
|---|---|---|---|---|
| 1.0–1.1 | 10-fold | 197 | 61 | 136 (1.3%) |
| 2.3–2.4 | About 200-fold | 33 | 8 | 25 (0.2%) |
| 3.0–3.1 | 1,000-fold | 52 | 6 | 46 (0.4%) |
- 1,000倍付近: nMとµMの取り違えと整合するが、個別の誤りは確認していない。
- 10倍付近: 桁の転記の誤りや、測定条件の違いでも起こりうる。「10 µM超」のような打ち切り値や、丸めた値の報告でも生じうる。
- 2.3付近: この位置だけでは原因を特定できない。自然対数と常用対数の取り違えなら常にこの差になる、という関係もない。
上の表は結果を見た後の数え方である。事前の計画では、1,000倍付近をもっと広い区間で数える指標を決めていた。その指標(差が2.7〜3.3の割合と、両側の区間との差)では、主解析での超過は0.3%だった。ずれた値が隣の区間にも広がるので、区間の選択で超過数が変わるため、これは別の集計値であり厳密な下限ではない。約1,000倍の組を除くと、主解析の上限は0.91から0.93に上がった。
Bindwellのブログも、外部の受託企業(CRO)のデータに、1,000倍の単位の誤りが混ざっていた例を挙げている。また、CROとBindwellの抽出パイプライン(Datawell)の両方で拾われた10,972件のうち、完全に一致したのは8,566件(78.1%)だった。人手で整備されたデータベースでも、LLMで抽出したデータでも、この種の誤りはラベルのばらつきとして残りうる。
標的によって上限は大きく違う
完全一致を除いた組で、標的ごとに上限を計算した。2つの物差しを並べる。 - ベンチマーク換算: Atomwellのベンチマークの総分散(1.56)で割った値。 - 標的内: その標的の組の中のpIC50の分散で割った値。標的ごとに化合物の幅が違うので、こちらが「その標的だけで評価したときの上限」に近い。
表3. 標的別のR²上限シナリオ。
| Target | Pairs | Benchmark-scaled ceiling (95% interval) | Within-target ceiling |
|---|---|---|---|
| BRAF | 305 | 0.91 (0.86–0.95) | 0.81 |
| PI3Kα | 92 | 0.89 (0.84–0.93) | 0.86 |
| EGFR | 580 | 0.73 (0.68–0.77) | 0.74 |
| JAK2 | 536 | 0.60 (0.52–0.67) | 0.26 |
| PARP1 | 85 | 0.52 (0.31–0.71) | 0.59 |
| hERG | 216 | 0.15 (−0.07–0.35) | 0.20 |
15標的すべての値は配布資料のCSVにある。2つの物差しの差が最も大きかったのはJAK2である(0.60と0.26)。JAK2は化合物の値の幅が狭く(標的内の分散0.85)、同じ大きさのばらつきでも、標的内で見ると説明できる割合が小さくなる。
hERGは、どちらの物差しでも上限が低かった。文献間の差の標準偏差は1.6 log単位である。hERGのIC50は、結合試験やパッチクランプなど測定法が大きく違うことが知られており、それが一因と考えられる。ただし本解析では、測定法の違いを確かめていない。
標的ごとの組の数は36〜580組と少なく、区間は広い。それでも、ベンチマークにどの標的が多く含まれるかで、届きうるR²が変わることは分かる。
Atomwell・Nesso-1・Boltz-2の値をどう読むか
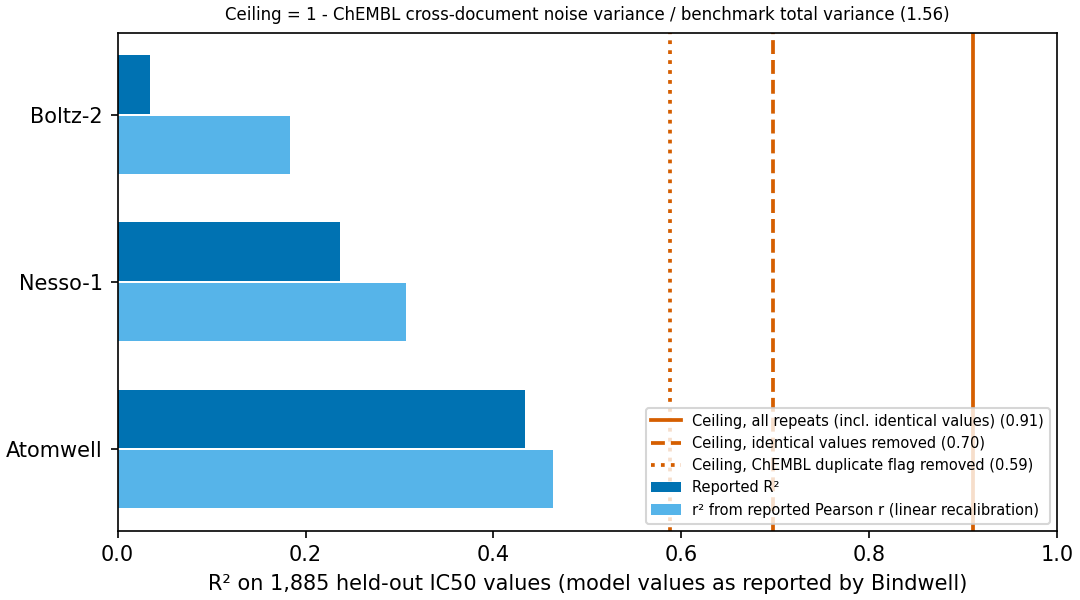
図2は、3モデルの報告されたR²(濃い青)と、相関係数の二乗(薄い青)を、重複の扱いを変えた3つの上限(縦線)と並べたものである。
Atomwellの0.434: 上限シナリオ0.59〜0.70で割ると62〜74%になる。ただし実際の到達可能性能を測った比率ではなく、仮定を置いた換算である。
Boltz-2の0.034: Pearsonの相関係数(r)は、予測と測定が直線的にそろう度合いである。r = 0.429を二乗すると0.184になる。これは、評価集合そのものに直線を当てはめて予測値の尺度を合わせたときのR²にあたる。r²と報告されたR²の差は、Boltz-2で0.15、Nesso-1で0.07、Atomwellで0.03だった。 - Boltz-2の報告値の低さの一部は、尺度のずれによる。 - ただし、この直線は評価集合で当てはめたもので、楽観的な値である。 - Pearsonのrは直線的な関連の指標で、順位相関そのものではない。 - 構造ベースのモデルと比べるときは、尺度を合わせ直すかどうかを揃えた方がよい。
スケーリング則の「下がらない誤差」: Bindwellは、分布外でのFVU(説明されない分散の割合、1 − R²)を、E + A/N^α + B/D^β の形に当てはめた。下がらない誤差は E = 0.104、9Bモデルの値は0.272である。 - 本記事のノイズの床をFVUに直すと、完全一致を含めると0.09、除くと0.30、ChEMBLの重複フラグで除くと0.41になる。 - 9Bモデルの0.272は、完全一致を除いた床(0.30)より低い。完全一致を含めた床(0.09)よりは高い。 - Eは当てはめのパラメータで、測定のノイズそのものではない。
2つは別の集合の値である。ブログのFVUは54万件の分布外の検証集合で計算されており、その総分散もノイズも公開されていない。また学習データには、IC50以外の物理量も含めて13種類が混ざっている。9Bモデルの値が独立な測定の床より低いとすれば、次のような理由が考えられる。 - 検証集合のラベルのばらつきが、ChEMBLの文献間のばらつきより小さい。 - 検証集合に、再引用のような独立でない一致が含まれている。ブログの説明では、分布外の分割では化合物も重ならない。したがって、この可能性があるとすれば、化合物の重なり以外の形に限られる。 - アッセイの条件をモデルに入れているので、文献間の系統的な差の一部を予測できている。
どれであるかは、検証集合の公開なしには判断できない。
上限シナリオの成立範囲
今回のIC50文献間差は、重複の扱いに強く依存した。同じ化合物・標的でも、測定法や条件が違えば、差は独立な測定誤差だけにはならない。0.59〜0.91という換算値を、すべての親和性予測やAtomwellの実際の上限へ一般化できない。
非公開の1,885件が単一測定か文献内平均か、どれほどのノイズを含むか、リークや再引用があるかは確認できない。15標的はよく研究された標的に偏り、IC50以外の親和性指標は対象外である。アッセイ条件を入力に使うモデルなら、基質濃度に依存するIC50の差などを部分的に予測できる可能性もある。
R²と相関係数の二乗は異なる指標であり、評価集合での再校正は外部検証ではない。モデル間比較では校正条件を揃え、データ固有の反復測定情報を併記することで、0.434の解釈を具体化できる。今回の解析はその必要性を示すが、非公開ベンチマークの実際のノイズ上限は決めていない。
実装の確かめ
- 独立の再計算: 全文献の組の集計を、別の言語(base R)で書き直した。組の数(165,494)、ノイズ分散、10倍以上ずれる割合、完全一致の割合が、丸めの範囲(差1×10⁻⁶以下)で一致した。
- 単体の検査: 合成データで、ノイズ分散の回復と、1,000倍の誤りの検出などを確かめた(6件)。
- 再現性: 同じ入力で再実行すると、結果のファイルがバイト単位で一致する。入力はSHA-256で固定した。
データとコードの公開状況
再実行:python acquire.py && python test_analysis.py && python analysis.py && python figures.py && Rscript validate.R(Python 3.12、numpy、pandas、matplotlib、requests;R 4.5.3、jsonlite)。
解析計画・コード・入力の取得手順とチェックサム・結果・検証結果は配布資料に含めた(配布資料)
参照
1. Anand N, Goel R. The bitter lesson for biology. Bindwell. 2026 October 18. Article.
2. Valence Labs. Nesso-1 technical report. 2026. Report.
3. Zdrazil B, Felix E, Hunter F, Manners EJ, Blackshaw J, Corbett S, et al. The ChEMBL Database in 2023: a drug discovery platform spanning multiple bioactivity data types and time periods. Nucleic Acids Research. 2024;52:D1180–D1192. doi:10.1093/nar/gkad1004.
4. Kramer C, Kalliokoski T, Gedeck P, Vulpetti A. The experimental uncertainty of heterogeneous public Ki data. Journal of Medicinal Chemistry. 2012;55:5165–5173. doi:10.1021/jm300131x.
5. Landrum GA, Riniker S. Combining IC50 or Ki values from different sources is a source of significant noise. Journal of Chemical Information and Modeling. 2024;64:1560–1567. doi:10.1021/acs.jcim.4c00049.