Beacon-2の「ヒトの用量予測」は何を当てているのか:公開ADMEデータで用量予測を分解する
Inductive BioのBeacon-2がExpansionRxで示したSpearman 0.79と誤差2.4倍について、公開ADMEデータと透明な薬物動態の式で「実測値からの用量」を作り直し、どの入力が用量の順位を決めているか、数字をどう読むかを確かめる。
要点
- 効力を10 nMに固定し非結合型の平均濃度を目標にすると、用量はHLM CLintに比例する。補正を加えた設定でも、用量の順位とHLM CLintのSpearman相関は0.80〜1.00だった(325化合物)。
- 平均濃度を目標にする設定では、全化合物に同じ用量を答えるだけで絶対平均倍率誤差は2.4〜2.8倍になり、報告された2.4倍は基準の用量のばらつきと並べないと読めない。
- 評価の正解は実測のin vitroデータから計算した用量で、効力も臨床の用量も含まない。Page(2016)では、in vitroからの予測用量が実際の用量の3倍以内に入るのは45〜68%だった。
On this page
背景と目的
資料の確認日:2026年10月14日。公開データと教科書的な薬物動態の式だけを使う。
2026年9月17日、Inductive Bioは、化合物の構造からヒトの1日用量を予測するBeacon-2を発表した。(1) 予測した性質を一つずつ見るのではなく、「1日に何mg飲めば効くか」という一つの数字にまとめる、という触れ込みである。性能の根拠として、次の数字が示された。
- 公開データ(OpenADMET-ExpansionRx)の325化合物で、予測用量と「実測のin vitro ADMEから計算した用量」とのSpearman相関が0.79、average fold error が2.4倍。
- 提携先の20の創薬プログラムで、同じ比べ方の平均Spearman相関が0.61。測定値からの用量が3倍以上違う化合物の組では、用量の低い方を81%超の割合で正しく選んだ。
用量は、クリアランス、タンパク結合、分布容積、吸収、効力、必要な曝露の掛け算と割り算で決まる。用量の予測が当たったというとき、どの入力を当てたことになるのかを、公開データで分解してみた。
公開資料に書かれていること
Inductiveの解説によれば、Beacon-2は三つの部分からなる。(1) ADMETと薬物動態の予測、効力の予測(FEPまたはコフォールディングによる親和性モデル)、それらを用量に変換する薬物動態・薬力学の部分である。代替の設定(ラットのクリアランスと分布容積からのアロメトリー)の説明から、既定の設定はヒト肝ミクロソームのin vitroクリアランスとØie–Tozer法の分布容積だと読める。用量の計算の根拠としては、Wangら(2025)とPage(2016)が挙げられている。(2)(3)
ExpansionRxでの評価は次の設計である。(1)
- 対象は、チャレンジの評価用データのうち、ADMEの実測値がそろった325化合物。
- 公開データには効力がないので、効力は10 nMと仮定した。
- 「正解」は、実測のADMEを同じ薬物動態・薬力学の部分に入れて計算した用量。
用量の式、入力に使った測定項目、標的の曝露(最低濃度か平均濃度か)、average fold error の定義は公開されていない。本記事では、average fold error を、対数の絶対誤差の平均から求める絶対平均倍率誤差(AAFE)と解釈した。符号つきの平均(AFE)なら意味が変わる。
そこで、Page(2016)を簡略化した透明な式を自分で組み、実測値から「正解の用量」を作り直した。Inductiveの式と同じではない。
データと式
データは、OpenADMET-ExpansionRxの全データ(CC BY 4.0)である。(4) 評価用2,282化合物のうち、HLM CLintとマウス血漿タンパク結合(MPPB)の両方が測定範囲内にある化合物は335だった。CLintが0の9化合物(対数が取れない)を除き、LogDとCaco-2(透過性と排出比)がそろう化合物に絞ると、ちょうど325になった。Inductiveの325と同じ集合である可能性が高いが、確かめる手段はない。集合の一致も、Inductiveが透過性を用量計算に使ったかも、公開情報からは確定できない。
評価用の化合物のうち、HLM CLintが測定範囲外の化合物は228あった(「< 4.5」が213、「> 252.5」が15)。ほかの入力もそろうものは「< 4.5」が59、「> 252.5」が2で、除外は代謝の遅い側に偏っている。CLintが低いほど用量が低いという関係は、設定Aなどの仮定に依存する。
式の基本形は次のとおりである。
- 非結合型分率 fu は、マウス血漿の値で代用する(ヒトの値は公開データにない)。
- 肝クリアランスは well-stirred モデル(肝血流 20.7 mL/min/kg、血液/血漿比 1)。
- バイオアベイラビリティは、吸収率 Fa と肝の初回通過の積。
- 目標は、非結合型濃度を IC90(IC50 10 nM の9倍)に保つこと。1日1回、70 kg。
これをもとに、目標の曝露と補正の有無を変えた設定を比べた。
表1. 曝露目標と補正の設定。
| Setting | Target | Assumptions or corrections |
|---|---|---|
| A | Mean unbound concentration, Cavg,u | Fa=1; no microsomal-binding correction |
| A + fu,mic | Same | LogD-based microsomal-binding correction (5) |
| A without plasma-binding correction | Same | Omit plasma binding in the well-stirred model, following Page's treatment of bases |
| A + Fa | Same | Illustrative absorption fraction from Caco-2 permeability |
| A′ | Same | Both fu,mic and Fa |
| B | Minimum unbound concentration, Cmin,u | First-order absorption, ka=1/h; distribution volume 1 L/kg, with 3 L/kg sensitivity |
用量の順位は主にHLM CLintで決まる
設定Aでは、式の上で次のことが成り立つ。well-stirred モデルで肝の初回通過だけを考えると、経口のクリアランス(CL/F)は fu × CLint になる。非結合型の濃度を目標にすると、用量はさらに fu で割った分だけ増えるので、fu は消える。
用量 ∝ HLM CLint
これは非結合型の経口AUCについてよく知られた関係で、新しい発見ではない。ただ、この関係が成り立つ設定で効力を固定すると、用量の順位を当てることは、HLM CLintの順位を当てることと同じになる。計算でも、設定Aの用量とHLM CLintのSpearman相関は1.000だった。
補正を加えても、順位の大部分はHLM CLintで決まった。
表2. 用量とHLM CLintの関係。
| Setting | Spearman with HLM CLint | SD of log10 dose | Median mg/day at molecular weight 450 |
|---|---|---|---|
| A | 1.00 | 0.48 | 94 |
| A + fu,mic | 0.99 | 0.52 | 113 |
| A without plasma-binding correction | 0.91 | 0.81 | 764 |
| A + Fa | 0.94 | 0.47 | 112 |
| A′ (fu,mic + Fa) | 0.95 | 0.51 | 128 |
| B (volume 1 L/kg) | 0.80 | 1.17 | 763 |
| B (volume 3 L/kg) | 0.95 | 0.63 | 188 |
設定Bでは、半減期が効いてくる。クリアランスの高い化合物は、1日1回の投与で最低濃度を保つのに大量の用量が要る。分布容積 1 L/kg では、分子量450として1 g/日を超える化合物が46%あり、上位5%は約190 g/日を超えた。実際の創薬では、こうした化合物には1日2回の投与や別の剤形を考える。設定Bは極端な側の参考として読んでほしい。筋組織への結合(MGMB)からØie–Tozer法で分布容積を求められた128化合物では、設定BとHLM CLintのSpearman相関は0.87だった。
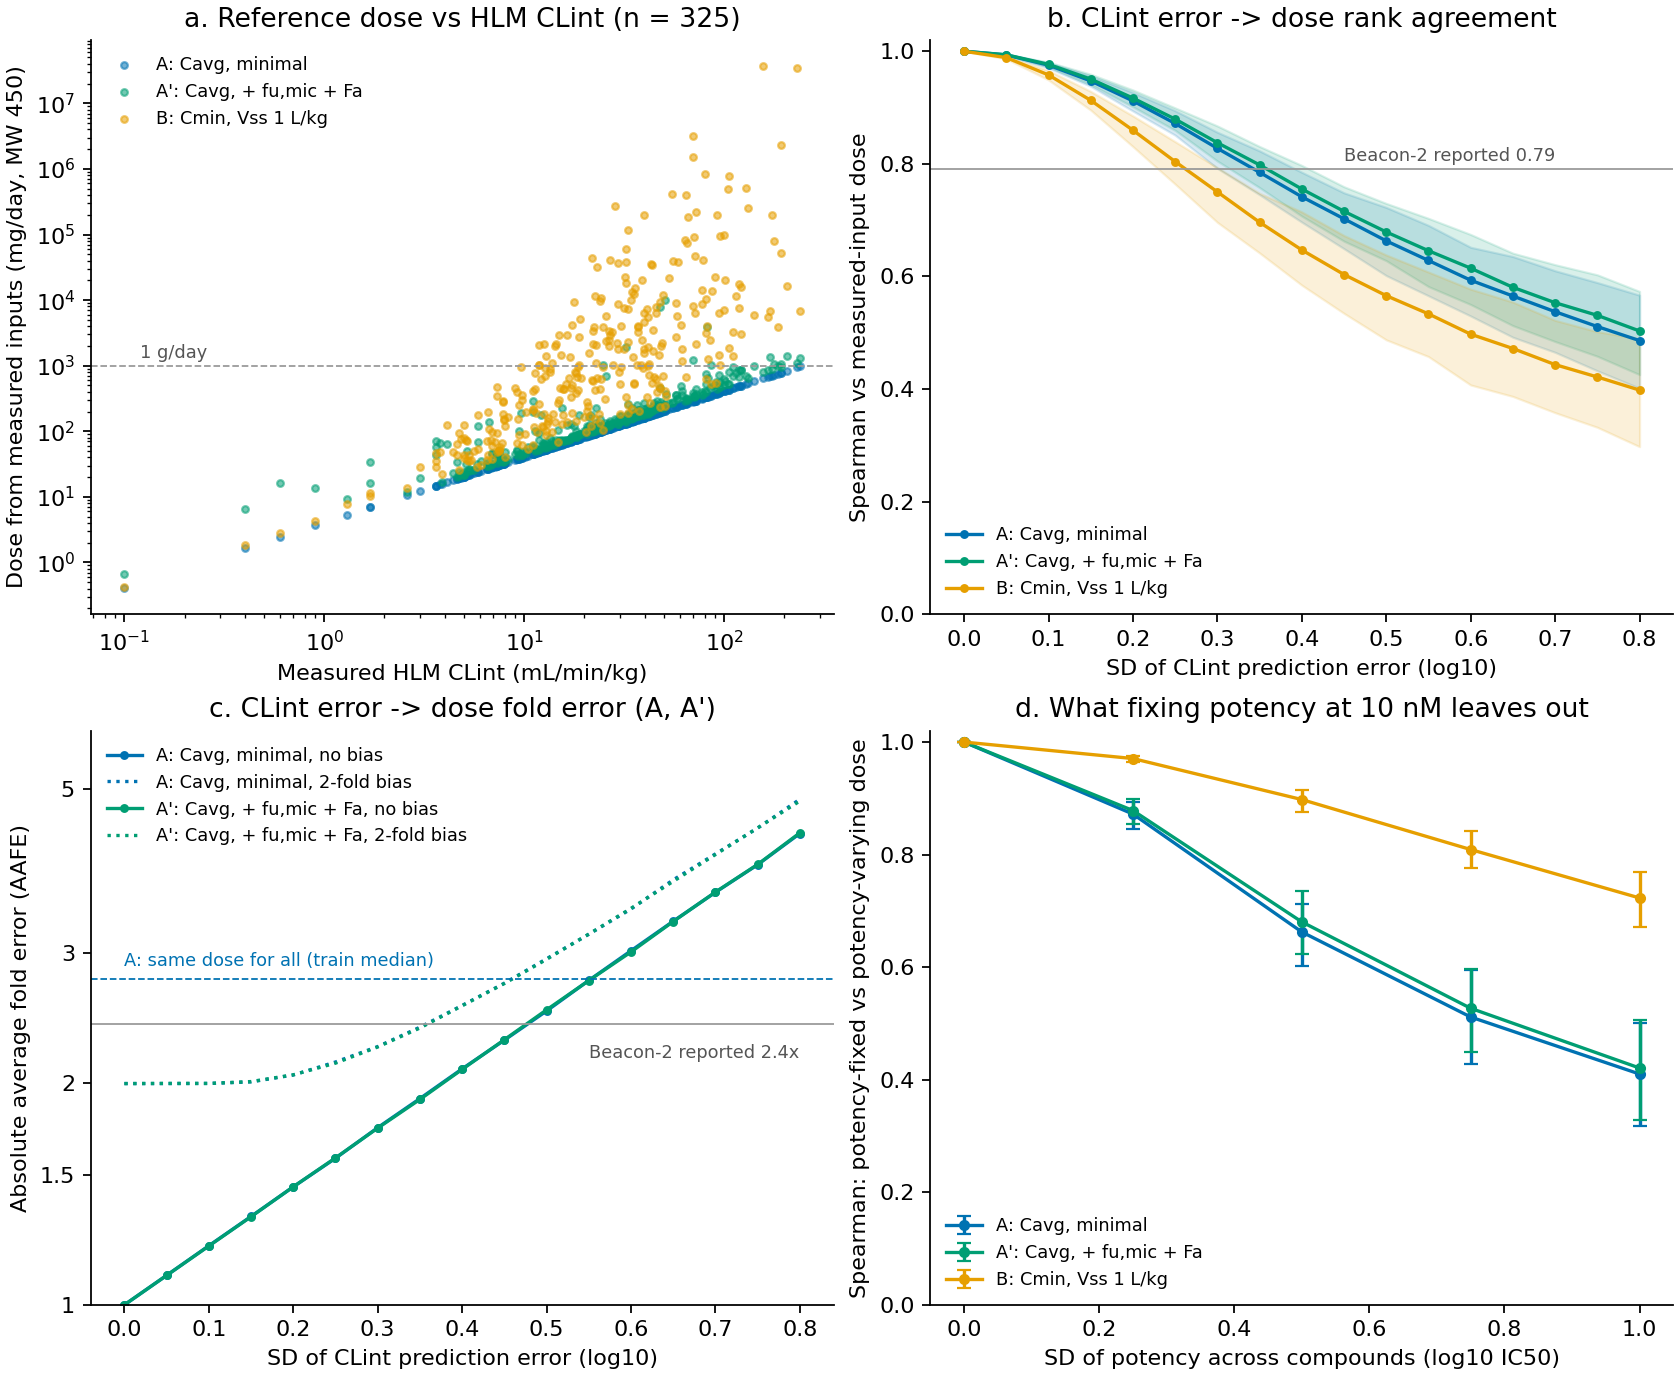
図1. (a) 実測値から計算した用量(縦軸、分子量450としてmg/日に換算)とHLM CLint(横軸)。青は設定A、緑は設定A′、橙は設定B(分布容積1 L/kg)。破線は1 g/日。n = 325。(b) CLintに対数正規の予測誤差を加えたときの、予測用量と実測値からの用量のSpearman相関。横軸は誤差の標準偏差(log10)。帯は誤差の500回の繰り返しの95%範囲で、化合物の抽出による不確実性は含まない。横線はBeacon-2の報告値0.79。(c) 同じ条件での絶対平均倍率誤差(AAFE)。設定AとA′だけを示す(両者はほぼ重なる。設定Bは値が桁違いに大きいので本文に書いた)。実線は偏りなし、点線は全化合物で2倍の偏り(log10で0.3)を加えた場合。青の破線は、設定Aで全化合物に学習用データの中央値の用量を答えた場合。(d) 化合物ごとに効力(log10 IC50)がばらつくとき、効力を固定した用量と効力を含めた用量のSpearman相関(どちらも実測値からの用量で、Beacon-2の性能ではない)。誤差棒は500回の繰り返しの95%範囲。
(出力:results/summary.json、results/error_propagation.csv、results/potency_sweep.csv)
0.79と2.4倍をどう読むか
順位
n = 325 の Spearman 0.79 の95%信頼区間は、0.74〜0.83 である(Fisher z、Bonett–Wright の標準誤差)。
CLintに対数正規の予測誤差を入れ、予測用量と実測値からの用量の順位の一致を計算した(図1b)。設定Aで Spearman 0.79 になるのは、CLintの予測誤差の標準偏差が log10 で約0.34(約2.2倍、信頼区間に対応する範囲は0.29〜0.40)のときだった。設定A′でも約0.36とほぼ同じだった。
設定Bでは、HLM CLintを完全に当ててもSpearman相関は0.80にとどまる。用量の順位が分布容積やタンパク結合にも依存するからである。
比較のために、用量の計算に使っていない実測値を、そのまま順位の予測に使った場合も計算した。これらは予測モデルの基準ではなく、同じ化合物の集合で別の測定値がどれだけ用量の順位と揃うかの参考である。
表3. 別の実測値と用量順位の相関。
| Measured property used directly | A | A′ | B |
|---|---|---|---|
| LogD | 0.63 (0.56–0.69) | 0.61 | 0.23 |
| Mouse liver microsomal CLint, n=278 | 0.64 | 0.63 | 0.44 |
括弧内はブートストラップの95%信頼区間。設定Aでは、LogDだけでも0.63になった。この集合ではLogDとHLM CLintのSpearman相関が0.63で、脂溶性の高い化合物ほど代謝されやすい傾向がある。構造から学習した単純なモデルの予測を用量の式に入れた基準は、計算していない(未計算)。
参考として、Inductiveの20プログラムでの指標に合わせ、用量が3倍以上違う組で低い方を正しく選ぶ割合も計算した。設定Aで Spearman 0.79 に相当する誤差では約94%だった。Spearman 0.61 に相当する誤差では、設定Aで約84%、設定Bで約77%だった。Inductiveの「81%超」は、平均Spearman 0.61 とおおむね整合する。
絶対値
AAFE 2.4倍は、実測値からの用量そのものがどれだけばらついているかと並べて読む必要がある。全化合物に同じ用量を答えると、次のようになった。
表4. 定数予測によるAAFE。
| Setting | Training-set median | Test-set median, known only retrospectively and optimal among constant predictions |
|---|---|---|
| A | 2.77-fold | 2.38-fold |
| A′ | 3.02-fold | 2.47-fold |
| B (volume 1 L/kg) | 14.3-fold | 7.98-fold |
設定Aに近い定義なら、2.4倍は「何も区別しない」予測と同じ程度である。
順位と絶対値を、同じ誤差モデルでそろえて説明できるかも調べた。設定Aでは、Spearman 0.79 に相当する誤差(log10で0.34)のときのAAFEは、偏りがなければ1.88倍だった。全化合物で2倍の偏りがあれば2.36倍になり、0.79と2.4倍の両方とほぼ合う。回帰で較正され、平均の方向へ縮んだ予測なら、Spearman 0.79でAAFEは約1.67倍になる。設定Bでは、Spearman 0.79 に相当する誤差のときAAFEは約5.2倍で、2.4倍より大きい。
ここから言えるのは、二つの数字の組み合わせが、基準の定義と、予測の偏りや縮みの両方に依存するということである。設定Aに近い定義なら、2.4倍は予測の順位の誤差だけでなく、全体の偏りも含んでいる可能性がある。どちらの読み方が正しいかは、基準の用量のばらつきと誤差の分布が公開されれば確かめられる。
効力を固定すると何が抜け落ちるか
効力を全化合物で同じ値にすると、用量は全体に同じ倍率がかかるだけである。そのため、Spearman相関もAAFEも、10 nMという値には依存しない。10 nMが影響するのは、mg/日の絶対値だけである。
一方、実際の用量は効力にも比例する。化合物ごとの効力のばらつきを入れて、効力を固定した用量と、効力を含めた用量の順位の一致を計算した(図1d)。これは実測値からの用量どうしの比較で、Beacon-2の性能の推定ではない。
効力の標準偏差が log10 で0.5(中央の95%が中央値の約1/10〜10倍、全体で約100倍の幅)のとき、Spearman相関は設定Aで0.66、設定Bで0.90だった。標準偏差1.0では、0.41と0.72だった。ADMEによる用量の幅が狭い設定ほど、効力のばらつきが順位を大きく動かす。リード最適化の系列で効力がどれだけばらつくかはプログラムによって違い、ここでは仮定の幅を振っただけである。ADMEと効力の相関(脂溶性が高いほど効力も高い、など)も入れていない。
実務では、効力は合成後に測定することが多い。その場合、効力を固定したADMEの部分の評価で足りる場面も多い。Inductiveの評価は、この「ADMEから用量へ」の部分を評価していると読めば、筋が通っている。効力を当てる力はこの評価の対象外であり、これは評価設計の範囲の問題で、誤りではない。ただし、合成前に効力も予測して用量を比べるなら、効力の予測誤差(Inductiveの例では、微調整したコフォールディングのモデルで Spearman 0.72)が用量の不確かさに加わる。
「実測値からの用量」は臨床の用量ではない
もう一つの前提は、正解が実測のin vitroデータから計算した用量であることである。in vitroからヒトへの外挿の誤差は、予測側と正解側の両方に同じように入るので、この評価では見えない。Inductiveも、この評価がin vitroの実測値に対するものだと明記している。(1)
Inductiveが根拠に挙げたPage(2016)は、in vitroのデータと予測値から薬物動態のモデルでヒトの用量を予測し、市販薬と開発化合物で、Cmin または Cmax で正規化した実際の用量と比べた。(3) 予測が実際の用量の3倍以内に入ったのは、データセットによって45〜68%、10倍以内は82〜92%だった。Wangら(2025)は、初期のin vitroデータだけを使う汎用のPBPKモデルで、Genentechの18化合物について、非結合型の Cmin・Cmax・AUC による順位付けができたと報告している。一つのin vitroの値だけで順位付けするより良かったという。(2)
Beacon-2の評価が測っているのは、「予測したADMEで計算した用量が、実測のADMEで計算した用量にどれだけ近いか」である。その先にある「実測のADMEで計算した用量が、ヒトで実際に必要な用量にどれだけ近いか」は、Page(2016)のような別の検証に頼っている。Page(2016)の数字では、3倍以内に入るのは半分程度だった。
考察
用量の予測という枠組みそのものには意味がある。性質をばらばらに見るより、用量という一つの単位にまとめる方が、トレードオフ(代謝の安定性を上げると溶解度が下がる、など)を比べやすい。Wangら(2025)も、単一のin vitroの値より、薬物動態のモデルでまとめた方が順位付けに良いと報告している。(2)
InductiveはMac1阻害薬の例で、効力だけを最適化した化合物より、用量で最適化した化合物の方が予測用量が低かったと示している。(1) この比較は同じモデルの予測で評価したもので、実測による確認ではない。一方でInductiveは、薬らしさの指標(QED)、医薬化学者の盲検での選好(87%)、ラットのデータに基づく別の薬物動態の設定でも同じ方向の結果を示している。
本記事の透明な式で読み替えると、ExpansionRxでのSpearman 0.79は主にHLM CLintを当てる力を反映している可能性がある。ただしInductiveの式と入力が公開されていないため、その寄与は分離できていない。効力を固定した用量の順位と、効力も含めて予測する臨床用量の精度は同じ評価ではない。
限界
- 式はInductiveの式ではない。本記事の数字は、Beacon-2の数字を再現したものではない。
- ヒトの血漿タンパク結合の代わりにマウスの値を使った。設定Aでは fu は用量に影響しない。
- 吸収率の式(Caco-2透過性から)とミクロソームのタンパク濃度(0.5 mg/mL)は例示の仮定である。イオン化の分類(酸・塩基)による補正の切り替えは、pKaがないので入れていない。
- 予測誤差は、化合物によらない対数正規の誤差として仮定し、CLintとfuの誤差は独立とした。実際の予測誤差は化学系列によって偏り、化合物どうしや項目どうしで相関する。
- 測定範囲外の値を除いたので、主に代謝の非常に遅い化合物が含まれていない。範囲外の値を境界値で戻すと、設定Aの用量の対数の標準偏差は0.48から0.51に、評価用データの中央値を答えたときのAAFEは2.38倍から2.66倍になった(n = 386)。
- ExpansionRxの全データは2026年1月に公開されており、Beacon-2のADMETモデルの学習に評価用の化合物が含まれていないかは、公開資料からは分からない。
データとコードの公開
計算コードは、OpenADMET-ExpansionRxの公開CSV(学習用、評価用、生データ)から、results/と図1を生成する(約6分)。データはHugging Face dataset(利用条件への同意が必要)から取得し、data/に置く。確認した版はrequirements.txtに固定した。
python -m pip install -r requirements.txt
python dose_decomposition.py
参照
- Rich A. Beacon-2: Completing the reward function for chemical optimization in drug discovery. Inductive Bio; 2026 Sep 17. Announcement.
- Wang Y, Wang W, Broccatelli F, Kenny JR, Wright MR, Sorenson J, et al. Human-Focused Multiparameter Optimization Scores for Rank Ordering Compounds during Early Drug Discovery: Validation of PBPK Models Based on Clinical PK Data. Journal of Medicinal Chemistry. 2025;68(16):17960–17970. doi:10.1021/acs.jmedchem.5c01707.
- Page KM. Validation of Early Human Dose Prediction: A Key Metric for Compound Progression in Drug Discovery. Molecular Pharmaceutics. 2016;13(2):609–620. doi:10.1021/acs.molpharmaceut.5b00840.
- OpenADMET, Expansion Therapeutics. OpenADMET-ExpansionRx Challenge full dataset [Dataset]. CC BY 4.0. Hugging Face. Accessed 2026 Oct 14.
- Hallifax D, Houston JB. BINDING OF DRUGS TO HEPATIC MICROSOMES: COMMENT AND ASSESSMENT OF CURRENT PREDICTION METHODOLOGY WITH RECOMMENDATION FOR IMPROVEMENT. Drug Metabolism and Disposition. 2006;34(4):724–726. doi:10.1124/dmd.105.007658.