Enchantのヒト半減期予測をSpearman相関0.74から考える
Iambic Therapeuticsが2024年に示したヒト半減期のSpearman 0.74について、公開のTDCデータで、基準モデルの到達点、分割と試験データの影響、少数データの基準、分布容積とクリアランスの寄与を確かめる(Enchant自体は検証していない)。
On this page
背景と目的
資料の確認日:2026年10月20日。公開データと標準的な機械学習の基準モデルだけを使う。本記事はEnchant自体を検証したものではない。 Enchantの予測は入手できないので、示すのは、公開データの性質と、素朴な基準モデルがどこまで届くかである。
AI創薬のIambic Therapeuticsは、2026年10月15日にNasdaq(ティッカーIAM)で取引を始め、1株16ドルで約1.5億ドルを調達した (1)。 同社のAIプラットフォーム Enchant は、2024年10月の発表で、創薬初期のデータからヒトでの薬物動態などを予測できると主張した (2) (3)。 中心の数字は、ヒトでの薬物半減期の予測で、Spearman相関が0.74(従来の最高は0.58)というものである。さらに、ヒトのデータが5分子分しかなくても予測力がある、とも書かれている。
この「0.74」と「0.58」の差は、どう読めばよいのか。同じ公開データで、数字の読み方を確かめてみた。
本稿では、公開ベンチマークと独自の基準モデルから、比較に必要な条件を調べた。
公開されていること
Enchantの2024年の発表と白書は、次のように述べている (2) (3)。
- 評価には、Obachらのヒト薬物動態のデータを使った。半減期のSpearmanは、前臨床データの全体と、Obachのデータの全体を使った場合に0.74である。
- 従来の最高は0.58とされ、TDCの「Half_Life_Obach」のベンチマークにリンクされている。TDCのリーダーボードでは、2026年5月28日時点(第三者の集計サイトbenchmarklistによる)の首位が0.576だった (4) (5)。
- ヒトのデータがObachの1%未満(5分子)でも、発表では「meaningful predictive power」、白書では「strong predictive power」と書かれている。前臨床の実験データによる転移学習の効果だと説明され、「競合の技術は、この少ない訓練データでは予測モデルにならない」とも書かれている。
書かれていないこともある。評価データの分割の方法、試験データの大きさ、乱数のシード、5分子の場合の数値は、白書の本文に見当たらなかった(図表の画像に載っている可能性があるが、本文のテキストからは読み取れなかった)。白書は、Obachの他の薬物動態パラメータも表にまとめたとしているが、その表も画像で、私は中身を確認できていない。また、本記事が確認したのは2024年の発表で、その後に更新された版は確認していない。
比べる先のTDCのベンチマークは、スキャフォールド分割(分子の骨格が似たものを同じ側に置く分割)で、20%を試験データとして取り置く。評価にSpearmanを使う理由は、「化学構造以外の要因にも依存するため」と説明されている (5)。 試験データは固定で、667薬物のうち135薬物である。乱数は、訓練と検証の分割だけを変える(TDCのソースコードを、査読者が確認した。私はPyTDCを使っていない)。リーダーボードの標準偏差(首位で約0.025、第三者の集計による)は、この乱数による違いで、試験データの顔ぶれの違いは含まない。
データ
データは、TDCが配布する三つのファイルである (6)。
- 半減期:667薬物(Obachらのヒト静脈内投与の終末相半減期)(7)。うちTDCの固定の試験データが135、訓練・検証用が532。
- 定常状態の分布容積(Vss):1,130薬物(Lombardoら)(8)。単位はL/kg。
立体異性体や塩を同じ親化合物にまとめると、半減期は658化合物になった(9組が重複。重複どうしの半減期の対数の差は、中央値で0.16、つまり約1.4倍で、最大は0.64、つまり約4.3倍)。骨格(Murcko骨格)は444グループにまとまり、365は1化合物だけのグループ、最大のグループ(ベンゼン環だけ)は57化合物だった。TDCの固定の試験データの135薬物は、訓練・検証用の532薬物と、親化合物が重ならなかった。分布容積との共通の化合物は621だった。
0.74と0.58の差はどれだけ確かなのか
試験データが135薬物の場合、Spearman 0.74 の95%区間は 0.64〜0.82、0.58 は 0.44〜0.69 だった(Fisher zにBonett–Wrightの標準誤差を用いた) (9)。白書は評価の大きさを書いていないので、全667薬物で評価した場合(0.74は0.70〜0.78、0.58は0.52〜0.63。交差検証の予測は独立でないため、実際はこれより広い)も併記する。
同じ試験データで二つのモデルを評価するなら、差はより精密に決まる。二つのモデルの予測の順位の相関を仮定して、依存する相関の差の区間(Zouの方法)(10)を計算した(この式はピアソン相関の理論に基づく近似を、Spearmanに流用している)。
表1. 予測順位間相関を仮定した相関差の近似95%区間。
| Correlation between predicted ranks, assumed | Difference interval with 135 test drugs | Difference interval with 667 test drugs |
|---|---|---|
| 0.3 | 0.02–0.31 | 0.10–0.23 |
| 0.5 | 0.03–0.29 | 0.10–0.22 |
| 0.7 | 0.06–0.27 | 0.11–0.21 |
| 0.9 | 0.10–0.24 | 0.13–0.19 |
どの仮定でも、差が0であるという仮説とは両立しにくい。ただし、試験データが135のときの下限は0.02〜0.10と、0に近い。また、これは「同じ試験データで、観測された差が0.16だった」という前提での区間で、この前提は公開資料からは確認できない。
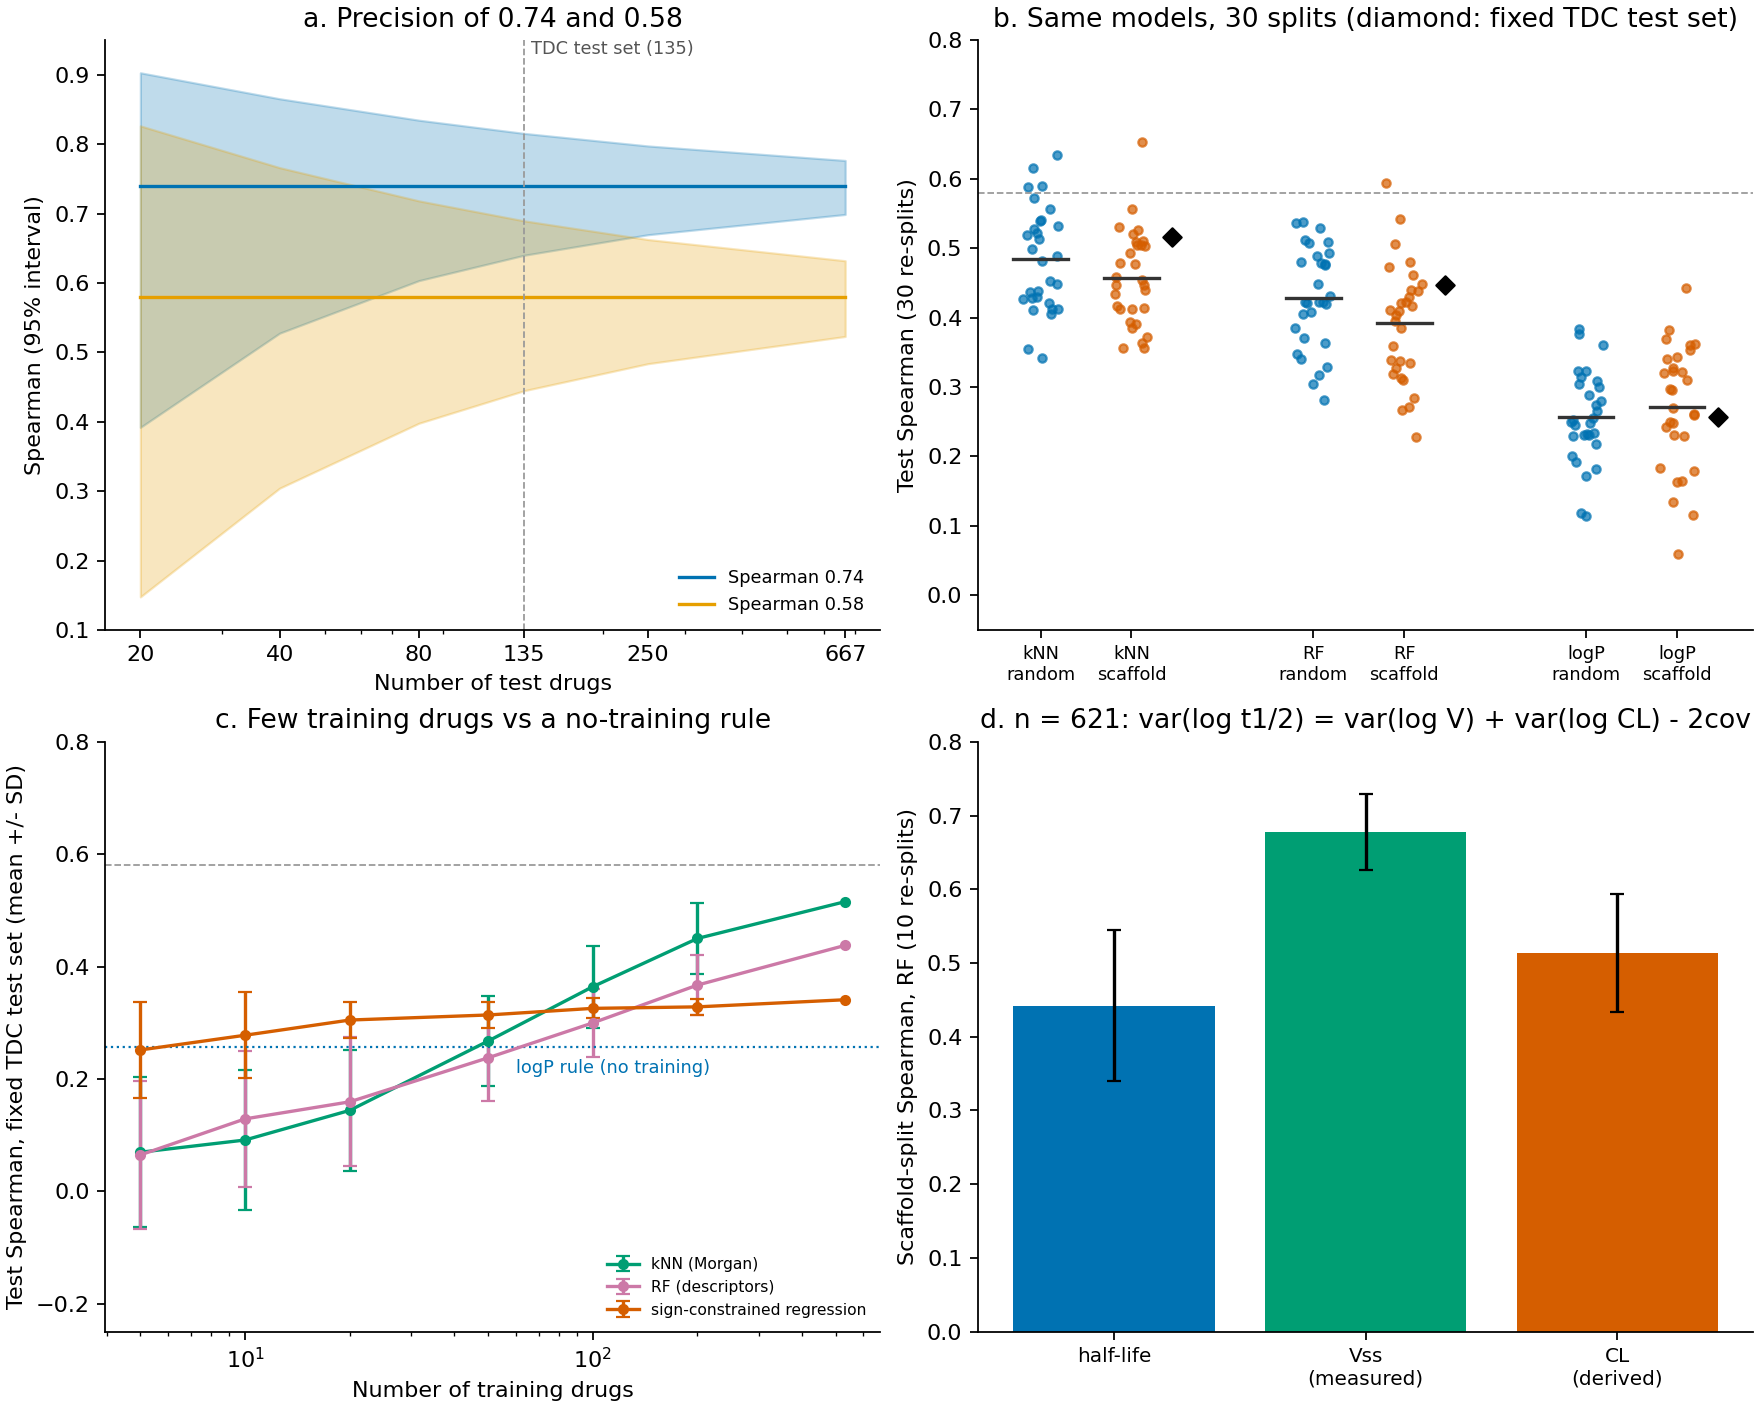
図1. (a) 試験の薬物の数ごとのSpearmanの95%区間(0.74と0.58)。破線はTDCの試験データ(135)。(b) 近傍法、ランダムフォレスト、logPだけの規則を、ランダム分割とスキャフォールド分割の30回で評価した試験Spearman(横棒は平均、菱形はTDCの固定の試験データ、破線は0.58)。(c) 訓練の薬物の数ごとの、TDCの固定の試験データでのSpearman(平均±標準偏差、各100回の無作為抽出。右端は532薬物すべて)。点線はlogPだけの規則。(d) 半減期、測定したVss、導出したCLの、スキャフォールド分割(10回)でのランダムフォレストの試験Spearman(平均±標準偏差)。
(出力:results/summary.json、results/split_baselines.csv、results/learning_curve.csv)
素朴な基準モデルはどこまで届くのか
二つの素朴な基準モデルを用意した。近傍法(Morganフィンガープリントの5近傍、Tanimoto類似度で重み付けした平均)と、13個の記述子(脂溶性、極性表面積、分子量、水素結合の数、酸性・塩基性の部分構造の数など)によるランダムフォレスト(300本)である。どちらも標準的なscikit-learnの実装で、調整していない。先端のモデルではなく、「先端のモデルとの差」を示すものでもない。
TDCの固定の試験データで
TDCの訓練・検証用532薬物で訓練し、固定の試験データ135薬物で評価した。
表2. TDC固定試験データにおける基準モデルと学習なし規則の性能。
| Method | Test Spearman, 95% interval |
|---|---|
| Nearest neighbors | 0.52 (0.37–0.65) |
| Random forest, predictions averaged across five seeds | 0.45 (0.29–0.58) |
| logP-only rule, no training | 0.26 (0.08–0.41) |
| Negative acidic-substructure count, no training | 0.26 (0.07–0.42) |
| Median by ionization class: acid, base, neutral, zwitterion; training/validation medians only | 0.28 (0.10–0.42) |
区間は、試験データの薬物を復元抽出するブートストラップ(2,000回)である。近傍法の0.52は、リーダーボード首位の0.576(第三者の集計による)より低い。しかし、区間に入る。ランダムフォレストと近傍法の差(−0.07、区間 −0.22〜0.07)は、この試験データの大きさでは判別できなかった。試験データの各化合物から、訓練データで最も似た化合物までのTanimoto類似度は、中央値0.39、10%点0.23、90%点0.66だった。
分割の種類と試験データの顔ぶれ
658の親化合物を、ランダム分割と、TDCの方式にならったスキャフォールド分割(グループの大きさの閾値と充填の順はTDCにならった自前の実装)で30回ずつ再分割し、同じ基準モデルを評価した。
表3. 再分割30回にわたる性能の平均と最小・最大。
| Split | Nearest neighbors | Random forest | logP rule |
|---|---|---|---|
| Random | 0.48 (0.34–0.64) | 0.43 (0.28–0.54) | 0.26 (0.11–0.38) |
| Scaffold | 0.46 (0.36–0.65) | 0.39 (0.23–0.59) | 0.27 (0.06–0.44) |
平均(最小〜最大)で示した。ランダムとスキャフォールドの平均の差は、近傍法で0.03(30回の再分割にわたる95%区間 −0.01〜0.07)、ランダムフォレストで0.04(0.00〜0.07)だった。分割の種類の影響は、0.16の差を説明するには小さい。 一方、試験データの顔ぶれによる幅は大きかった。スキャフォールド分割で、近傍法は30回中1回、ランダムフォレストも1回、0.576を超えた(ランダム分割では近傍法が4回)。試験データが違えば、同じ近傍法が0.36から0.65まで動く。
したがって、別々の試験データで得た数字を並べると、0.1前後(30回の標準偏差は0.07〜0.09)のずれが、モデルの違いとは関係なく生じうる。 同じ試験データでの比較には、この問題はない。
5分子で「予測力がある」とは
TDCのテストデータを固定し、学習に使う化合物を減らして評価した(各100回の無作為抽出)。素朴なモデルのほかに、事前知識として符号だけを与えた回帰も加えた。「logPが高いほど、塩基性が強いほど、半減期は長く、酸性が強いほど短い」という薬物動態の知識に従って、三つの特徴(logP、酸性部分構造の有無、塩基性部分構造の有無)の係数の符号を固定し、大きさだけを訓練の薬物から学習する(非負の最小二乗法)。
表4. 学習薬物数と固定試験データの平均順位相関。
| Training drugs | Nearest neighbors | Random forest | Sign-constrained regression |
|---|---|---|---|
| 5 | 0.07 | 0.06 | 0.25 |
| 20 | 0.14 | 0.16 | 0.30 |
| 100 | 0.36 | 0.30 | 0.33 |
| 532, all | 0.52 | 0.44, see note | 0.34 |
注:全体(532薬物)のランダムフォレストは、この表では乱数1回の値(0.44)で、前節の乱数5回の予測の平均(0.45)とは異なる。符号を固定した回帰は、予測が定数になった抽出(5薬物で約9%)を、順位の情報がないものとして0にして平均に入れた。
5薬物のとき、素朴なモデルは、ほぼ何も学べていない(平均0.06〜0.07、標準偏差0.13)。ただしこれは、ランダムフォレストと近傍法が5点では事実上の定数に近い予測になるためでもある。符号の知識を与えると、5薬物でも平均0.25になったが、これはlogPだけの規則(学習なし)の0.26とほぼ同じ水準で、規則を上回ったわけではない。 20薬物では0.30で、全体を使っても0.34と、あまり伸びない。符号を固定した回帰の抽出のうち、規則の水準以上になった割合は、5薬物で58%、20薬物で92%だった。
規則の選び方についても書いておく。logPと酸性・塩基性は、薬物動態の知識からまず試す記述子で、符号も知識に基づいて選んだ。ただし、結果を見る前に決めたわけではない。13個の記述子すべて(results/rules_all_descriptors.csv)について、全658化合物でのSpearmanを見ると、logPが0.27、酸性部分構造の数が−0.26で最も大きく、次いで芳香環の数0.21、環の数0.19、塩基性部分構造の数0.17だった。訓練・検証用の532薬物だけで見ても、上位はlogP 0.27、酸性部分構造の数 −0.26、環の数 0.24で、logPと酸性は同じように選ばれる(環の数は、事前知識の特徴には入れていない)。
つまり、少数の薬物で「予測力がある」と言うには、基準が0ではなく、0.25〜0.28程度の、事前知識だけの水準になる。ただし、Enchantは前臨床データで事前学習しており、事前知識を持つモデルの5分子の結果である。本記事の基準モデルは、それと同じ条件の再現ではなく、「どの水準から意味を持つか」の目安にすぎない。5分子の数値が公開されていないので、Enchantがこの水準を超えているかは分からない。なお、符号を固定した回帰が使う標準化には、ラベルのない532薬物の分布を使っており、「5薬物しかない」という想定とは厳密には異なる。
半減期は何を当てているのか
終末相の半減期は、分布容積(Vz)とクリアランス(CL)の比で決まる(t½ = ln2 × Vz / CL)。Vzの代わりにVssを使い、共通の621化合物で、CLをVssと半減期から逆算した(CL = ln2 × Vss / t½)。これは「導出CL」で、実際のCLではない。VzはVssより大きいことが多いので、導出CLは実際のCLより小さく出る傾向がある(CL × Vss / Vz)。また、半減期の測定の誤差は、導出CLにそのまま入る。
半減期の対数の分散は、恒等式で、次のように分かれる。
- var(log t½) = 0.37、var(log Vss) = 0.40、var(log 導出CL) = 0.42、共分散(Vss、導出CL)= 0.23(相関0.55)。
- 半減期の分散に対し、Vssの寄与(共分散÷分散)は47%、導出CLの寄与は53%だった(合計は恒等式で100%)。
VとCLが正に相関するため、半減期の分散(0.37)は、二つの分散の和(0.82)よりずっと小さい。ただし、この正の相関は、CLをVssから導出したことで、一部は必然的に生じる。実測のCLで確かめる必要がある。
予測のしやすさは次のとおりだった(スキャフォールド分割10回、ランダムフォレスト)。
表5. スキャフォールド分割10回でのPK量別予測性能。
| Predicted quantity | Test Spearman, mean and standard deviation |
|---|---|
| Vss, measured | 0.68 (0.05) |
| Derived CL | 0.51 (0.08) |
| Half-life | 0.44 (0.10) |
測定したVssは、構造から予測しやすい。導出CLの予測には、Vssの予測のしやすさが一部入り込んでいるので、「CLは予測しにくい」とまでは言えない。言えるのは、半減期の順位が、構造から予測しやすい量(Vss)より予測しにくい量になっていることである。半減期のSpearmanが高くても、それが分布容積を当てたのか、クリアランスを当てたのかは、半減期の相関だけでは分からない。用量の設計では、曝露(AUC)はバイオアベイラビリティと用量をCLで割った値で決まり、半減期は投与間隔と蓄積に効く。分布容積だけを当てて半減期を当てたモデルは、曝露を誤らせうる(この点は、本記事の分析で示したことではなく、薬物動態の関係からの推測である)。
Enchantの白書は、半減期以外のパラメータも表にまとめたとしている (3)。 クリアランスや分布容積が別に報告されているなら、この問いに答えられる。公開されたテキストからは確認できなかった。
考察
白書の0.74と比較対象の0.58は、入力情報と評価分割が同一であることを独立に確認できていない。0.74には前臨床データによる事前学習が含まれるとされる一方、比較対象の学習条件は未確認である。
本記事の固定試験データでは、学習を伴わない脂溶性・酸塩基の基準でも順位相関は0.25〜0.28程度だった。最近傍のTanimoto類似度の中央値は0.39であり、この結果も訓練化合物との距離に依存する。
Spearman相関は順位を測る。半減期の予測値が何倍ずれたか、VとCLのどちらがずれたかは、この指標だけからは分からない。順位の改善と、曝露を計算するための絶対値の精度は同じ結果ではない。
データとコードの公開および限界
計算コードは、TDCの三つのデータからresults/と図1を生成する(約20分)。データはライセンスの記載が「Not Specified」なので同梱していない。Harvard Dataverse(doi:10.7910/DVN/21LKWG)から取得してdata/に置く(half_life_obach.tab、vdss_lombardo.tab、admet_group.zipのhalf_life_obach/train_val.csvとtest.csv)。確認した版はrequirements.txtに固定した。
python -m pip install -r requirements.txt
python half_life_analysis.py
- Enchantの予測は入手できないので、本記事はEnchantの性能を測っていない。基準モデルは、事前学習も調整もない素朴な実装である。
- スキャフォールド分割は、TDCの方式にならった私の実装で、TDCのコードそのものではない(乱数の生成が違い、グループの大きさの閾値と充填の順は、査読者によるTDCのソースの説明に基づく。検証と試験の振り分けの条件が同一かは、PyTDCのソースと突き合わせていない。試験データの大きさは132〜133)。Murcko骨格は塩を除いた最大の断片から作ったので、TDCとは前処理が異なる。
- 30回の再分割は、同じ658化合物からの繰り返しで、独立な試験ではない。区間は再分割にわたるばらつきで、母集団への推測区間ではない。
- TDCの首位の0.576は、第三者の集計サイトの数字で、公式のリーダーボードは確認していない。
- 導出CLは、VzがVssに近いという仮定(実際はVzがやや大きい)と、半減期の測定の誤差を含む。ObachとLombardoの論文の補足資料には実測のCLが載っているが、今回は使っていない。
- 酸性・塩基性の分類は部分構造による粗いもので、pKaは使っていない。立体異性体は親化合物にまとめたので、薬物動態が異なる鏡像体は区別していない。
- 5薬物の基準(符号を固定した回帰)は、薬物動態の知識に基づく符号を前提とするので、事前知識なしに学習できる水準ではない。
- Obachのデータは文献の集成で、半減期の定義や測定条件が研究ごとに異なる。
- 白書の表の画像は読んでおらず、2024年の発表以降の更新は確認していない。
参照
- Iambic Therapeutics. Iambic Announces Pricing of Initial Public Offering. 2026 Oct 14. Company release; SEC Form 424B4.
- Iambic Therapeutics. Iambic Therapeutics Announces Enchant, an AI Platform that Predicts Clinical Outcomes from the Earliest Stages of Drug Discovery. 2024 Oct 29. Company release.
- Iambic Therapeutics. Enchant white paper. 2024 Oct. White paper.
- benchmarklist. TDC Half_Life_Obach. 2026 May 28 snapshot. Benchmark aggregation.
- Therapeutics Data Commons. ADMET benchmark group. Documentation. Accessed 2026 Oct 20.
- Therapeutics Data Commons. ADME datasets: Half_Life_Obach and VDss_Lombardo. Documentation. Distributed through Harvard Dataverse, doi:10.7910/DVN/21LKWG.
- Obach RS, Lombardo F, Waters NJ. Trend Analysis of a Database of Intravenous Pharmacokinetic Parameters in Humans for 670 Drug Compounds. Drug Metabolism and Disposition. 2008;36(7):1385–1405. doi:10.1124/dmd.108.020479.
- Lombardo F, Berellini G, Obach RS. Trend Analysis of a Database of Intravenous Pharmacokinetic Parameters in Humans for 1352 Drug Compounds. Drug Metabolism and Disposition. 2018;46(11):1466–1477. doi:10.1124/dmd.118.082966.
- Bonett DG, Wright TA. Sample size requirements for estimating Pearson, Kendall and Spearman correlations. Psychometrika. 2000;65(1):23–28. doi:10.1007/BF02294183.
- Zou GY. Toward using confidence intervals to compare correlations. Psychological Methods. 2007;12(4):399–413. doi:10.1037/1082-989X.12.4.399.