Boltz-2に100件の実験結果を足すと候補選択はどう変わるか
On this page
要旨
8標的の公開済み予測を再集計し、Boltz-2の結合親和性の予測部を少数の活性ラベルで調整した後の候補選択を調べた。100ラベル条件で次の100候補に含まれる活性化合物は平均10.75件から20.75件へ増えた。300ラベル条件の一部再採点では全件再採点に近い回収数を得たが、費用全体の削減を測定した結果ではない。類似度検索との比較では総活性化合物数と未知骨格の活性化合物数を区別し、新しい標的への一般化は未検証とした。
背景と目的
数万の化合物をAIで順位付けしても、全部を実験に回せるわけではない。次に100個だけ試せるなら、その100個に活性のある化合物がどれだけ含まれるかが問題になる。
Boltz-2はタンパク質と低分子の複合体構造に加え、結合に関するスコアも予測する。では、最初に選んだ100化合物の実験結果が返ってきた後、その結果を使って候補の順番を変えられるだろうか。
FuruiとOhueのプレプリント (1)は、8標的の既存スクリーニングデータでこの問いを検討した。本記事では著者公開の化合物別予測値 (2)を再集計した。100件のラベルで調整した場合、次の100候補に含まれる活性化合物は標的平均で10.75件から20.75件になった。これは新しい実験を行った結果ではなく、公開済みの測定ラベルと予測値を使ったランキングの検証である。
方法
調整するモデル部分
ここでの実験結果は、各測定条件における「活性あり/なし」の二値ラベルである。薬の効果量や、結合定数の実測値ではない。
手順は、最初にBoltz-2で化合物を順位付けし、その上位40・100・300件のラベルを使い、スコアを出す部分を調整するというものだった。複合体の情報を作るtrunkと構造生成部分は固定し、二つの結合親和性の予測部を更新する。headは、保存された構造・内部表現から結合に関するスコアを出す部分だ。比較する順位には二つのheadの予測確率の平均を使う。原著の方法 (1)と公開実装 (2)に対応する。
この入力の違いは重要である。高い初期スコアを付けたのに不活性だった化合物も、調整の材料になる。活性化合物だけを集めて学習する設計ではない。
Boltz-2の公式文書 (3)でも、結合する確率に対応する出力と親和性の値に対応する出力は区別されている。今回の二値ラベルによる調整を、「結合定数の精度が上がった」と読むことはできない。また、調整後のスコアが実際の陽性率に校正されているかは、候補順位の改善とは別に確かめる必要がある。
学習用と評価用の化合物
元の測定データはMF-PCBAスクリーニングベンチマークに由来する。原著のデータ記載 (1)によれば、今回の8標的は先行評価の10アッセイから選ばれたもので、結合部位を指定できなかったものなどが除かれている。任意の標的から無作為に選んだ8件ではない。
公開データには、学習に使った化合物と、候補選択を評価する化合物の区別がある。本記事の再集計では、その区別を維持した。
全条件で初期順位の上位300化合物を評価から除く。したがって、40件だけで調整する条件でも、残りの260件は評価へ戻さない。共通の評価集合は標的あたり約4.96万化合物で、陽性率は約0.27〜1.92%だった。調整用100件に含まれる活性化合物は標的によって4〜52件と幅がある。同じ「100件」でも、得られた陽性・陰性の構成は同じではない。公開データの列定義 (2)
以下の「次の100候補」は、この共通評価集合から選んだ100化合物を指す。初回の学習用測定で見つかった活性化合物は含めない。100件の調整用測定と、次の100件の測定を合わせれば、予定する測定は少なくとも200件になる。前処理、検証用測定、再測定、活性確認の費用は別に必要である。
結果と指標の解釈
上位100候補の活性化合物数とAP
表1と図1の比較では、公開予測値からAP、上位1%の濃縮係数、上位100候補の活性化合物数を計算し、著者の保存済み結果と照合した。モデル推論やheadの学習は実行していない。
表1 調整用ラベル数と候補選択の成績
| Adaptation labels | AP: unadapted → adapted | Geometric mean of per-target AP ratios | Active compounds in the next 100: unadapted → adapted |
|---|---|---|---|
| 40 | 0.0523 → 0.0685 | 1.24× | 10.75 → 17.63 |
| 100 | 0.0523 → 0.0869 | 1.56× | 10.75 → 20.75 |
| 300 | 0.0523 → 0.1339 | 2.14× | 10.75 → 34.38 |
APと活性化合物数は8標的の算術平均。倍率は各標的で比を求めた後の幾何平均であり、表の平均APどうしの比ではない。各標的の値は添付CSVで確認できる。
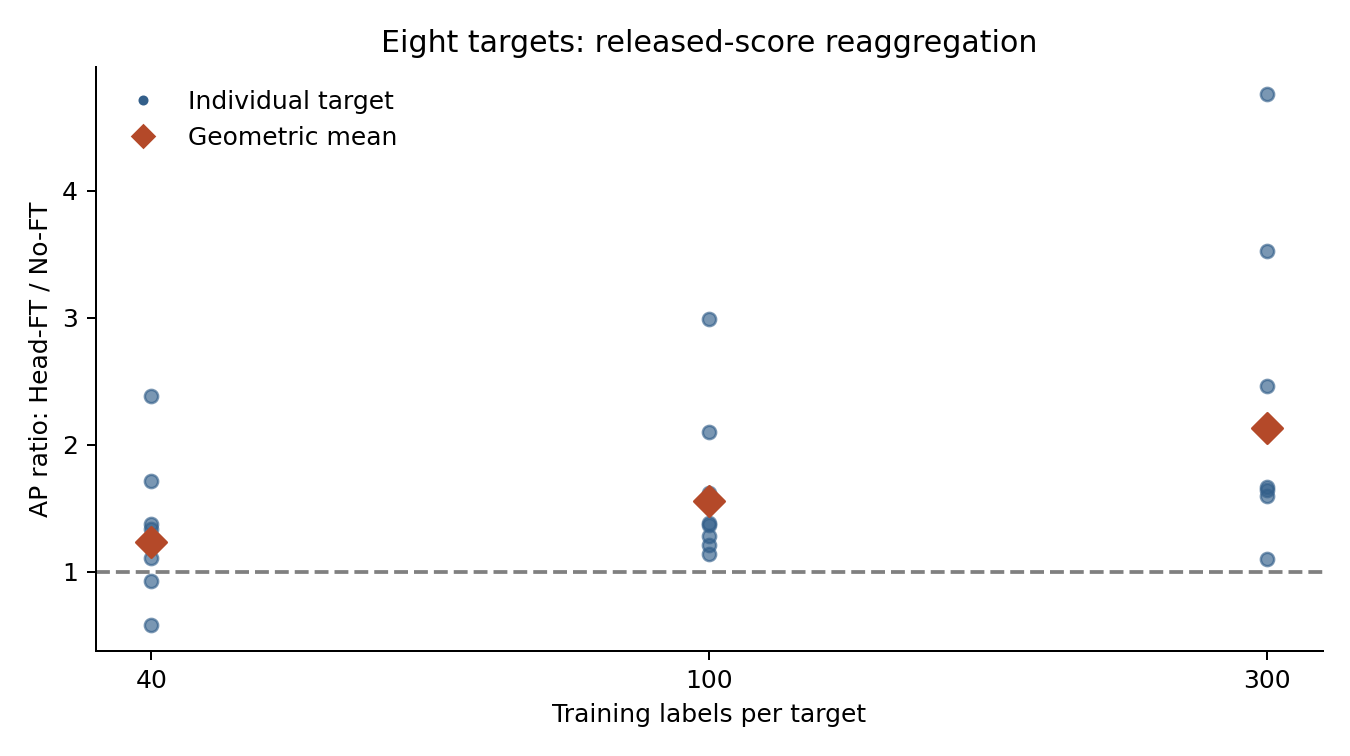
図1 ラベル数とAP改善比。 点は各標的、ひし形は8標的のAP比の幾何平均。破線の比1は改善なしを示す。
precisionは選んだ候補のうち活性だった割合、recallは評価集合にある全活性化合物のうち拾えた割合である。APは、順位の上から候補を増やしていくときのprecisionとrecallをまとめた指標だ。AP 0.0869を「次の100件の8.69%が活性」と読み替えることはできない。測定できる数が100なら、その位置での活性化合物数とprecisionを直接見る。今回の100ラベル条件では、後者は平均20.75/100、つまり20.75%だった。
上位1%の濃縮係数は、上位1%での活性割合を評価集合全体の活性割合で割る。このデータでは上位1%は約496〜497化合物なので、上位100件とは選択予算が違う。指標の改善倍率と、実験に回す数を混ぜないようにしたい。
図には標的間の違いも残した。同じ予算を足しても効果は一様ではない。8標的での傾向を、新しい標的で確実に同じ改善が得られるという保証へ変えることはできない。
再採点候補数と活性回収数
もう一つの問いは、未調整のNo-FTスコアで候補を絞った後に、調整済みheadで採点し直す方法である。ここでは採点し直す候補数をM、最終的に選ぶ数を100とする。No-FT順位は、学習候補を選んだ標準推論の初期順位とは区別する。
公開スコアから、未調整の順位の上位M件だけを取り出し、調整済みのスコアでその中を並べ直した。300ラベル条件では、M=5,000のときに得られる活性化合物数は平均34.75件で、全評価集合を採点し直した34.38件に近かった。
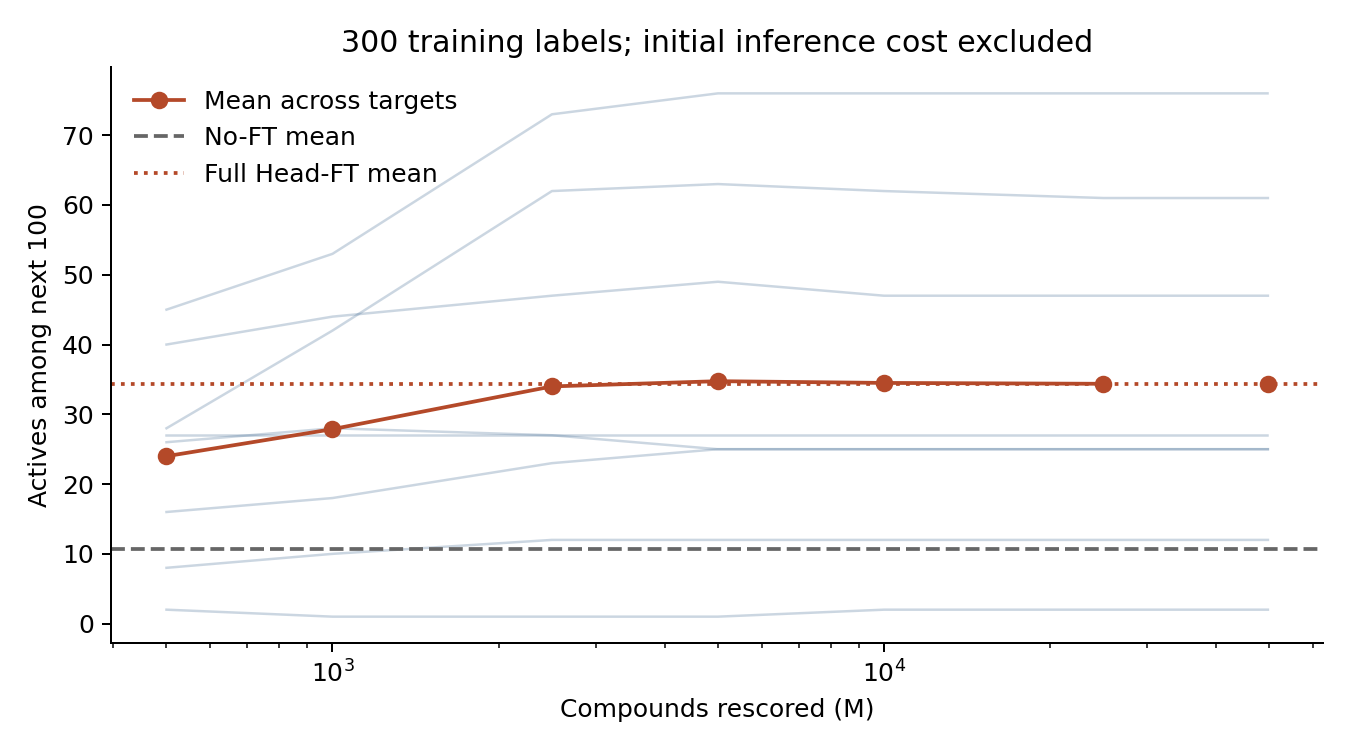
図2 再採点候補数と活性回収数。 300ラベル条件。薄線は各標的、太線は8標的の平均。破線は未調整の平均、点線は全件再採点の平均である。横軸は対数目盛。
Mを増やせば活性化合物数が必ず増えるわけではない。候補を追加すると、その中に調整後のスコアが高い不活性化合物も入ってくる。5,000件の方が全件よりわずかに高い平均だったことも、「少なく採点すれば有利」という一般則にはならない。
一方、最初の絞り込みで落とした化合物は、その後どれだけ上手に順位付けしても戻らない。No-FT順位の上位M件に含まれる活性化合物数をA(M)とすると、100候補で拾える活性化合物数には
\[ H_{100}(M) \leq \min\{100, A(M)\} \]
という上限がある。この上限と実際の回収数を一緒に出すと、「入口で活性化合物を落とした」のか、「残った化合物の順位付けが弱い」のかを分けられる。添付コードは、各Mの回収数、残っている活性化合物の数、上限を出力する。
約5万件から5,000件への絞り込みは、追加のhead評価件数を約90%減らす。しかし初回のBoltz-2推論、内部表現の保存、調整用ラベルの取得、学習は済んでいる前提だ。実行時間や創薬費用が全体で90%減るという結果ではない。
例えば、初回推論などの共通費用をC0、head評価1件あたりの費用をc、全評価集合の大きさをnと置くと、全件再採点とM件再採点の費用差はc(n−M)になる。全体に対する削減率は
\[ \frac{c(n-M)}{C_0+cn} \]
で、C0が大きいほど小さくなる。これは費用の分解を示す式であり、この研究の実測費用を推定したものではない。
同じラベルを使う類似度検索との比較
実験ラベルが手元にあるなら、Boltz-2の調整以外にも使い道がある。その比較で外せないのが、既知の活性化合物に似たものを選ぶ方法だ。
著者が公開した骨格別の集計CSVを、300ラベル・次の100候補の条件に限定して平均すると、表2のようになる。ここは著者の骨格注釈を集計した値であり、本記事で分子の骨格や類似度を再計算した結果ではない。
表2 同じラベルを用いた候補選択と未知骨格の回収
| Method | Active compounds | Active compounds with scaffolds absent from the training set |
|---|---|---|
| Unadapted Boltz-2 | 10.75 | 7.63 |
| Adapted heads | 34.38 | 22.13 |
| Maximum similarity to a known active | 34.75 | 13.75 |
出典:著者公開の骨格回収数CSV (2)。類似度はMorgan fingerprintのTanimoto係数、骨格はBemis–Murckoの定義に基づく。右列は活性化合物の数であり、骨格の種類数ではない。同じ骨格を持つ複数化合物も数える。
総ヒット数だけなら、類似度検索の平均は調整後headに劣らなかった。一方、学習集合にない骨格の活性化合物は、調整後headで多かった。目的を「活性化合物をできるだけ拾う」と置くか、「異なる骨格の候補も確保する」と置くかで、この比較の意味が変わる。ただし、この平均差だけで統計的な優越性を主張することはしない。
学習集合にない骨格でも、既知の化合物に部分構造が似ている場合はある。「未知骨格」と「低類似度」は同じ条件ではない。骨格が新しいことも、作用機序や特許性が新しいことを意味しない。
通常の教師ありモデルと比較するときにも、同じ化合物・ラベルを使うことが出発点になる。さらに、モデル選択や反復回数、利用する事前学習情報、計算時間を揃えるか、差を説明する必要がある。調整済みのモデルをラベルなしのモデルとだけ比べても、追加ラベルをどう使うのがよいかは決まらない。
考察
今回の改善は、既存の活性ラベルと保存済みスコアに対するものだ。未調整対照も、調整後headと同じ保存済み構造・内部表現・採点経路を使う。学習候補を選ぶ初期順位は標準推論で作られており、評価時の未調整順位とは異なる。
原研究では、評価集合の初期順位末尾20化合物を学習中の検証に使い、固定した最終epochを評価している。最終評価集合のラベルに一切触れない設計とは同一でなく、本記事もその分割を変更していない。headの学習は条件ごとに一度なので、標的間のばらつきから再学習時の乱数依存性までは分からない。
保存された予測では候補選択が改善した。ただし、その改善が新しい標的でも再現するか、同じラベルを使う類似度検索より有利かは、この再集計の成績だけでは決着しない。
結論
8標的の保存済み予測では、少数の活性ラベルによるheadの調整で上位候補の活性化合物数が増えた。同じラベルを使う類似度検索との比較では、総活性化合物数と学習集合にない骨格の活性化合物数で異なる傾向があり、候補選択の目的を分けて評価する必要がある。この後ろ向きの再集計から、新しい標的での改善や創薬費用全体の削減率は決められない。
データとコードの公開状況
入力はBoltzFTのコミットa31c79a8420c1156a876f007dbdc52107cd0e957に固定した8標的の予測CSVと、著者の参照集計である。APと上位1%の濃縮係数を再計算して照合し、追加再採点の回収数も検証した。上位100候補と2段選択の同点は公開データの評価順で解決する。上位1%の濃縮係数は著者の保存値との照合のためNumPy 1.26.4の既定ソートに合わせる。予測確率の校正、headの再学習、ウェット実験は実施していない。
再集計コード・結果・図をダウンロード。入力の約98 MBの圧縮CSVは同梱せず、取得スクリプトで固定版をダウンロードする。著者由来の集計データには元のライセンスを添付した。図は公開数値から本記事用に作図した。
参照
- Furui K, Ohue M. Adapting Boltz-2 with limited experimental activity data improves early enrichment in virtual screening. arXiv [プレプリント]. 2026 Sep 21;2609.24302v1. Version examined.
- Furui K, Ohue M. BoltzFT: code, per-compound predictions, evaluation splits and reference summaries [Software and dataset]. Commit a31c79a8420c1156a876f007dbdc52107cd0e957. MIT License. Fixed repository version.
- Boltz developers. Boltz-2 prediction and output documentation [Internet; cited 2026 Oct 28]. 公式文書.