AlphaProtein Novoで実験に回す酵素候補をどう絞るか
On this page
要旨
AlphaProtein Novoの酵素候補選別について、プレプリントと公式実装から触媒モチーフ、反応別の構造指標、複数配列による評価を検討した。公表された二つの件数からWilson区間を再計算したが、反応と成功条件が異なるため性能比較には使えない。予測seedや再設計配列の通過率は計算上の一貫性であり、実験成功確率ではない。実測の活性と選別の性能は、分母と実験予算を含めて別に解釈する必要がある。
背景と目的
AIで酵素を設計できるなら、作りたい反応を指定するだけで触媒が手に入るのか。AlphaProtein Novoの研究を読むと、その間にある仕事が見えてくる。反応に必要な原子配置を仮定し、候補を生成し、予測構造から実験に回す候補を選ぶ。その選別方法も、実験結果を受けて改良している。
この研究で注目したいのは、構造予測を活性の代用にするのではなく、反応機構に基づく指標で実験候補を絞っている点だ。ただし、よい構造スコアから反応速度や成功確率が直接得られるわけではない。どの候補集団で、何を成功と呼び、何件を選んだかまで読む必要がある。
対象と確認範囲
以下は2026年10月5日公開の原著v1 (1)と公式実装 (2)に基づく。論文はプレプリントで、査読前である。私はモデルを実行したり酵素を測定したりしていない。後半の計算は、論文に記載された件数と、明示した仮想例の読み解きである。
反応機構の仮説を設計の入力にする
酵素は基質を結合するだけでなく、化学反応を進める。基質とは反応させたい分子、触媒残基とは反応に関与するアミノ酸である。どの原子を近づけ、どの中間体を安定化するかが重要になる。
公式実装では、触媒残基とリガンドの三次元配置をモチーフとして与える。リガンドはここでは基質や反応中間体など、タンパク質と相互作用する分子を指す。遷移状態の類似体や反応中間体を使い、その配置を支えるタンパク質を生成する。原子を一部だけ固定する指定や、既存の設計を部分的に変えるpartial diffusionも用意されている。
たとえばセリンエステラーゼの例は、切断に関与するSer–His–Aspの触媒三残基と、反応中間体を安定化する水素結合の配置を含む。自然酵素の結晶構造からモチーフを得る例もある。したがって、ここでいうde novo設計には、新しい足場を作ることと、既知の化学的知識を入力することが共存している。
処理は大まかに、モチーフを与える、構造と配列を生成する、LigandMPNNで同じ足場に別の配列を作る、AlphaFold 3(AF3)で構造を予測する、指標を計算する、実験する、という順序になる。足場とは触媒配置を支えるタンパク質の骨格、LigandMPNNはその構造に合うアミノ酸配列を設計するモデルである。入力モチーフの妥当性は、その後の構造スコアだけでは保証されない。
構造の確からしさと反応に必要な配置を分ける
pLDDTなどの信頼度指標は、モデルが予測構造にどれほど自信を持っているかを表す。一方、触媒として候補を選ぶには、反応に関わる局所的な配置を見る必要がある。
公式実装は、反応ごとに評価する状態や幾何指標を変えている。
表1 反応別の予測対象と実験評価
| 対象 | 予測で確かめること | 実験で確かめること |
|---|---|---|
| Kemp脱離反応 | 触媒塩基と遷移状態類似体の配置 | 活性と速度論パラメータ |
| エステル加水分解 | 触媒三残基の相互作用、基質結合状態と中間体の配置の整合性 | 加水分解活性、基質濃度による速度の変化 |
| ニトレン転移反応 | ヘムと基質の配置、結合形成に関わる原子間距離 | 生成物量、環の大きさの選択性、鏡像異性体の選択性 |
基質が結合した状態だけをうまく予測できても、中間体の配置が大きく変わるなら、想定した触媒配置が成立するか疑問が残る。そのため複数の反応状態を評価する。ただし、異なる状態の静的な予測構造を比べることは、反応経路を動力学的に計算することとは異なる。
具体例として、公式コードのpiperidine_propensityは、窒素から六員環形成側の炭素までの距離と、五員環形成側の炭素までの距離との差である。
\[ D=d(N,C_{\mathrm{PIP}})-d(N,C_{\mathrm{PYR}}). \]
六員環側が相対的に近ければ負になる。名前にpropensityとあっても、単位はÅであり、ピペリジンが生じる確率ではない。たとえば距離が2.5 Åと3.5 Åなら差は−1.0 Åだが、そこから生成物比を計算する変換式はこの指標に含まれていない。実装の距離計算 (2)を読むと、この区別がはっきりする。
同じ足場で配列を変えても配置が保たれるか
論文の選別は、一つの予測構造を採点して終わらない。予測の乱数seedを変えるmulti-seedと、同じ足場から複数の配列を設計するmulti-resequence(MR)を使う。
MRでは、それぞれの配列について構造予測とフィルタ判定を行い、同じ足場から作った配列が何本通過するかを見る。偶然一つの配列でだけ成立した配置より、配列を変えても成立する配置を優先する、という選別の考え方である。著者らはこれを足場の評価として解釈している。
ここには注意点がある。AF3のseedは実験の反復測定ではなく、再設計した配列も独立な自然酵素の標本ではない。通過割合が8/10であっても、「合成すると80%の確率で活性を持つ」とは読めない。同じモデルと同じモチーフに依存する予測は、共通の誤りを持ちうる。
論文では、実験済み候補を後から選別する解析に加え、改良したフィルタを使って新しい候補を選び、実験する検証も行っている。この前向きの検証が、候補選別に使えるかを考えるうえで重要になる。原著Figure 4と本文 (1)は、後ろ向きの解析と前向きの設計ラウンドを分けて示している。
公表件数と例示計算
原著Table 1 (1)にあるヒット率は、すべての生成候補に対する成功率ではない。実験した候補を、同じパイプライン設定で生成した群(facet)に分け、その中の最良の群を報告している。ヒットの定義も反応ごとに異なるため、反応間の率をそのまま比較できない。
さらに厳しいフィルタで高い率が得られても、残る候補数が少ない場合がある。論文には、セリンエステラーゼでseedと再配列の条件を厳しくした後ろ向き解析において、9候補中5候補がヒットした例がある。このヒットは複数回の触媒回転を示し、基質4MU-Acが100 µMの条件で\(k_{\mathrm{obs}}>0.003\ \mathrm{s}^{-1}\)を満たす候補を指す。\(k_{\mathrm{obs}}\)は、固定した基質濃度で測った酵素量あたりの生成物形成速度である。一方、Kemp脱離反応の最終ラウンドでは、新規足場90候補のうち5候補が、通常のヒット判定より厳しい\(k_{\mathrm{obs}}>1.0\ \mathrm{s}^{-1}\)を満たしている。
この二つは反応も成功条件も異なるため、性能の優劣を比較する組ではない。ただ、分母を省くと何を失うかを確認する計算には使える。件数だけからWilsonの二項比率区間 (3)を計算すると次のようになる。
表2 公表件数と参考二項比率区間
| 記載された集計 | 割合 | Wilson 95%区間 |
|---|---|---|
| セリンエステラーゼ、後ろ向きに選別した9候補中5ヒット | 55.6% | 26.7–81.1% |
| Kemp脱離反応、最終ラウンド90候補中5候補が上記速度を超過 | 5.6% | 2.4–12.4% |
この区間は、同じ成功確率を持つ独立な二項試行という仮定で、件数の少なさを可視化した参考値である。最良条件を選んだことによる偏りや、足場間の依存、新しい反応への適用の不確実性は含まない。将来の実験ヒット率の予測区間としては使わない。
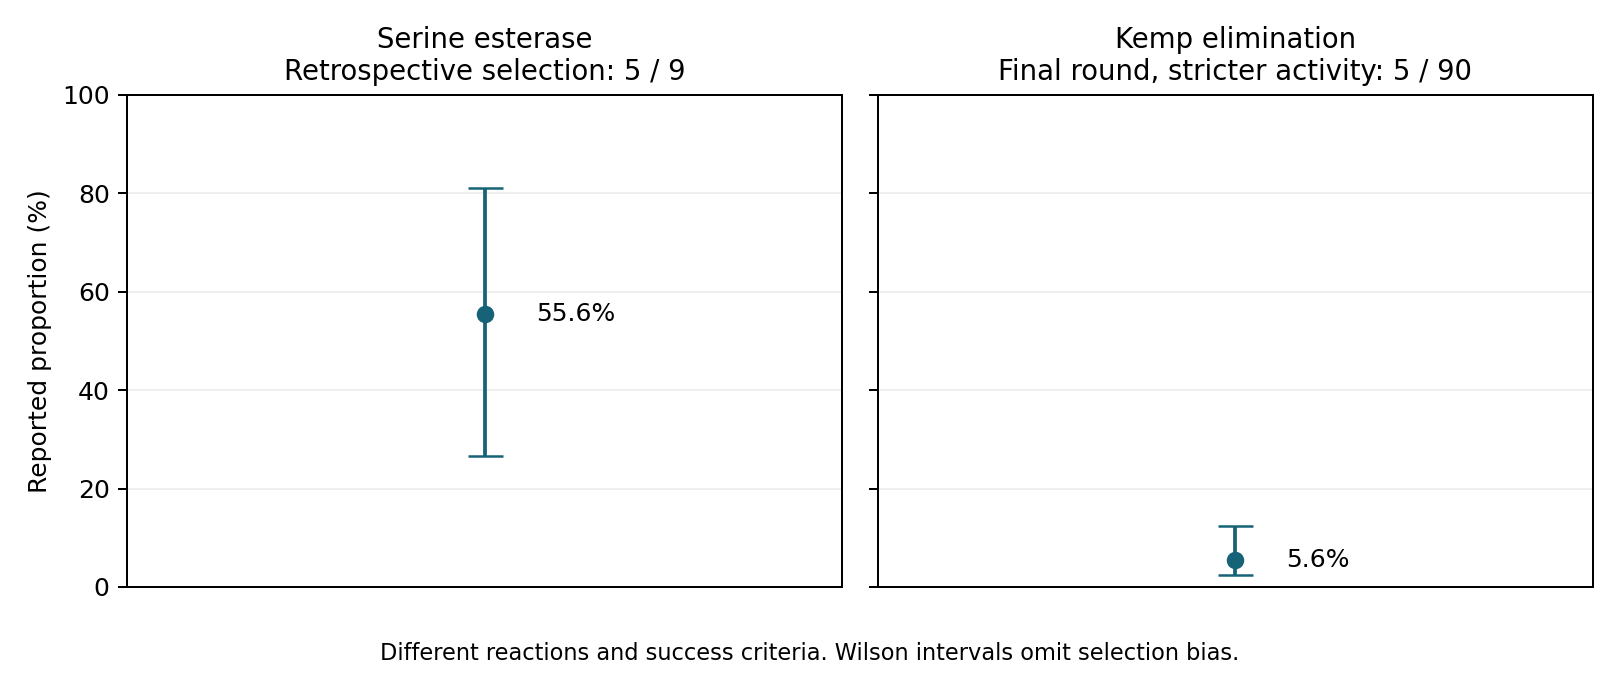
図1。 論文中の二つの別々の集計から計算した参考区間。異なる反応と成功条件を扱っており、率の大小で手法の優劣を比較する図ではない。
実験候補を選ぶときは、通過後のヒット率に加えて、何候補を残せるかを見る必要がある。たとえば、100候補から20候補を選び、その中に8ヒットある仮想例なら、選別後のヒット率は40%だ。さらに厳しくして4候補だけ残し、そのうち3ヒットなら75%になる。しかし、後者が回収したヒットは3件である。実験予算が20件あるなら、厳しい条件だけでは残り16枠の選び方が決まらない。
この仮想例はAP Novoの実測値ではない。同じヒット率でも、選別率と実験枠が異なれば回収されるヒット数は変わる。率の高さだけでは、探索全体で得られる候補数は決まらなかった。
考察
ピペリジン合成の結果は、作りたい生成物の選択性を変えられることを示す。報告された先導候補は22 turnovers、PIP:PYRが99:1、鏡像体過剰率94%だった。turnoverは酵素量に対してどれほど生成物を作ったかの量であり、反応速度定数ではない。PIP:PYRは六員環と五員環の生成物比である。鏡像体過剰率は、互いに鏡像の関係にある二つの異性体の割合の差を表し、94%なら97:3に相当する。原著Table 1 (1)
DEHP加水分解では、通常の水系条件で天然酵素より高い活性を示した、という一律の結果ではない。設計酵素の強みは、高温や高濃度のアセトニトリルという、比較対象の天然酵素が失活する条件で活性を保つことにある。測っている生成物は、DEHPを一段階加水分解したMEHPであり、完全分解や環境浄化の実証ではない。用途に必要な条件を定めると、候補の順位が変わりうる。
また、生成された足場が天然酵素の配列をそのまま使っていなくても、天然酵素と似た構造に至る場合がある。論文では高活性セリンエステラーゼと天然型トポロジーの関係も調べている。新しい配列、新しい足場、既知酵素と異なる構造、新しい反応選択性は、それぞれ別に確認すべき性質である。
創薬との接点は、まず目的分子を作るための触媒や合成経路を増やすことにある。ピペリジンが医薬品でよく使われる骨格だからといって、この研究だけで薬効、体内動態、安全性、臨床成功が予測できるわけではない。
結論
構造スコアが高いことだけで、反応状態や配列を変えたときの活性は確定しない。AlphaProtein Novoの実測で示された活性と、計算による候補選別の性能は、同じ結果ではない。候補選別は、反応ごとの成功条件、残る候補数、実験予算に即して解釈する必要がある。
データとコードの公開状況
計算コードと結果には、図1のWilson区間と仮想例の集計を再計算するPythonコード、入力CSV、結果CSV、実行手順を含めた。標準ライブラリだけで集計でき、図の再作成にはmatplotlibを使う。原論文の図、配列、モデル重み、公式コードは配布物に含めていない。
公式実装はコミットe7ce276cb4a1f68c2ba7d5aa793192cfcb4845c8を確認した。READMEの例は実行時間のため、再配列数やfolding seedなど一部設定を論文から減らしている。公開例を動かすことと、論文の全実験を再現することは区別する必要がある。ソースコードのライセンスとは別に、モデル重みと出力には利用条件がある。公式README (2)
参照
- Wu Z, Abramson J, Frerix T, Chu AE, Zhang RK, Schulz L, et al. Designing enzymes for new-to-nature chemistry and non-natural substrates with AlphaProtein Novo. bioRxiv [Preprint]. 2026 Oct 5; version 1. Version examined.
- Google DeepMind. AlphaProtein Novo: official implementation [Software]. Commit e7ce276cb4a1f68c2ba7d5aa793192cfcb4845c8. Fixed version and README.
- Wilson EB. Probable Inference, the Law of Succession, and Statistical Inference. Journal of the American Statistical Association. 1927;22(158):209–212. doi:10.2307/2276774.