AIが選んだアプタマーは何に結合していたのか
Googleのアプタマー探索報告を読み、結合量・ビーズ背景・標的選択性を区別する。公開集計から閾値別の改善率を再計算し、分母と判定条件の整合性を確認する。
On this page
ミオグロビンに結合するDNAを探していたはずなのに、実験を一周回すと、ヒット率が10.2%から3.7%に下がった。ところが、未補正の濃縮を見ると改善したように見える。何が起きたのだろう。
Google Researchが2026年10月16日に紹介したアプタマー探索には、この気になる失敗が含まれている。AIエージェントが候補を設計し、実験結果を読んで次の候補を作る。報告によれば、途中で増えたのは、狙ったタンパク質だけでなく別のタンパク質や実験用ビーズにも付着する候補だった (1)。
面白いのは、AIが実験を繰り返したこと以上に、結合の指標を分けると、探索の進歩が逆向きに見えることだ。ただし、原報告の本文と補足表では、成功を数える規則の説明がそろわない箇所もある。
本記事では、公開された集計値を検算し、何が改善したと読めるか、何をまだ検証できないかを整理する。対照実験を含むフィードバックから設計を修正した実例としては興味深い。一方、ヒット率の上昇をそのままAIの優位性や薬の完成に読み替えることはできない。
資料確認日は2026年10月19日。対象はCuttsらの10月12日付研究報告 (2)である。査読済み論文として扱わず、以下の計算も、配列・活性の生データからの再解析とは区別する。
標的のほかにビーズにも結合する
アプタマーは、折りたたまれた核酸の構造などを通じて分子に結合する。本研究では一本鎖DNAの候補を合成し、タンパク質を固定した磁気ビーズと混ぜる。残った候補を増幅・シーケンスし、投入前のライブラリに対して、どの配列が濃縮されたかを調べる。
ここで、タンパク質付きビーズから多く回収できたことだけでは、標的への結合とは言い切れない。ビーズ側に付着しても回収されるからだ。
報告では、標的付きビーズ、標的を載せないビーズ、別のタンパク質を使う対照を測定する。主な標的はミオグロビンとαトロンビン。途中からHER2も対照に加わる。標的を替えた比較と、表面を替えた比較で、違う種類の失敗を見ようとしている。Methods / PDF pp. 15–17
ミオグロビンの第2ラウンドでは、G-quadruplex、略してG4と呼ばれる構造を持つ候補に探索が偏った。G4はグアニンに富む配列が作りうる四重鎖構造であり、G4だから一律に悪いわけではない。実際、この研究でも標的によって有望な構造は違う。ただ、ミオグロビン探索で増えたG4群には、対照にも結合する候補が多かった、と著者らは解釈している。
次のラウンドでは、構造群の配分を変え、ビーズ由来の背景を考慮しながら新たな候補を設計した。報告されたミオグロビンのヒット率は第3ラウンドで33.5%に上がった。Results R.3 / PDF 4–6 pages
33.5%は何を何で割った値か
ヒット率を追う前に、分母をそろえたい。原報告の補足表S3には、新しく標的向けに設計した候補、他標的向けの候補、既存候補の持ち越し、対照などが分けて載っている。図で大きく示されたヒット率は、プール全体の成功率ではない。
表1 新規の標的向け候補を分母とする報告ヒット率。
| Target | Round 1 | Round 2 | Round 3 |
|---|---|---|---|
| Myoglobin | 20/196 = 10.2% | 9/244 = 3.7% | 184/549 = 33.5% |
| α-Thrombin | 0/167 = 0% | 54/208 = 26.0% | 131/311 = 42.1% |
新規の標的向け候補を分母とした、報告の代表値を再計算した表。第1ラウンドのミオグロビンには、後述する閾値表記の問題がある。Supplementary Table S3 / PDF 25–26 pages
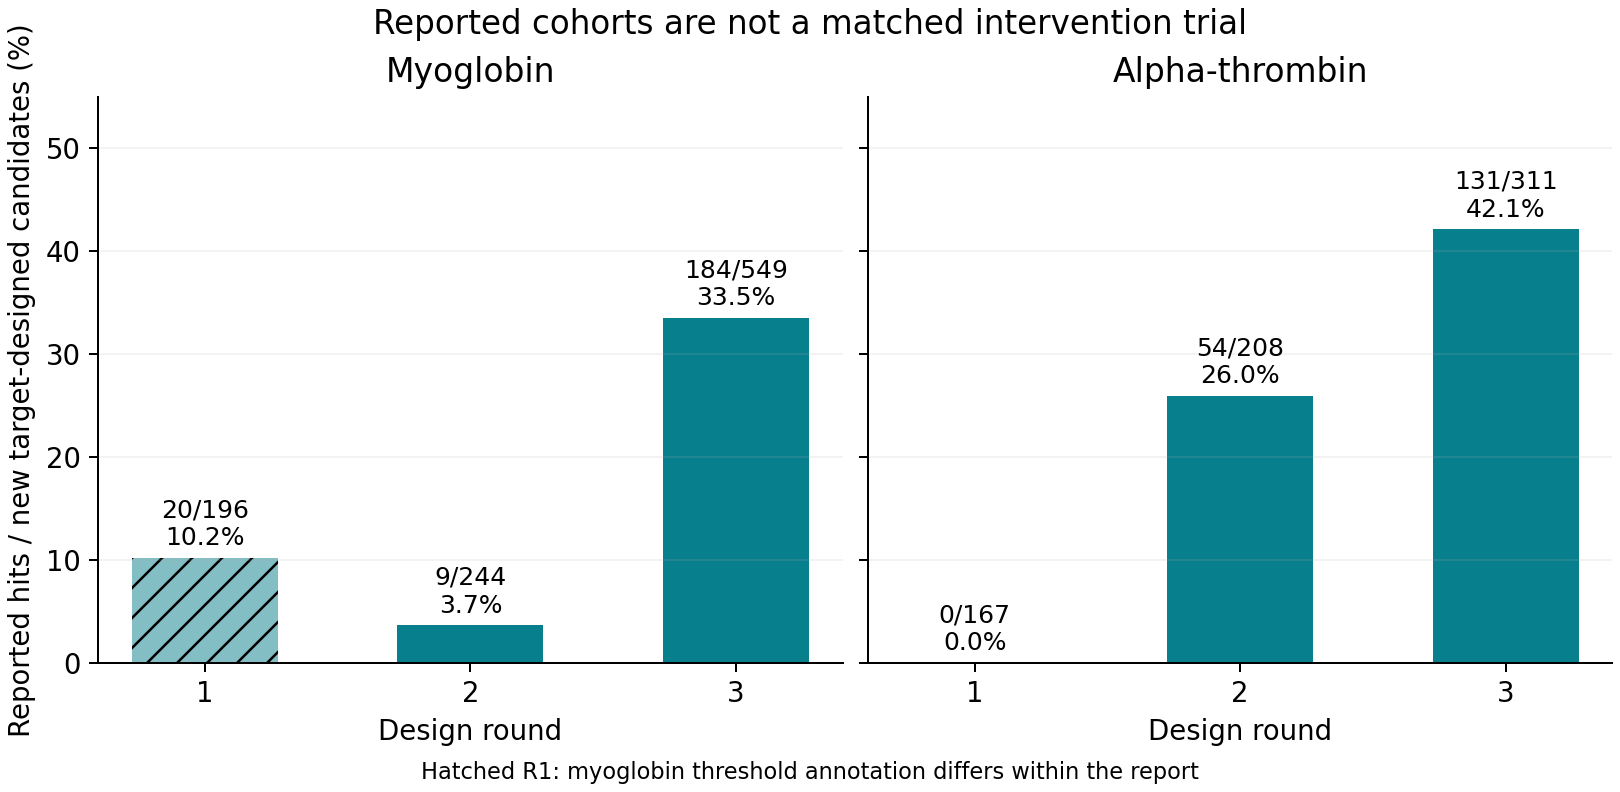
図1 新規標的向け候補の報告ヒット率。筆者による集計値の再描画であり、独立した追試ではない。
ミオグロビンの第2→第3ラウンドは、ヒット率では約9.1倍だが、ヒット数では9本から184本へ約20.4倍に増える。候補数も244本から549本へ2.25倍になっているので、同じ数字にはならない。探索量を固定した改善と読むことはできない。
また、新しく作った候補と、既知のモチーフを含まない候補も同義ではない。αトロンビンの第3ラウンドでは、既知モチーフ由来を除いた値は106/286 = 37.1%。全新規候補の42.1%とは分けて読みたい。ミオグロビンでも表S3の厳密なde novo部分集団は184/547 = 33.6%とされる。ここでは主表の新規候補549本を用い、途中で分母を切り替えない。
報告の「specificity」も別の分母である。著者らは、対照標的も測ったベンチマークで、統計的に結合と判定された候補のうち、意図した標的だけに結合した割合と定義している。ミオグロビンでは75.0%→19.1%→72.4%と記載されるが、これは上の20/196などと同じ母集団の割合ではない。二つを掛けて「本当に使える候補の確率」を作ることはしない。
閾値を変えても増えるが9倍とは限らない
報告のMethodsには、判定を緩めた場合と厳しくした場合の、第2→第3ラウンドのミオグロビンの集計値もある。
表2 原報告の別閾値での分子・分母から再計算したヒット率。
| Criterion | Round 2 | Round 3 | Difference | Ratio |
|---|---|---|---|---|
| Lenient | 16/244 = 6.6% | 211/549 = 38.4% | +31.9 percentage points | 5.9-fold |
| Headline | 9/244 = 3.7% | 184/549 = 33.5% | +29.8 percentage points | 9.1-fold |
| Strict | 6/244 = 2.5% | 85/549 = 15.5% | +13.0 percentage points | 6.3-fold |
元の分子・分母から筆者が再計算。緩い条件はFDR < 0.05、log2 fold change > 0.5、ビーズ補正残差 > 0.5。厳しい条件はFDR < 0.01、log2 fold change ≥ 1.5、補正残差 > 1.5と記載される。Methods / PDF 17 pages
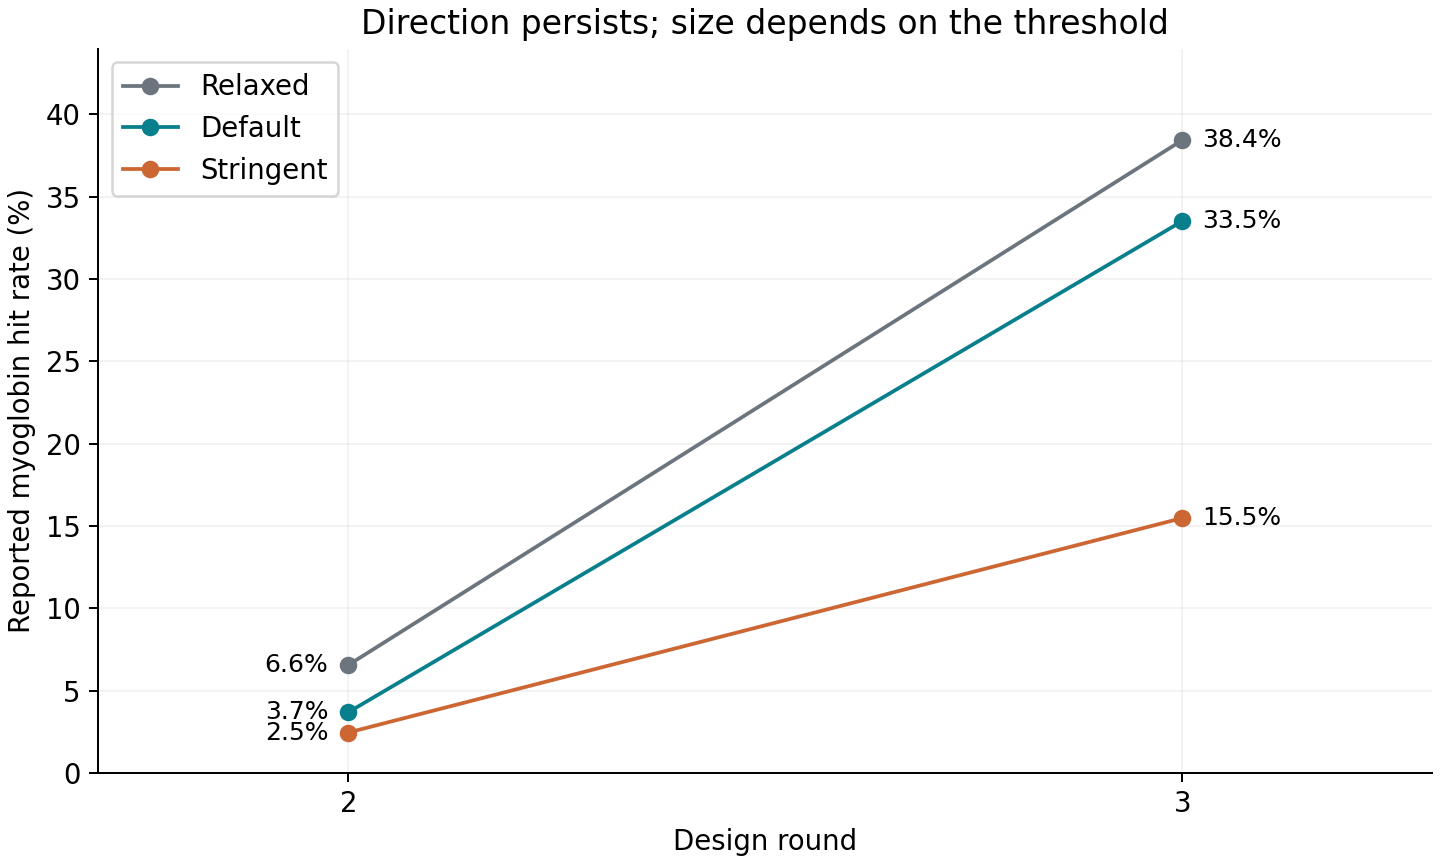
図2 閾値別の報告ヒット率。筆者による集計値の再描画。上昇の方向は共通するが倍率は異なる。
この集計範囲では、増加する方向は共通している。一方、「約9倍」という大きさは判定条件に依存する。厳しい条件なら約13ポイント増、緩い条件なら約32ポイント増である。大きな倍率だけを見出しにすると、この幅が落ちる。
これらは著者らの別閾値での集計を検算した結果だ。こちらで生データへ閾値を適用し直したわけではない。配列群には似た設計や共通の由来があるため、各候補を独立な試行と仮定した信頼区間や、新しい有意差検定も追加していない。
補正したら候補が増えてよいのか
ビーズ背景の補正自体は、単純な引き算とは限らない。報告では、標的付きビーズでの濃縮を、裸のビーズでの濃縮から回帰で予測し、その予測を上回る残差を見る。標的を固定すると、ビーズ表面への付着の仕方も変わりうるためだ。
補正で数字が増えること自体が、直ちに誤りなのではない。気になったのは、補正とは別に、元の標的濃縮にも閾値を置いたと説明されている点だ。
Methodsは、ヒット判定にFDR < 0.05、標的対入力の濃縮、ビーズ補正残差 > 1を使うと記す。表S3の第3ラウンドのミオグロビン行にも、log2 fold change ≥ 1という条件がある。ところが同じ行では、次のように記載される。
表3 同一候補群での未補正濃縮とon-target hitの報告本数。
| New Round-3 myoglobin candidates | Count |
|---|---|
| Raw enriched, log2 fold change ≥1 | 164/549 |
| On-target hit including statistical and bead-correction criteria | 184/549 |
同じ549本に「元の濃縮が1以上」という条件を残したまま条件を足すなら、後者は前者の部分集合になるはずだ。しかし、表では20本多い。αトロンビンの対応する数字は251/311→131/311で、この必要な大小関係を満たす。ただし、数が減っているだけで集計全体を検証できたことにはならない。
一方、Methodsの「元の濃縮は正」という記述と、括弧内の「volcano pre-hitには1以上」という記述を別の段階の規則と読めば、補正後の本数が増えても不思議ではない。回帰補正は、元の値が1未満だった候補も押し上げうる。
例えば、第3ラウンドのミオグロビンで記された背景予測は「−0.454 + 0.430 × ビーズ濃縮」だ。仮に標的のlog2 fold changeが0.8、ビーズの値が0なら、残差は0.8 − (−0.454) = 1.254になる。元の値は1未満でも、残差は1を超える。FDR条件も満たすと仮定すれば、「元の値が正、残差が1超」という規則では採用できる。これは説明用の数値であり、実測された候補ではない。
したがって、164本と184本という大小だけで誤りとは言えない。再現のために確定したいのは、実際に採用した規則がどちらなのかという点だ。元の値に1以上を要求する補足表S3や補足図S1の説明と、Methodsを別段階に読んだ規則との対応が、この資料からは決めきれない。この20本を勝手に落として「修正ヒット率」を作ることもしない。Methods and Supplementary Fig. S1 / PDF 17 , 21 pages
第1ラウンドにも注意点がある。ミオグロビンの代表値は20/196だが、表S3はlog2 fold change ≥ 1を満たすと18本になると併記する。18/196なら9.2%である。Methodsの「全ラウンドで同じ条件」という説明と、各集計の対応には未解決の点がある。このため、10.2%→3.7%→33.5%を完全に統一した規則で得た時系列としては扱わない。
完全な配列・活性表と差次的濃縮表は、査読済み論文の公開時に提供予定と記されている。今回確認した資料では、それらを取得して同じ判定を再現する段階までは進めない。Data availability / PDF 18 pages
実験から学んだこととAIの効果を分ける
この留保があっても、実験設計として参考になる点はある。投入前のライブラリ、裸のビーズ、他の標的を測り、回収量が増えた理由を調べる。弱い指標を速く最大化するより、間違った方向へ進んだときに分かる観測を用意する、という考え方だ。
ただし、AIの推論が通常の最適化より優れていることは、この3ラウンドだけでは分からない。最初のラウンドと後のラウンドでは、エージェントの構成も変わる。候補数や候補群の配分も違う。論文中の実験操作・増幅・シーケンスは人間の研究者が実施したとMethodsにあり、ロボットがこの探索を端から端まで自律実行した実証としては読まない。
著者らも、同じ予算でフィードバックを渡さない群、推論を行わない群、ベイズ最適化などとの比較を今後の課題としている。報告された改善をエージェントの推論だけに帰属させない姿勢は、こちらの記事でも保ちたい。Discussion / PDF 12 pages
結合の強さも別の検証だ。単独候補の濃度系列による確認はαトロンビンの8本で行われ、ミオグロビンの184本をすべて確認したわけではない。既知モチーフ由来の一部ではナノモル域の見かけの解離定数が報告される一方、de novo候補のT05・T06は1マイクロモルで結合が見え始め、T07・T08はその測定上限でも検出されなかった。測定範囲内で飽和に達していないため、報告自体が推定値を予備的と位置づける。ヒット率と親和性、機能、薬剤としての有用性は順番に確かめる必要がある。
対照実験と候補選択の関係
標的だけを測った濃縮と、他のタンパク質やビーズへの結合を差し引いた濃縮では、成功に数える候補が変わる。今回の集計で確かめられたのは、その定義の違いがヒット率の読みに影響することだった。
一方、どの対照の情報がAIの候補設計を改善したかは分離できていない。最終ラウンドの成績には候補群そのものの変更も含まれる。対照を返す前後の候補IDと設計履歴を追っていない以上、ヒット率の変化をAIの学習効果だけへ帰属させることはできない。
データとコードの公開状況
入力表・計算コード・実行手順を用意した。報告の分子・分母から割合と倍率を計算し、閾値別の結果と、部分集合としての本数の必要条件を確認する。analysis.py、python -m unittest test_analysis.py、plot.pyの順で実行できる。元PDF、配列、エージェントのログは再配布していない。
本記事の独自作業は公開集計の検算と整合性確認であり、原研究の生データ解析や実験の再現ではない。
参照
- Rao P, Sirkovic P, Pawlosky A. Grounding AI agents in biological reality: building blocks for autonomous wet labs. Google Research Blog. 2026 Oct 16. Research blog.
- Cutts Z, Coller J, Chen R, Tang H, Bellaiche M, Easterlin R, et al. Aptamers as a sandbox for lab-in-the-loop agentic molecular discovery. Google Research [research report; not peer reviewed]. 2026 Oct 12. Report PDF.