測定していない薬の細胞応答をAIはどう予測するのか
On this page
要旨
未測定薬剤の転写応答を予測するMAPについて、公開スコア600個を再集計し、評価時にモデルへ渡さなかった情報と利用可能な情報を整理した。16薬剤すべてで平均相関は比較法を上回ったが、5回すべてで相関差が正だったのは12薬剤だった。96個の掲載平均との照合では1件に丸めだけでは説明しにくい差が残った。これは固定テスト集合の記述的な再集計であり、未知構造や未知機序への一般化と薬効の改善を検証した結果ではない。
背景と目的
新しい化合物を細胞に加えると、どの遺伝子の発現が変わるか。まだRNAを測っていない化合物にも予測を出せれば、次の実験候補を絞る手掛かりになる。ただし、薬の名前が学習データにないことと、構造や作用まで未知であることは同じではない。
2026年8月のMAPは、薬剤・遺伝子の知識を表現へ取り込み、薬剤投与後の転写応答を予測する研究である。原著 (1)
本稿では、「未知にした情報」と「残した情報」を区別する。この記事では、公開Source Dataの16薬剤・6手法・5回の評価を再集計する。モデルの学習・推論は行っていない。再集計で確認した結果と、未検証の適用範囲を区別する。資料確認日:2026年10月12日。
対象と確認範囲
事前学習と予測時の入力
薬剤を番号だけで表すモデルでは、初めて出てきた番号の意味が分からない。分子構造を入力できれば、学習中の薬剤との共通点を利用する入口ができる。MAPの知識学習は、分子構造、タンパク質配列、説明テキストを結び付け、その表現を細胞応答の予測へ使う。
ここで、事前学習に使う情報と、予測時に与える情報を混同しない。私が確認した公式デモ (2)は、対照細胞の入力、化合物のSMILESという構造表記、濃度を予測器へ渡す。デモを実行したわけではないが、薬剤名を既知の番号として検索するだけの入口とは違うことをコードから確認できる。
未測定の化合物に対して応答を予測できる理由は二つ考えられる。一つは、構造の近い既知化合物の応答へ近づけること。もう一つは、構造だけでは表しにくい作用の関係を、事前学習で表現へ組み込むことだ。両方が働く可能性があるから、知識を加えたモデルが良いという結果だけで、未知の機序を発見したとは結論しない。
評価で除外する情報
MAPの原論文には、薬剤と細胞の組み合わせを未知にする設定と、テスト薬剤の転写応答をすべて学習から除く設定がある。後者では知識学習からも、テスト薬剤、別名、関係する辺を除くと記載されている。以下の集計は後者を扱う。原著の評価設定 (1)
表1 除外情報と評価対象の違い
| Information held out | Information still available | Question addressed |
|---|---|---|
| Drug–cell combination | The same drug's measured responses in other cells | Transfer across cell backgrounds |
| The drug's transcriptional responses | Structure, learned representation and other drugs' responses | Prediction for an unprofiled drug |
| Structural series | Distant structures and known targets/pathways | Prediction less dependent on close analogues |
| Mechanism-of-action group | Structure and drugs with other mechanisms | Prediction beyond known mechanism groups |
表1の下の二行は、本記事が追加で問う検証である。MAPの薬剤除外評価が、そのまま構造系列や作用機序の除外を意味するわけではない。薬剤のIDが違っても、よく似た化合物が学習側にあれば、近い例からの予測が可能だからだ。
それを不正な情報漏洩と一律に呼ぶ必要もない。類縁体を改善する仕事なら、近い化合物の知識は正当に使える。類縁体での成績を新しい構造や新しい機序へ広げるなら、その適用範囲で別に確かめる必要がある。
私は公式コードの知識データ読み込み部分も読んだが、この記事では分割済み知識グラフと使用チェックポイントの組を再現していない。「除外すると論文に書かれていること」と「その実行物で除外を検証したこと」は分けて残す。
再集計の方法と結果
薬剤別の相関差と評価回の変動
比較に使ったのは、Source Data (3)のFig_3cシートである。これはTahoe-100Mの6つのがん細胞株を用いた未測定薬剤の評価で、細胞ごとの測定値をまとめた擬似バルク(pseudobulk)の評価値を扱う。個々の細胞の運命や、すべての細胞型への予測を評価した集計ではない。各薬剤について、MAP、CRISP、ChemCPA、PRnet、trainMean、XPertの上位50差次的発現遺伝子に対するPearson delta correlationが載っている。差次的発現とは、薬剤投与と対照の間で発現が変わることである。Pearson delta correlationは、対照からの遺伝子別発現変化について、予測と実測のパターンがどれほど一致するかを測る相関だ。ここでのdeltaは発現の変化を指し、以下で計算する手法間の相関差とは区別する。
全16薬剤を読み、各薬剤で掲載平均が最も高い比較法を一つ選んだ。その比較法を固定し、5回それぞれでMAPとの差を取った。比較法は評価結果を見て選んでいるので、これは未知候補に適用できるモデル選択法ではなく、掲載結果の記述的な比較である。
\[ d_{j,e}=r_{\mathrm{MAP},j,e}-r_{\mathrm{comparison},j,e}. \]
ここで\(j\)は薬剤、\(e\)は評価回を表す。図の点は、公開された5つの丸め値から計算した\(d\)の平均である。
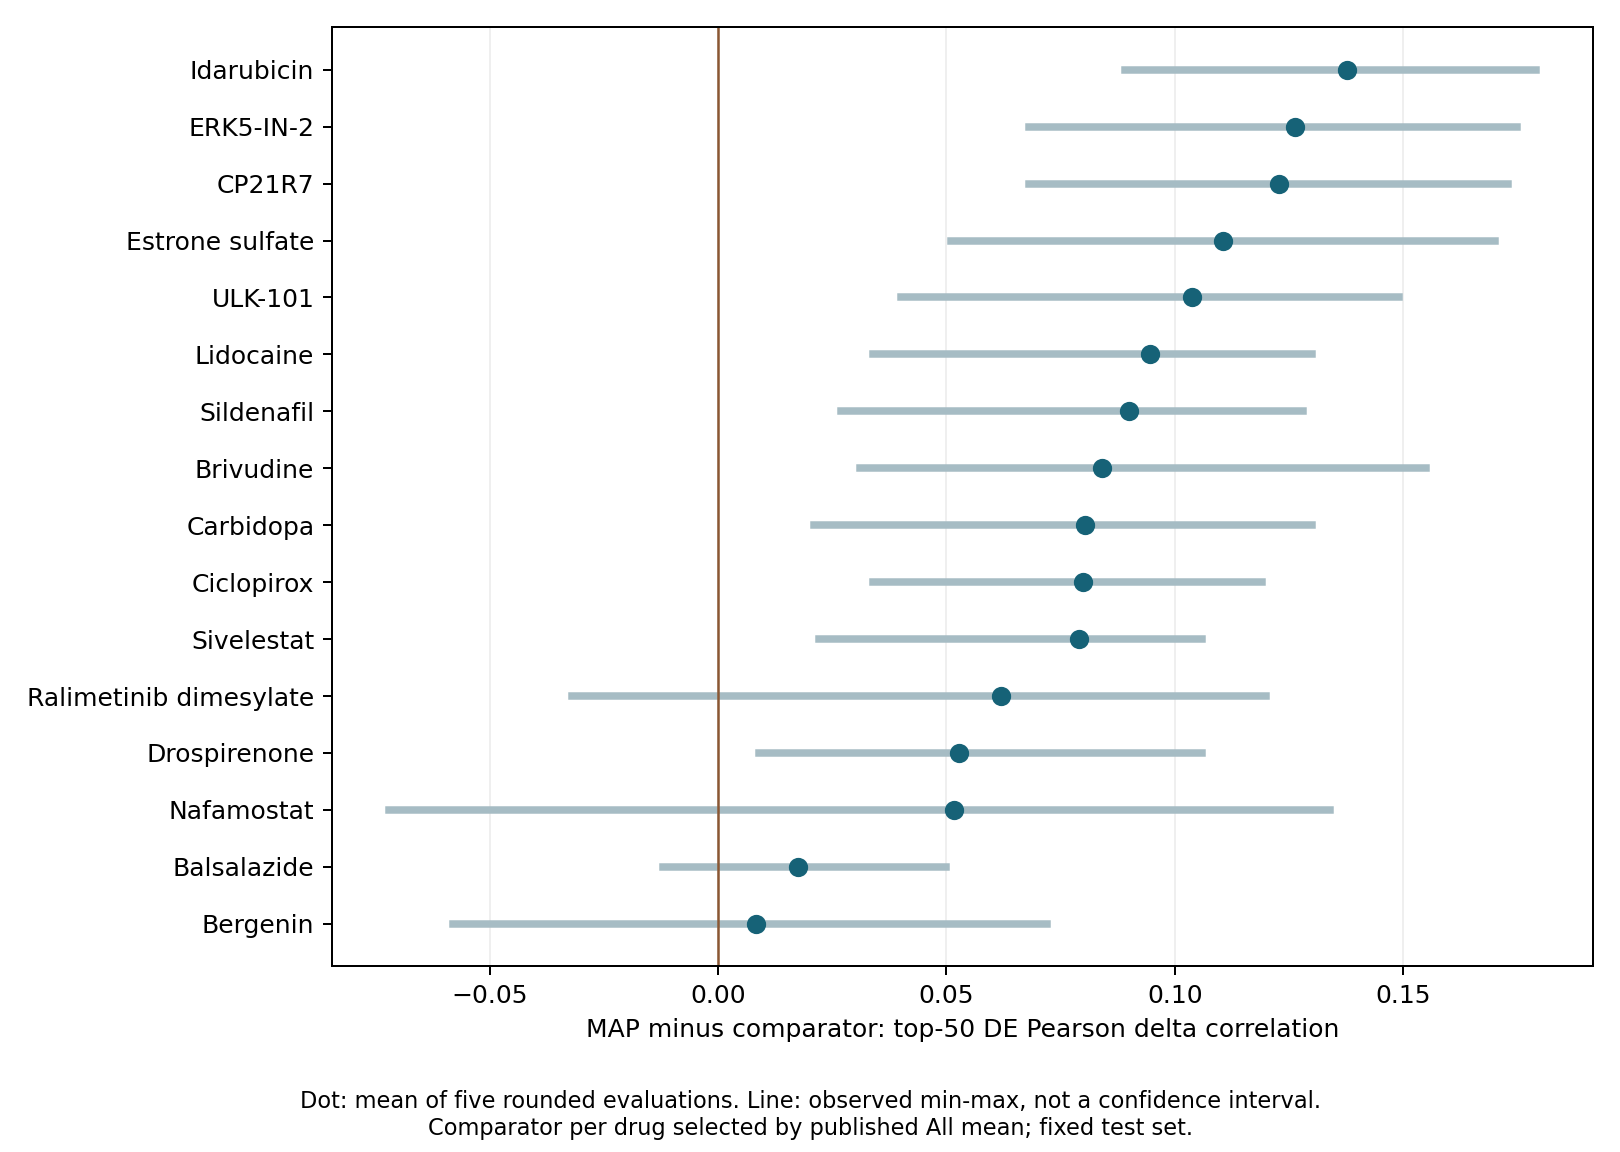
図1。 全16薬剤を表示した本記事の再集計。線は5回の差の最小値から最大値までで、信頼区間ではない。比較法は薬剤ごとに異なるが、同じ薬剤の5回では固定している。薬剤別の比較法は配布物のresults/drug-comparisons.csvに記録した。
図1と表2では、掲載平均で16薬剤すべてにおいてMAPが比較法を上回った。5回の丸め値から平均を再計算しても、この結論は変わらなかった。一方、5回すべてで差が正だったのは12薬剤である。
表2 評価回によって相関差の符号が変わった薬剤
| Drug | Comparator | Mean correlation difference | Minimum–maximum | Evaluations with positive difference |
|---|---|---|---|---|
| Bergenin | XPert | 0.0084 | −0.058–0.072 | 3/5 |
| Balsalazide | CRISP | 0.0176 | −0.012–0.050 | 3/5 |
| Nafamostat | XPert | 0.0516 | −0.072–0.134 | 4/5 |
| Ralimetinib dimesylate | XPert | 0.0620 | −0.032–0.120 | 4/5 |
これは、平均の優位を否定する結果ではない。候補ごとに改善の幅が違い、小さい差は評価回によって符号も変わる、という結果である。私は、一つの全体平均から全化合物に同じ改善を期待することを避けたい。
5回は、同じ固定テスト集合に対する評価である。差は表にある同じ評価番号で照合したが、各回で何をランダム化したか、手法間で同じ乱数や抽出細胞を使ったかは、このスコア表だけでは検証できない。5人の患者や5つの独立した実験系を追加したわけではない。この範囲から、未知薬剤全体に対する成功率や、生物学的な不確実性を推定しない。また、ここでの差は相関係数の差であり、薬効が何%改善したという数字ではない。
掲載平均との照合
96個の掲載平均(16薬剤×6手法)を、対応する5回の値の平均と照合した。DrospirenoneのMAPには、掲載値0.941に対し、5回からの再計算値0.9346という差があった。差は0.0064で、両方の値を小数第3位で丸めたことだけでは説明しにくい。
元の掲載値を誤りと断定して置き換えることはしない。別の集計手順が使われたのか、表記の問題なのかは、公開されたスコアだけでは確定できない。配布CSVには両方を残した。この薬剤でも比較法との差は、掲載平均で0.059、5回からの再計算で0.0528と、いずれも正である。
候補を選ぶ際に微小なスコア差を使うなら、まず入力・集計の整合性を確かめたい。今回の差は全16薬剤の平均優位という判断を変えなかったが、数値の桁を増やすだけで比較の確かさが増すわけではない。
知識学習を変えた条件の比較
もう一つ、原著Figure 5aのSource Dataシート (3)の未測定薬剤に対する相関を読んだ。PrimeKGは既存の生物医学知識グラフ、MAP-KGは本研究で薬剤・遺伝子とその関係を統合した知識グラフである。掲載平均は、ランダム初期化の条件0.321、MoleculeSTMを加えた条件0.734、PrimeKGまで0.747、MAP-KGまで0.822である。
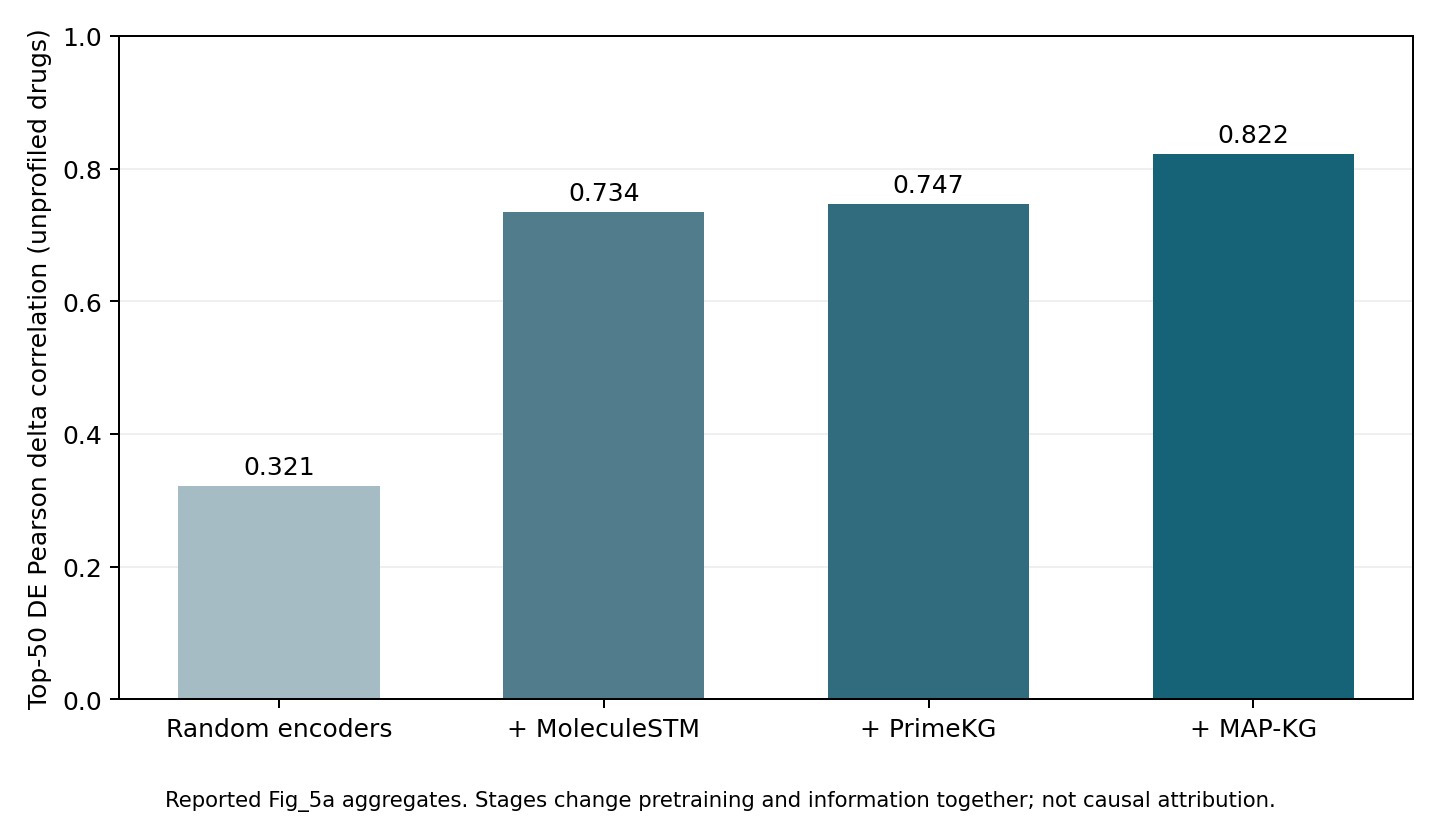
図2。 公開表の4条件を本記事で図にした。段階ごとの相関差は0.413、0.013、0.075。単位は相関係数であり、知識の因果的な寄与率ではない。
大きい最初の差には、分子とテキストの事前学習を導入する変化が含まれる。その後の差にも、学習内容や量の変化が含まれる。したがって、0.413を分子構造だけの効果、0.075を標的機序だけの効果、と、要因ごとの効果に分けることはできない。
私は、この図を「情報と事前学習の条件を変えると、未測定薬剤への予測が変わった」証拠として読む。どの関係がどの薬剤を改善したかは、情報をそろえた対照や薬剤別の評価がなければ切り分けられない。知識を入れたモデルの予測が機序に沿っていることと、予測から機序を新たに識別したことも区別する。
考察
正解の変化をすべて2倍した予測でも、変化が一定でなければPearson相関は1になる。相関が高くても、薬剤による発現変化の大きさを正しく予測できたとは限らない。
また、実測応答から選ぶ上位50遺伝子は、発現が変わった遺伝子を予測で捉えられたかの評価には使えるが、未測定薬剤を予測する時点には分からない。原著の遺伝子選択手順 (1)
今回のSource Dataはスコア表であり、共通遺伝子集合での誤差や薬剤間識別を再計算したものではない。構造距離別の性能も確かめていない。16薬剤の平均での優位は確認できたが、どの距離の候補まで同じ成績が保たれるかは、この表だけでは決まらない。
結論
今回の公開表では16薬剤の平均優位を確認できたが、各評価回の差や集計の整合性には個別の確認が必要だった。薬剤除外は構造系列や作用機序の除外を意味せず、知識を加えた予測の改善だけから機序の発見や薬効の改善を結論できない。
データとコードの公開状況
入力CSV・再計算コード・図・結果を配布する。python analysis.pyは標準ライブラリだけで動く。図の再作成にはmatplotlibを使う。入力は公開スコア600個で、元のシート・セル位置を残している。
今回行ったのはスコアの記述的な再集計と公式コードの静的な読解である。モデル実行、元の細胞データからの評価再現、独立テスト薬剤の追加、臨床効果の推定は行っていない。
資料はMAP原著 (1)、補足資料 (4)、公式コード (2)である。公開コードの確認版は629ebdc。配布物には元の論文・図・Source Dataブック・公式コード・モデル重みを含めていない。
参照
- Feng J, Zhao Z, Zhang X, Liu M, Chen J, Quan X, et al. A knowledge-driven framework for predicting single-cell responses for unprofiled drugs. Nature Machine Intelligence. 2026;8(9):1478–1491. doi:10.1038/s42256-026-01286-w.
- MAP developers. MAP: official implementation [Software; cited 2026 Oct 12]. Commit 629ebdc1617eaf89825185a1512d772eccc3dc7e. Fixed repository.
- Feng J, Zhao Z, Zhang X, Liu M, Chen J, Quan X, et al. Source Data for: A knowledge-driven framework for predicting single-cell responses for unprofiled drugs [Dataset]. 2026. Sheets Fig_3c and Fig_5a. Workbook.
- Feng J, Zhao Z, Zhang X, Liu M, Chen J, Quan X, et al. Supplementary Information for: A knowledge-driven framework for predicting single-cell responses for unprofiled drugs. 2026. Supplement.