ラベルが読める潜在空間で応答も予測できるか
PerturbEnergyのプレプリントを読み、摂動ラベルの識別と発現応答の予測を分ける。公開表の再計算と解析的な反例から、性能改善の数字と未知条件への一般化を検討する。
On this page
薬剤を加えた細胞のデータを、AIが小さな潜在空間へ押し込む。その空間から薬剤名をよく言い当てられたら、薬剤応答をうまく表現できたと言いたくなる。
私はここで、いったん出力まで戻って確認したくなる。名前を区別する情報と、どの遺伝子がどれだけ変わるかを決める情報は、どこまで重なっているのだろう。
2026年10月13日公開のプレプリント、PerturbEnergyは、摂動に対応する潜在表現を明示的に作ろうとする手法だ。本稿ではv1を読む。査読済み論文としては扱わない (1)。
エネルギーは細胞の熱力学ではない
PerturbEnergyは、基底状態の表現と摂動に関係する表現を分け、後者の事前分布を条件付きエネルギー関数で変える。与えた摂動と相性のよい潜在表現へ、確率を寄せる仕組みである。(Original paper Eq. 4)
ここでいうエネルギーは、神経ネットワークが出すスコアだ。細胞の自由エネルギーを測った値でも、薬剤と標的の結合自由エネルギーでもない。「低いから生物学的に安定」という解釈はしない。
この仕組みには、なるほどと思うところがある。細胞種や培養条件の違いが大きければ、摂動の効果は潜在空間の中で目立たなくなる。デコーダーを大きくするだけでなく、使ってほしい情報が表現に残るようにする。モデルの容量を増やす方向とは別の工夫だ。
ただし、ここで入力を確かめておきたい。公開実装の PertEncoder は基底状態に摂動の埋め込みを加えて表現を作る。したがって、その表現から摂動ラベルを読み戻せたことだけでは、観測された生物応答を再現した証拠としては足りない。摂動ラベルを入力すること自体は、条件付き応答予測では当然の設計である。問題は、何を評価した数字か、ということだ。(2; 確認版のエンコーダー)
同じ識別率で応答誤差は逆に動かせる
少し手を動かしてみる。以下は私が作った一次元の解析例で、PerturbEnergyの学習済みモデルや生物データを再現するものではない。条件付きエネルギーで分布を動かす、という部分だけを取り出す。
摂動ラベルを \(a\in\{-1,+1\}\) とし、それぞれ半々に現れるとする。潜在変数の基準分布を標準正規分布に置き、エネルギーを
\[ E(z,a)=\frac{\lambda}{2}(z-a)^2,\qquad \lambda\geq0 \]
とする。\(\lambda\) は、表現をラベル側へ寄せる強さだ。これで
\[ p(z\mid a)\propto\exp(-z^2/2)\exp\{-E(z,a)\} \]
を作ると、平方完成から
\[ z\mid a\sim N\left(\frac{\lambda}{1+\lambda}a,\frac{1}{1+\lambda}\right) \]
が得られる。\(z\) の符号でラベルを判定したときの正解率は、標準正規分布の累積分布関数を \(\Phi\) として
\[ P(\widehat a=a)=\Phi\left(\frac{\lambda}{\sqrt{1+\lambda}}\right) \]
となる。強く寄せるほど見分けやすくなる。
次に、予測したい応答を \(y=a\) と置く。潜在変数の条件付き平均を \(m_a=\lambda a/(1+\lambda)\) とし、平均応答の予測を \(\widehat y=g\,m_a\) とする。デコーダーの向き \(g\) は、正しい向きの \(+1\)、潜在変数を無視する \(0\)、逆向きの \(-1\) の3通りで固定する。
どれも潜在分布は同じだ。だからラベル識別率も同じになる。しかし、平均応答のRMSEは
\[ \mathrm{RMSE}=\left|1-g\frac{\lambda}{1+\lambda}\right| \]
と、デコーダー次第で変わる。ここでは条件ごとの平均を比べており、個々の潜在サンプルのばらつきをRMSEへ足してはいない。
表1. 同一の潜在分布に異なるデコーダーを置いた一次元例。
| Attraction strength \(\lambda\) | Label accuracy | Correct-direction RMSE | Ignoring latent variable | Reversed-direction RMSE |
|---|---|---|---|---|
| 0 | 50.0% | 1.00 | 1.00 | 1.00 |
| 1 | 76.0% | 0.50 | 1.00 | 1.50 |
| 4 | 96.3% | 0.20 | 1.00 | 1.80 |
| 16 | Approximately 100.0% | 0.06 | 1.00 | 1.94 |
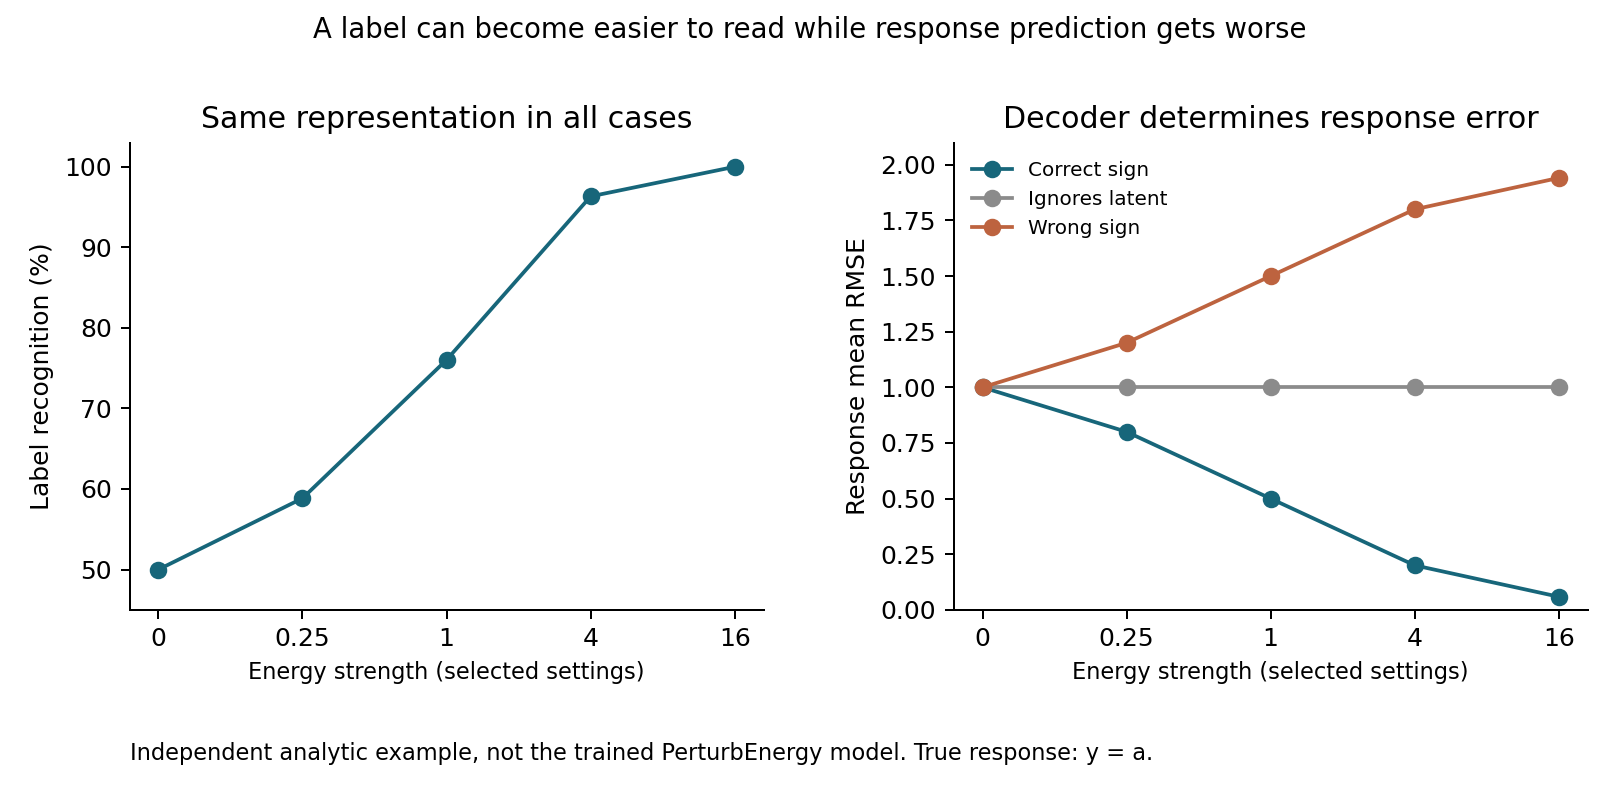
図1. ラベル識別率と平均応答RMSEの関係。潜在表現の識別率が同じでも、デコーダーにより応答誤差は異なる。独自の一次元例であり原著モデルの再現ではない。
もちろん、わざと逆向きのデコーダーを置いている。実際に応答を学習すれば修正されるかもしれない。この例の役割は、ラベル識別率の改善だけから、応答予測の改善が論理的に決まるわけではないと示すことだ。PerturbEnergyが逆向きに予測している、という主張ではない。
ラベルの保持が良くても、ラベルと実際の応答を結ぶ部分の性能は別に残る。
83.2%は何の改善か
Original paper Table 3のReplogleでは、潜在表現からの摂動ラベル識別率がPerturbedVAEの28.6%に対し、PerturbEnergy-Misでは52.4%だった。これを相対変化で計算すると
\[ 100\times\frac{52.4-28.6}{28.6}=83.2\% \]
となる。差そのものは23.8パーセントポイントである。(Original paper Table 3)
83.2%という数字を、遺伝子発現の予測誤差の減少率や、新薬候補の成功率として読むことはできない。
では応答の方はどうか。原著は、識別率だけでなく発現予測も評価している。評価には薬剤、遺伝子操作、サイトカイン刺激のデータが含まれる。Table 2の真の上位50 DEGに対するRMSEを使い、各データセットで既存手法の最小値と比較し直した。全12手法の数値を入力ファイルに収録し、比較対象をコードで選んでいる。LangはLangevin動力学による負例サンプリング、Misは別の摂動を使う負例構成の変種を指す。
表2. 原著の真の上位50 DEGに対するRMSEの再集計。
| Dataset | Lowest existing-method RMSE | PerturbEnergy-Lang | PerturbEnergy-Mis |
|---|---|---|---|
| Replogle | 0.2024 (STATE) | 0.1870 | 0.1780 |
| PBMC | 0.0729 (stVAE) | 0.0637 | 0.0654 |
| Tahoe100M | 0.3293 (stVAE) | 0.3114 | 0.3123 |
| Norman2019 | 0.1248 (PerturbDiff) | 0.1434 | 0.1376 |
この表の範囲では、既存手法の最小値に対し、ReplogleのMisは12.1%、PBMCのLangは12.6%、Tahoe100MのLangは5.4%、RMSEが小さい。一方、Norman2019のMisは10.3%大きい。データセットごとのよい方を示しているので、単一の変種がすべてで最適だと読むものでもない。Original Table 2
元表の平均値を再計算した結果であり、私がモデルを学習し直した結果ではない。元表にはグループ間の標準誤差もあるが、条件ごとの対応した誤差を持たないので、ここから手法間の有意差検定や差の信頼区間は作っていない。
また「真の上位50 DEG」は、実測側から選んだ遺伝子集合である。その集合上のRMSEは、応答する遺伝子を見つける性能とは別だ。発見する遺伝子を取り違えても、指定された集合上ではよく当たるモデルは考えられる。候補探索で使うなら、遺伝子集合の発見と、そこでの変化量の予測を両方見る必要がある。
未知の何に対する予測か
もう一つ、創薬で使う場面を考えるときに外せないのがデータの分割だ。
原著Appendix A.3.1では、Replogle、PBMC、Tahoe100Mについて、評価用の細胞系・ドナーから摂動の30%を学習側へ戻す。摂動ラベルは学習のどこかで観測され、残る条件への適応を調べる設計である。Norman2019は、個々の遺伝子を既知とし、組合せを未観測にする設定だ。Split conditions
したがって、この比較をそのまま「まだ測っていない新規化合物の応答を当てた」と言い換えない方がよい。既知薬剤を別の細胞背景へ持っていく場面と、新しい化合物へ外挿する場面では、予測時に渡せる情報が違う。
たとえば学習済みラベルの表を使うなら、未知化合物のラベルにどんな表現を与えるかという問題が残る。化学構造を入れるのか、標的情報を入れるのか、少数の実測応答で補うのか。それぞれ必要なデータも、評価の切り方も変わる。
ここでの結果は、既知の摂動を新しい条件へ移す設定でのものであり、未知化合物、未知濃度、未知時点への予測を同時に検証したものではない。
ラベルの分離と薬剤応答の区別は一致しない
同じ作用機序の薬剤が近い応答を示す場合、ラベルが異なるからといって生物学的に遠いとは限らない。逆に、同じ薬剤でも濃度や採取時刻が違えば応答は異なる。ラベルを読み取りやすい潜在表現が、そのまま必要な生物学的な区別を保持する保証はない。
今回の評価は、既知の摂動を別の条件へ移す設定を含む。発現RMSEの改善から、未知候補を選んだときの追試成績、細胞の生存、望ましくない応答まで改善したとは言えない。潜在空間の分離と、実際の候補選択の有用性の間には、この差が残る。
データとコードの公開状況
計算コードと入力数値には、Original paper Table 2から抽出した上位50 DEGのRMSEと標準誤差、比較の再計算、一次元例の解析式・描画・検証テストをまとめた。原著の本文、図、学習済みモデルや細胞データは含めていない。
一次元例は数値積分で平均・分散を照合し、乱数による識別率とも比較した。実際のPerturbEnergyの再現実験とは分けている。実行条件と限界は同梱のREPRODUCE.mdを参照。
公開実装の確認版は 0d0e32e80f0aecb43a439b5ad92bb8e167f73865。
参照
1. Yan Y, Bian Y. Learning perturbation-specific representations through conditional energy prior for cellular response prediction. arXiv. 2026 October 13. Version 1. arXiv:2610.18456v1. Preprint.
2. BlueWhaleLab. PerturbEnergy. GitHub repository. Commit 0d0e32e80f0aecb43a439b5ad92bb8e167f73865. Source code.