PIEの平均AUPRCから追試する遺伝子を選べるか
公開評価10,335行をDEGラベルと照合し、背景別の陽性率とAUPRCを再集計する。平均性能、同じ摂動の背景差、限られた追試件数での精度を区別し、候補選びに必要な追加評価を示す。
On this page
背景と目的
摂動後に変わる遺伝子を予測できれば、追試する候補を絞れる。しかし、「差次的発現遺伝子の予測でAUPRCが高い」という結果から、上位50遺伝子のうち何件が当たるかは直接分からない。未知の細胞背景で使うなら、変わる遺伝子の数も背景ごとに違う。
PIE(Perturbation is Everything)は、生物学的な知識と実測の摂動データを使い、細胞集団の発現変化を予測するモデルだ。2026年10月5日公開の(1)に対応する公開評価表を、固定版のDEGラベルと照合した。10,335評価行の再集計から、平均性能、DEGの少なさ、限られた候補数での評価を分けて読む。
一つの細胞を再現するより集団の変化を予測する
PIEの出力には、遺伝子ごとのDEG確率、log2 fold change、平均発現の変化がある。個々の細胞の未来を対応付けるのではなく、細胞背景と摂動の組に対して集団レベルの読出しを予測する。(2)
入力は摂動名だけではない。遺伝子の説明、タンパク質の配列・ネットワーク、依存性プロファイル、細胞株の記述に加え、controlの発現と学習集合内の摂動応答を使う。知識を使うこと自体を漏洩とは呼べないが、未知の背景を予測するときにも何を観測済みとして渡すかが重要になる。ここでの「未知」は、対象背景の摂動応答を学習に入れないという意味で、controlも知識も一切ない状態ではない。(3)、(4)
今回はReplogle-Nadigの必須遺伝子CRISPRiデータを対象にした。薬剤による細胞応答や患者組織への転用を、この集計から実証したとは扱わない。
何が未知かを三つに分ける
公開モデルには、HepG2、Jurkat、K562、RPE1を一つずつ除外して学習した四つのfoldがある。フォルダ名は除外した細胞株を表す。K562 foldは、K562で学習したモデルではなく、残り三つで学習・検証したモデルだ。
表1.未知条件別の4 fold平均AUPRC。
| Setting | Context | Perturbation | Four-fold mean AUPRC |
|---|---|---|---|
| unseen_ctx | Held-out cell line | Present in training | 0.4155 |
| unseen_pert | Three cell lines present in training | Held-out perturbation | 0.3048 |
| unseen_ctx_pert | Held-out cell line | Held-out perturbation | 0.2366 |
表は公開スコアを再集計した結果であり、モデルを再実行した性能ではない。摂動ごとの値を背景内で平均し、複数背景がある設定では背景を均等に平均してから、四つのfoldを均等に平均した。全評価行を一括で平均する場合とは重みが違う。
12の評価分割とCSVの細胞株・摂動名の集合が一致することも照合した。評価行は10,335件だが、元の生物学的な背景・摂動ペアは5,459件で、複数foldに繰り返し登場する。四つのモデルの学習集合も重なる。行数を独立した実験数として信頼区間を作っていない。
DEGが少ない背景ではAUPRCの目盛りも変わる
ここで「真のLFC」と呼ぶのは、公開参照データの実測由来log2 fold changeであり、誤差のない生物学的真値ではない。陽性ラベルには、公開された補正p値が0.05未満で、検定対象かつ真のLFCがNaNでない遺伝子を使った。固定版の加工済みデータ (5) の5,459×6,642配列を照合すると、全行で6,642遺伝子が検定対象で、その中に真のLFCのNaNはなかった。これは公開された加工済みDEGの定義を追跡したもので、生カウントから検定を再実行した結果ではない。
各ペアのDEG陽性率を
\[ \pi=\frac{\text{DEG数}}{\text{検定対象遺伝子数}} \]
と置く。同じAUPRCでも、DEGが1%の条件と20%の条件では解釈が変わる。PIEの実装でbinary_auprcと呼ぶ値はaverage precision(AP)だ。順位全体の精度と再現率をまとめる指標であり、予測確率の校正や特定の追試件数での精度とは別である。
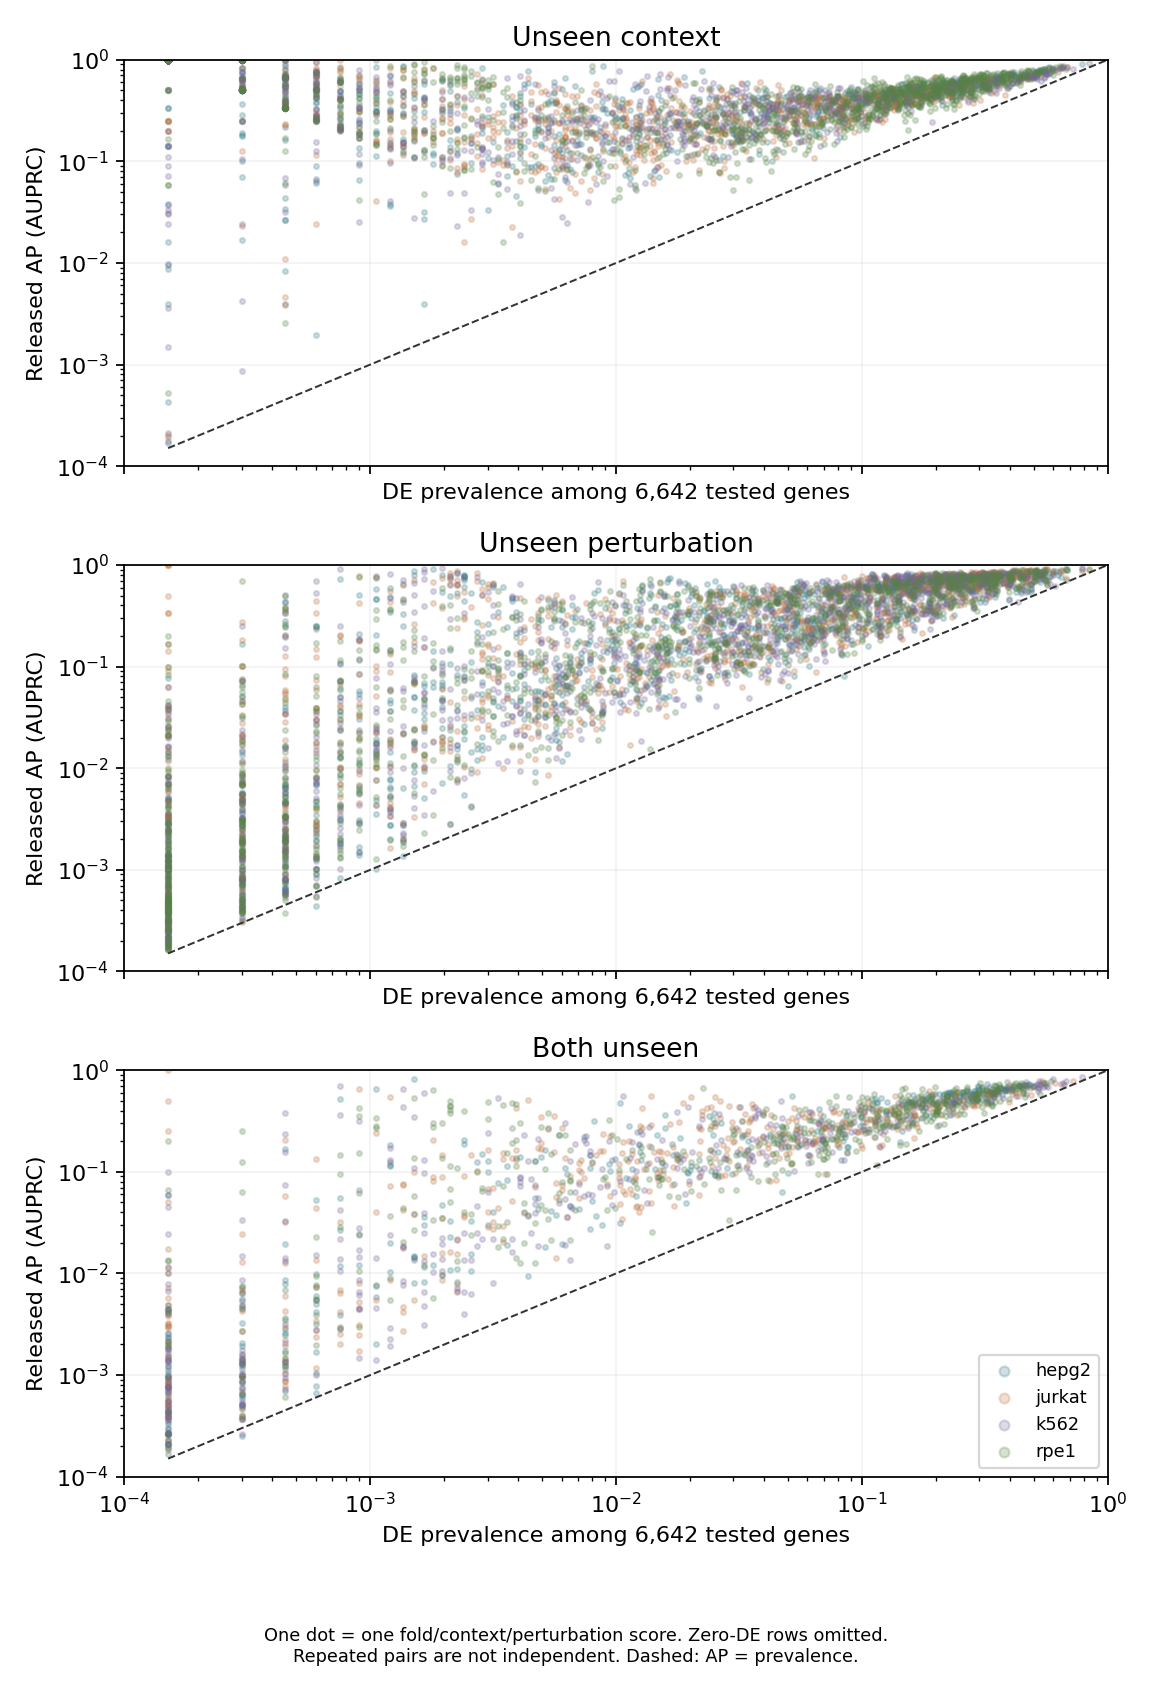
図1. 各点は一つのfold・細胞背景・摂動の評価。色は除外した背景のfoldを表すため、中央の図では測定された背景そのものの色ではない。両軸は対数目盛り。破線はAPと陽性率が等しい線で、独立なランダム順位の検定や有限標本の期待APを計算した線ではない。DEGゼロの評価行は図から除いた。
両方未知の設定を背景ごとに見ると、陽性率の違いが大きい。
表2.両方未知の条件におけるDEG陽性率とAP。
| Held-out context | Evaluated pairs | Zero-DEG pairs | Median DEG count | Median prevalence | Mean AP | Median AP/prevalence among nonzero-DEG rows |
|---|---|---|---|---|---|---|
| HepG2 | 386 | 15 | 96.5 | 1.45% | 0.2444 | 3.47 |
| Jurkat | 461 | 3 | 117 | 1.76% | 0.2140 | 5.01 |
| K562 | 430 | 5 | 63 | 0.95% | 0.1984 | 4.54 |
| RPE1 | 470 | 5 | 430.5 | 6.48% | 0.2897 | 3.33 |
RPE1の平均APはK562より高いが、DEG陽性率も高い。AP/陽性率をペアごとに計算した中央値は、逆にK562の方が高い。これはRPE1よりK562の方が優れたモデルだと順位付けするための新しい総合得点ではない。陽性率を添えずに平均APだけを比較すると、候補を選ぶ難しさの違いを見落とす。
AP/陽性率は記述的な比であり、追試成功率の倍率や統計的有意差ではない。DEGが1件のような条件では分母が小さく、順位が少し動くだけで比も大きく変わる。配布表にはDEG数を0、1–20、21–100、101–500、500超に分けた集計も収録した。
DEGゼロの評価行は、未知背景で48/3,712、未知摂動で74/4,876、両方未知で28/1,747だった。公開実装はこれらのAPを0として平均に含める。陽性がない行でAPが0だからといって、モデルが誤って陽性を出したとは限らない。陰性だけの条件で候補を止められるかは、偽陽性数や予測確率を別に確認する必要がある。
同じ未知摂動でも背景を変えると一様には落ちない
未知摂動の設定と両方未知の設定に共通する摂動を対応させた。各foldで、学習にある背景のAPを摂動ごとに平均し、除外した背景のAPとの差を取った。測定のない組があるため、対応できる摂動だけを使い、既知背景の個数も配布表に残した。
表3.同じ未知摂動を対応させた背景間のAP差。
| Fold | Matched perturbations | Median AP difference: excluded context minus known-context mean | Cases with lower AP in excluded context |
|---|---|---|---|
| HepG2 | 347 | −0.1229 | 303 |
| Jurkat | 416 | −0.0542 | 299 |
| K562 | 371 | −0.0805 | 294 |
| RPE1 | 411 | +0.0317 | 155 |
三つのfoldでは差の中央値が負だったが、RPE1では正だった。異なる背景では、真のDEG数や応答自体が変わる。同じ摂動名に揃えても、未学習背景による予測劣化と生物学的な背景差を因果的に分離できたわけではない。「背景を未知にすると必ず同じ割合だけ悪くなる」という読み方を避けるための対応表だ。
平均APから上位50件の当たりを計算できるか
次に追試する遺伝子を50件しか選べないなら、必要なのはprecision@50、recall@50、候補にしなかった条件の扱いだ。これらの陽性は固定したDEGラベルとの一致を指し、独立した追試が成功する確率とは別である。APは順位全体をまとめるので、APが同じでも上位だけの結果は違い得る。
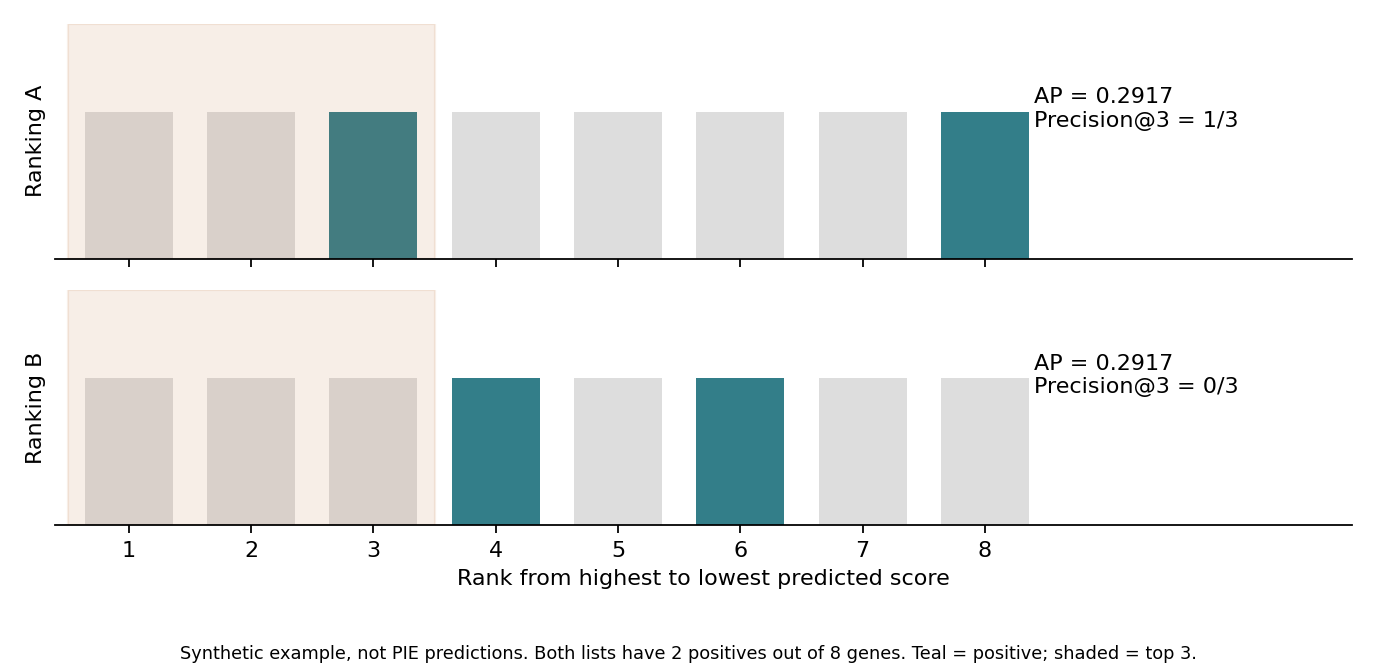
図2. PIEの予測ではなく、8遺伝子・陽性2件の人工例。Aは3位と8位、Bは4位と6位が陽性。スコアに同順位がない場合、両者のAPは7/24、約0.2917で同じだが、上位3件の適合率は1/3と0/3になる。全体の陽性率も両者で同じだ。
公開モデルの固定版ファイル一覧には、摂動別と背景別の評価CSVはあるが、遺伝子ごとの予測スコアを保存したparquetはなかった。実装には予測を保存する機能があるものの、今回はチェックポイントによる推論を行っていない。したがって、PIEのprecision@50や知識源別の上位候補を独立に再評価したとは言えない。 公開CSVのJaccardをprecision@50へ変換することもできない。
参考として、検定対象から無作為・非復元で50遺伝子を選ぶ場合の期待陽性数は
\[ E[\text{陽性数}]=50\pi \]
となる。両方未知のK562では陽性率の中央値に対応する期待数が約0.47件、RPE1では約3.24件だ。これは無作為選択の計算で、PIEで50件選んだときの実績や保証ではない。順位モデルの候補選択を評価するには、その順位と予算を実際に対応させる必要がある。
考察
PIEの入力には、摂動側の知識、予測遺伝子の説明、背景の記述、観測された応答の情報が含まれる。公開データカードには由来、モデル版、ハッシュが記録されている。(4)
知識が豊富な摂動ほどAPが高くても、その相関だけでは知識の追加が精度を上げたとは結論できない。学習から知識源を除くことと、学習済みモデルの推論時に入力を除くことも、異なる介入になる。今回の公開表の再集計は、いずれのアブレーションも再現していない。
陽性率やDEGゼロの割合、背景ごとの落差が、平均APの解釈を左右した。個々の候補順位を追試予算へ結び付ける評価とは区別している。また、DEGの予測が当たることだけでは、病態の改善や毒性の回避は示されない。
データとコードの公開
集計コード・監査用入力・図をダウンロード。監査用入力は公開スコアと独自に抽出したDEG数を対応させた表である。Python標準ライブラリで集計と9件のテストを実行できる。元データとの照合には取得スクリプト、numpy、約473 MBの公開ラベル等が必要で、図の再描画にはmatplotlibが必要だ。
モデル、データ、分割、実装の版と取得ファイルのSHA-256をinput-provenance.jsonに収録した。チェックポイント・埋め込み・元の評価CSV・ラベル配列・第三者コードは同梱していない。PIEのコードとモデルにはそれぞれ利用条件があるため、コードのライセンス (6) とモデルの利用条件 (7) は別々に定められている。
本集計は公開資料を見た後の探索的な監査である。原著は査読前のプレプリントである。本記事の数値とラベル定義の一次資料は、固定版の公開モデルカード・評価CSV・評価実装・加工済みデータであり、論文PDF本文の取得はできなかった。生カウントのDE解析、モデル学習・推論、個々の予測確率の校正、上位遺伝子の適合率、知識源アブレーション、患者への一般化は検証していない。
参照
- Verma R, Adduri A, Bevilacqua B, Eraslan B, Burke DP, Goodarzi H, et al. PIE: Generalizing perturbation effects across unseen perturbations, contexts and datasets. bioRxiv [Preprint]. Version 1. 2026 Oct 5. doi:10.64898/2026.10.02.756297.
- Arc Institute. PIE: within-dataset generalization on Replogle [Model card and evaluation data]. Revision 055c7a2cabdaff5659121c64fa2b609c231fc5be. Hugging Face. Accessed 2026 Oct 14.
- Arc Institute. PIE [Software]. Commit 21a526add9ff3a81b4f962d9b16bbae570052c63. GitHub. Accessed 2026 Oct 14.
- Arc Institute. PIE: knowledge sources [Dataset card]. Hugging Face. Accessed 2026 Oct 14; retrieved-file hashes recorded in the audit distribution.
- Arc Institute. PIE: Replogle-Nadig essential Perturb-seq [Processed dataset]. Revision 20c9faef76fc96fdc809871340bd93499413dfe7. Hugging Face. Accessed 2026 Oct 14.
- Arc Institute. PIE code license. Commit 21a526add9ff3a81b4f962d9b16bbae570052c63. License.
- Arc Institute. PIE model license. Revision 055c7a2cabdaff5659121c64fa2b609c231fc5be. Model terms.