RNAの量は合った。その配置まで予測できるか
SubcellPertの空間摂動ベンチマークを読み、公開RNA座標で量・重心・共分散を合わせた人工配置を検証する。同じ二次モーメントにも異なる形が対応し、座標の予測精度から機能は決まらない。
On this page
RNAを何分子持っているかが同じでも、それが細胞の中のどこにあるかは違い得る。発現量の表だけを見ていると、この違いは消えてしまう。
仮想摂動のモデルが量の予測から配置の予測へ進むなら、何をもって「当たった」とするのかも変わる。重心まで合えばよいだろうか。広がりも合わせれば十分だろうか。
2026年10月17日公開のSubcellPertは、RNAの細胞内配置を評価するベンチマークだ。本稿ではプレプリントv1と公開コードを読み、公開されたアストロサイトのRNA座標を使って、RNA分子数・重心・共分散を合わせたときに何がまだ残るかを調べた (1, 2)。
発現量の表では見えない細胞内配置
SubcellPertの予測対象は、遺伝子名の付いたRNA分子の二次元座標である。14の画像データセットを集め、細胞背景や介入条件を変えた際の応答を評価する。単に組織中の細胞の並びを予測する話ではなく、一つの細胞の内側へ測定単位が進んでいる。
ただし、画像がそのまま入力されるわけではない。RNA座標は、各細胞の全RNAの重心を原点に移し、RMS半径で割って規格化される。したがって、この座標で見ているのは相対的な配置だ。細胞の絶対的な大きさ、核膜からの距離、三次元の高さまで再現したとはいえない。(Original paper Section 3 / Appendix A.2)
原点から遠いRNAを、そのまま「細胞質にある」と呼ぶのも避けたい。原点は核の中心ではなく、全RNAの重心である。核内・核外を論じるなら、核や細胞の境界を別に測った情報が要る。
この区別は、薬剤応答を読むときにも効いてくる。特定RNAの核内割合が増えたとして、分子の移動が増えたのか、核の投影面積が変わったのか、別の細胞集団が増えたのかで話は違う。座標が増えれば、機序の答えが自動で付いてくるわけではない。
正解のRNA数を渡す試験と渡さない試験
原著は、RNA数を与える条件と与えない条件を分けている。
表1. 正解RNA数を使う条件と使わない条件の違い。
| Setting | True RNA count available at prediction? | Question |
|---|---|---|
| Oracle | Yes | How accurately can arrangement be predicted with counts fixed? |
| Joint | No | How accurately can post-intervention counts and arrangement be predicted together? |
Oracleでは数が合っていることが出発点で、量の予測精度を示す試験ではない。また二つは独立に学習されるため、OracleのスコアをJointの厳密な性能上限とみなすこともできない。
原著では、単純な再標本化、古典的な輸送法、凍結した基盤モデルに予測ヘッドを付ける方法を比べている。ガウス分布に基づく輸送が学習に含めなかった細胞背景を評価した11データセットのうち8つで最小のOracle空間誤差を得た。ただし、これは比較した設定での結果であり、大きなモデルがあらゆる空間課題で不要だと示したものではない。(Original paper Fig. 4 / Section 4.2)
ガウス分布に基づく輸送がよかったことから、平均と分散だけを再現すれば配置の問題は片づく、と考えてよいか。ここは実測座標で確かめてみたかった。
数と重心と共分散をそろえた人工配置
以下は、原著モデルの再学習でも、Oracleベンチマークの追試でもない。正解座標の要約統計まで与えた、指標の点検用の人工配置である。未来の配置を予測したとは主張しない。
使ったのは公開データPF-Astroの sample1。Perturb-FISHで測られた、ヒト多能性幹細胞由来アストロサイトのデータである。元の測定 (3) をSubcellPertの著者が再構成した公開版 (4) から、RNA座標と細胞・遺伝子の対応を読み取った。
この標本には3,532細胞、4,247,341分子のRNAがある。そのうち対照838細胞とASXL3介入条件361細胞を対象にした。介入条件は、同標本で細胞数が最も多いASXL3を選んだ。二条件はまとめて指標の診断へ使い、両者の差を介入効果として推定してはいない。
遺伝子は、同じ標本の対照でRNA総数が多い順に5つ選んだ。VIM、HIF1A、FKBP10、ITGAV、CDC37である。差が大きく見えた遺伝子を後から選ぶ手順にはしなかった。さらに、細胞と遺伝子の組ごとに20分子以上あるものを残すと、1,194細胞から4,681組の点群が得られた。
それぞれに、次の二種類の人工点群を作る。
- ガウス置換:正規乱数から、元と同じ数の点を作る。
- 再標本化:元の観測点から、復元抽出で同じ数の点を選ぶ。
どちらも、その後のアフィン変換で元の重心と共分散に厳密に合わせる。再標本化も補正するので、両者ともRNA数・重心・共分散という条件は同じだ。
式で書けば、提案点群を \(U\)、元の点群を \(X\) として、
\[ Y=(U-\bar U)\,\Sigma_U^{-1/2}\Sigma_X^{1/2}+\bar X \]
とする。共分散は分母を分子数 \(n\) としたものを使い、対称行列の固有値分解から平方根を計算した。退化した共分散は許さない。
各組で5回作成し、距離は各組で5回の平均を取ってから、遺伝子ごとに細胞間の中央値へまとめた。この5回は乱数による繰り返しであって、生物学的な反復ではない。
二次モーメントが同じでも形は残る
作成した全点群で、重心の差の最大値は \(4.5\times10^{-16}\) 未満、共分散行列の差の最大値は \(2.6\times10^{-15}\) 未満だった。RNA数も元と同じである。丸め誤差の範囲で、これらは一致している。
それでも、元の点群との距離は残った。下表は、全RNA重心からの半径分布に対する一次Wasserstein距離の中央値である。単位は規格化座標の距離で、マイクロメートルではない。
表2. モーメント補正後の人工配置と観測配置の半径W1。
| Gene | Cell–gene pairs | Resampling radial W1 | Gaussian-replacement radial W1 |
|---|---|---|---|
| VIM | 1,192 | 0.043 | 0.197 |
| HIF1A | 1,080 | 0.061 | 0.139 |
| FKBP10 | 849 | 0.076 | 0.160 |
| ITGAV | 812 | 0.077 | 0.168 |
| CDC37 | 748 | 0.085 | 0.113 |
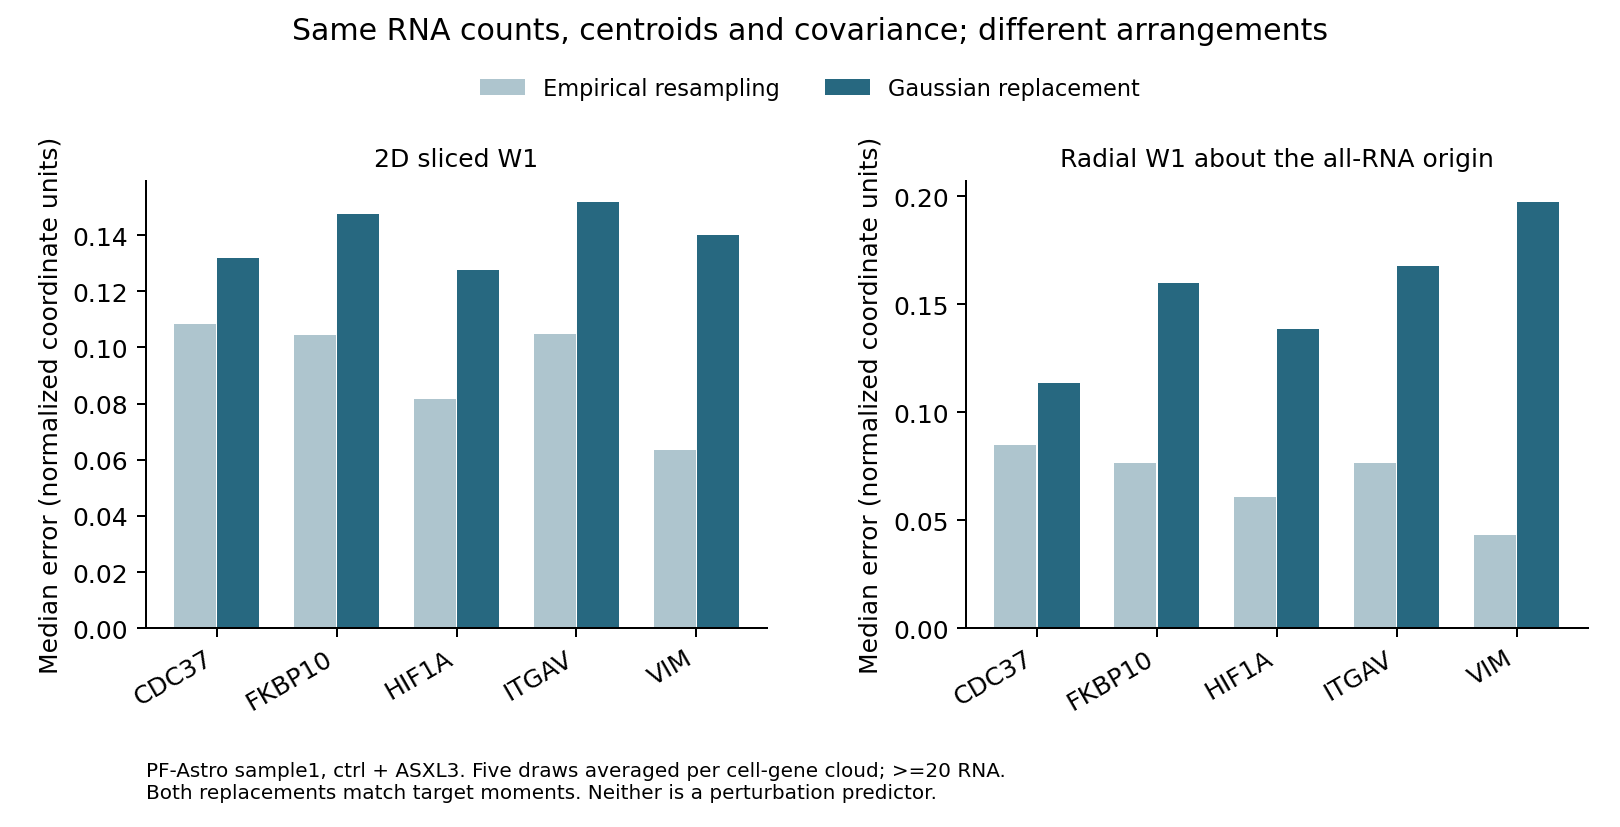
図1. 同じRNA数・重心・共分散を持つ人工配置のsliced W1と半径W1。原著モデルの予測誤差ではなく実測点群を使った指標診断。
図の左側は32方向へ投影した一次元W1の平均で、二次元配置の違いを見る。右側は全RNA重心からの半径だけを見る。どちらも私の細胞・遺伝子ごとの診断であり、生物学的単位や遺伝子を重み付けして集約する原著の公式スコアとは同一ではない。
5遺伝子すべてで、ガウス置換の中央値は再標本化より大きかった。最低分子数を40、80へ上げても、その方向は変わらなかった。ただし80分子ではCDC37は2組しか残らず、閾値を上げれば確かな比較になるとも限らない。
再標本化の距離もゼロにはならない。有限個の分子を引き直せば、観測点とのずれが生まれる。しかも元の観測点を再利用しているので、独立した再測定の誤差を推定した値ではない。ガウス置換がこれより遠いことは、この標本のRNAの分布には、二次モーメントだけでは捉えられない形の違いがあることを示す診断であり、一般のモデル間の有意差や、薬剤の効果量ではない。
もう一つ限界がある。人工点群は実際の細胞境界を制約にしていない。元の細胞と同じ形の細胞を作れたとはいえないし、できた点を生物学的に実在するRNA配置と解釈することもしない。
核内・核外の判定には境界情報が要る
今回の結果から、重心を捨てて半径だけ見ようという話にもしたくない。
たとえば原点から同じ距離に点が並んでいても、上下左右にあるか、斜め方向にあるかで配置は違う。半径分布は同じなので、半径W1は区別できない。添付テストには、重心・共分散・半径が同じでも、投影方向に沿った分布が違う点群を入れた。
量、重心、広がり、半径、方向は、それぞれ別の要約である。一つの数字へまとめる前に、何を失ってよいかを決める必要がある。特定RNAの局在を調べたい実験なら、全体の空間誤差が小さいだけでは、そのRNAの問題が解けたとは限らない。
また、予測から消えた遺伝子の配置を、誤差ゼロとして扱うわけにはいかない。まず対象とする遺伝子のうち予測に含まれた割合を確かめ、その上で共通の遺伝子集合について配置を比べる。原著の公開コードも、被覆率と共有遺伝子上の空間スコアを分けて読むよう求めている。Evaluation specification
RNA数と配置の一致は別の性質である
今回の例では、RNA数・重心・共分散が一致していても、座標分布の形が残った。発現量の表へ集約すると消える情報があることを、同じ標本の座標で確かめられた。
ただし、座標の違いがRNA輸送の機序とは限らない。細胞の分割、観測パネル、検出、細胞形状や集団構成も分布を変える。規格化後の座標から絶対移動距離は求められず、核の境界がなければ核内・核外も判定できない。
SubcellPertが広げたのは空間配置の予測を評価する範囲であり、別々の細胞のスナップショットから同じ分子の移動経路を観測できるようになったわけではない。
データとコードの公開状況
診断コードと集計入力に、点群ごとの診断値、乱数を平均した集計、描画・テスト・元データ取得手順をまとめた。元の画像、RNA座標、細胞注釈、学習済みモデルは同梱していない。
元データの版、取得ファイルのSHA-256、選択条件は inputs/provenance.json に記録した。取得後に同じ診断を作り直す手順と依存関係はREPRODUCE.mdを参照。これは原著608学習実行の再現ではなく、1標本の実測座標を使った独立診断である。
参照
1. Wang J, Cao H, Dang X, Zhou T, Zhao Y, Hsieh CY, et al. SubcellPert: benchmarking subcellular perturbation prediction. bioRxiv. 2026 October 17. Version 1. doi:10.64898/2026.10.11.758305. Preprint.
2. king159. SubcellPert. GitHub repository. Source code and evaluation specification.
3. Binan L, Jiang A, Danquah SA, Valakh V, Simonton B, Bezney J, et al. Simultaneous CRISPR screening and spatial transcriptomics reveal intracellular, intercellular, and functional transcriptional circuits. Cell. 2025;188:2141–2158.e18. doi:10.1016/j.cell.2025.02.012.
4. king159. SubcellPert datasets: PF-Astro reconstruction. Hugging Face. Dataset repository.