平均は合った。でも細胞の分布は違った。最適輸送で応答を読む
On this page
要旨
公開4i画像データの3薬剤・pERK一マーカーで、平均に基づく予測と1次元分位点写像を比較した。平均誤差が小さくても分布の距離は残り、分位点写像で距離が小さくなっても高値側割合は完全には一致しなかった。投与後の学習セルを使う既知条件内の評価であり、未知薬剤への予測検証ではない。別の数理例から、周辺分布の一致だけでは細胞ごとの履歴を識別できないことも示す。
背景と目的
薬剤を加えた細胞の平均値を予測できた。しかし、一部の細胞だけが高い値を保つのか、全体が同じように変わるのかは、平均だけでは分からない。
細胞応答の予測を、遺伝子やタンパク質の平均から、細胞集団の分布へ広げる方法の一つが最適輸送である。私は、その価値を「平均では見えない違いを、何で確かめるか」という問いから考えたい。
対象と確認範囲
この記事では、公開4iデータの3薬剤について、タンパク質のリン酸化マーカーpERKの分布を使った小さな検証を行う。4iはRNA測定ではなく、画像による多項目のタンパク質測定である。pERKはERKのリン酸化状態を表すマーカーである。CMongeやCellOTの再学習ではなく、1次元の分位点写像と単純な対照を自作して比較した。文献・データ確認日:2026年10月12日。
最適輸送は観測していない細胞の対応を補う
single-cell RNA-seqなどでは、測定時に細胞を壊すため、介入前と介入後の同じ細胞を通常は一対一で測れない。得られるのは、対照と投与後の別々の細胞集団である。
CellOTは、この対応のない分布の間に、変化のコストを小さくする写像を学ぶ。CMongeは、薬剤や用量などの条件を与えて写像を学ぶ枠組みへ拡張する。個別条件の分布を扱うことと、未測定条件へ予測することは、検証を分ける必要がある。CellOT原著 (1)、CMonge原著 (2)
最適輸送の「輸送」は、細胞を物理的に動かす意味ではない。発現やマーカー値の空間で、対照の状態を投与後の状態へ対応させる計算である。どの変化を近いと扱うかは、距離、スケール、使う特徴に依存する。
ここで二つの問いを分けたい。予測した細胞集団が、実測集団の分布に近いか。さらに、ある細胞が実際にその状態へ変わったか。対応のない測定から、前者を確かめることはできても、後者をそのまま検証したことにはならない。
方法
解析対象とセル分割
解析対象は8時間の前処理済み4iファイルの、対照、trametinib、dabrafenib、everolimusである。3薬剤はCellOTのExtended Data Figure 2で細胞応答の写像を示した例に合わせて選んだ。intensity-cell-pERK-meanという一つの特徴を使う。この名前のmeanは、画像内で一細胞の強度を集計した平均であり、この記事が比較する集団平均とは別である。
原配布先はETHのデータ登録 (3)である。取得時にダウンロードが応答制限を返したため、別の最適輸送研究の公式研究ベンチマークの4i配布ファイル (4)を使用した。取得版とSHA256は配布物に記録したが、原アーカイブとのバイト単位の同一性は未確認である。
取得ファイルは119,479細胞・78特徴。論文が報告する解析版とは細胞数・特徴数が異なり、その解析版を再現したものではない。今回使う4条件は18,899細胞で、各条件のセル行を80%の学習用と20%の評価用に分けた。対照の分割は全薬剤で共有する。
表1 主分割のセル行数
| 条件 | 学習セル | 評価セル |
|---|---|---|
| 対照 | 8,796 | 2,199 |
| Trametinib | 2,109 | 528 |
| Dabrafenib | 2,140 | 535 |
| Everolimus | 2,073 | 519 |
これは既知の薬剤条件内でのセル分割である。投与後の学習セルを使うので、未知薬剤への予測を評価していない。 また、観測の群情報は薬剤ラベルだけで、well、実験反復、細胞株、用量を使った分割はできない。多数の細胞を、多数の独立した実験と数えない。
pERKは公開ファイルの前処理後の値をそのまま用いた。前処理を生画像から再現しておらず、絶対的なリン酸化量や薬剤間の臨床的な強さを推定する解析ではない。
比較する予測
同じ学習・評価の分割で、次の三つを比べた。すべて投与後の学習分布を使う。
表2 比較する予測と保持する情報
| 予測 | 対照の評価セルに与える値 | 保持するもの |
|---|---|---|
| 平均一点 | 全セルに投与群の学習平均を返す | 平均だけ |
| 平均倍率 | 対照値を、投与群平均/対照平均で掛ける | 対照分布の相対的な形 |
| 分位点写像 | 対照での順位を投与群での同じ分位点へ対応させる | 投与群の分布の形を反映する |
連続的な1次元分布で、対照の累積分布を\(F_0\)、投与後を\(F_1\)とすると、分位点写像は
\[ T(x)=F_1^{-1}\{F_0(x)\} \]
と書ける。対照で下位側にいる細胞を、投与後でも下位側の状態へ対応させる。この単調な写像が、1次元の最適輸送を具体的に見る入口になる。
実装では学習セルの順位と分位点を線形補間し、対照の学習範囲の外は端へ固定した。これは有限標本での近似であり、任意の離散分布の質量を厳密に一致させる実装ではない。極端な尾を外挿するモデルでもない。
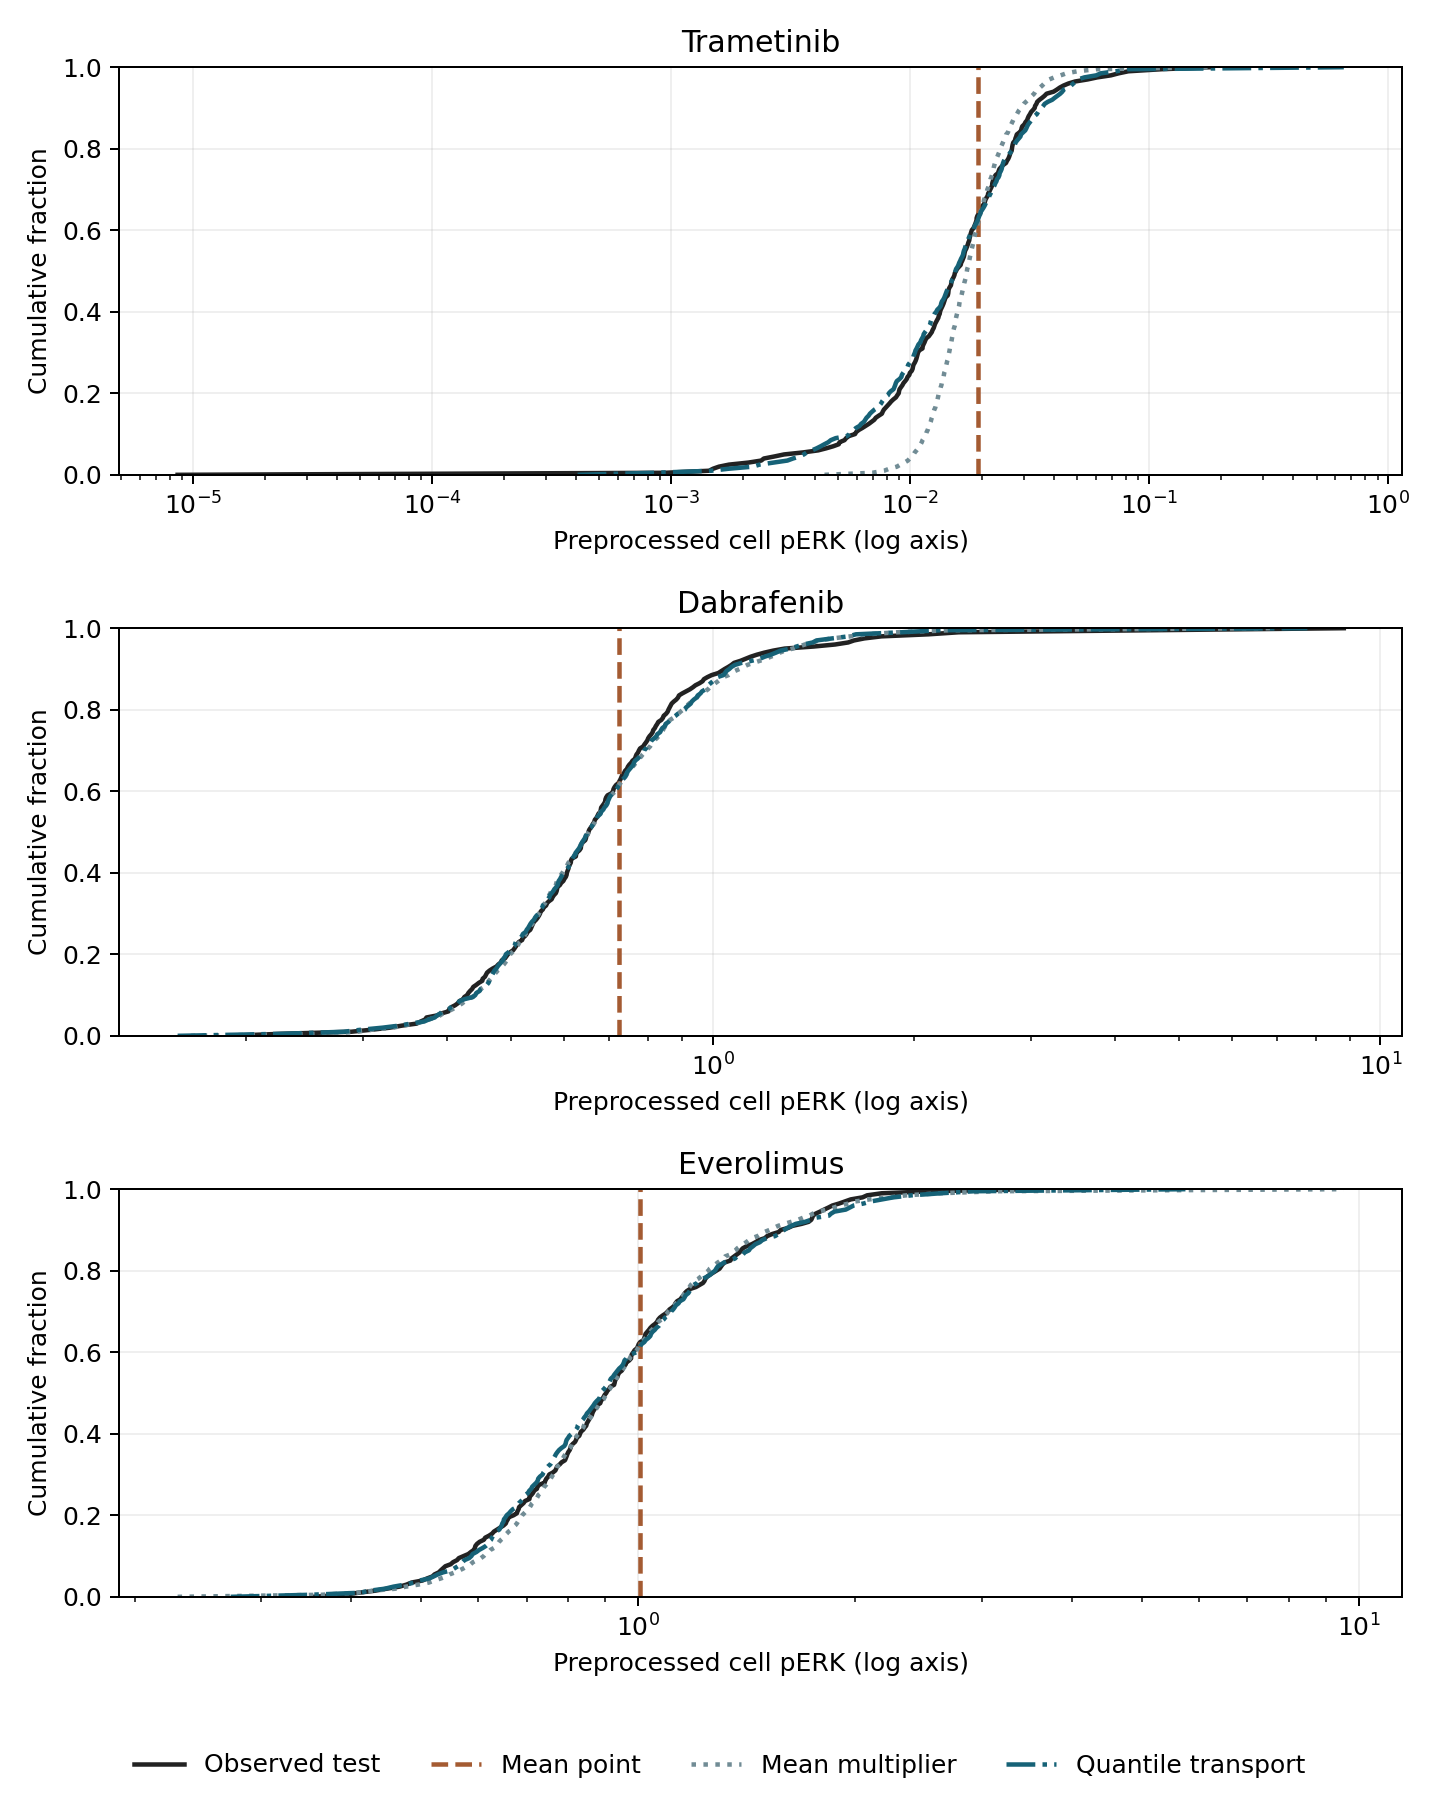
図1。 黒は投与群の評価セル、橙は平均一点、灰は平均倍率、青は分位点写像。縦軸はその値以下のセル割合、横軸は前処理後pERKの対数目盛である。横軸の範囲は薬剤ごとに異なるので、各パネル内で予測と実測を比べる。線は201分位点で描いた。橙の縦線は、全セルを同じ値にまとめる予測を表す。
結果
平均誤差と分布の距離
分布の違いにはWasserstein-1距離を使った。1次元では、分位点どうしの距離を積分する尺度である。
\[ W_1(\mu,\nu)=\int_0^1|F_\mu^{-1}(u)-F_\nu^{-1}(u)|\,du. \]
平均誤差と\(W_1\)は、ともに対照の学習セルの標準偏差で割った。平均誤差は予測平均から実測平均を引いた符号付きの差で、距離は小さいほど分布が近い。距離計算には、図の201分位点ではなく、評価用の全セル値を使った。
表3 平均誤差とWasserstein距離
| 薬剤 | 予測 | 平均誤差/対照SD | W1/対照SD |
|---|---|---|---|
| Trametinib | 平均一点 | 0.0000 | 0.0260 |
| Trametinib | 平均倍率 | 0.0003 | 0.0109 |
| Trametinib | 分位点写像 | −0.0002 | 0.0036 |
| Dabrafenib | 平均一点 | −0.0694 | 0.6394 |
| Dabrafenib | 平均倍率 | −0.0605 | 0.1359 |
| Dabrafenib | 分位点写像 | −0.0644 | 0.1193 |
| Everolimus | 平均一点 | 0.0172 | 0.7979 |
| Everolimus | 平均倍率 | 0.0295 | 0.0762 |
| Everolimus | 分位点写像 | 0.0263 | 0.0687 |
例えばEverolimusでは、平均一点の平均誤差は0.0172と小さいが、距離は0.7979だった。平均倍率は、平均誤差が少し大きくても距離を0.0762まで減らした。平均を当てることに加え、集団の広がりを残すことが効いている。
分位点写像はさらに分布の形を反映する。しかし、これはCMongeが他モデルより優れるという再検証ではない。すでに測った投与群の形を使っており、一つのマーカーに限った自作の診断例である。特徴間の相関や、高次元での細胞状態を再現した結果ではない。
また、投与群の学習セルをそのまま分布として評価セルと比べた参照距離は、主分割のEverolimusで0.0614だった。分位点写像の0.0687には、学習と評価の標本が違う影響も混ざる。この参照は、未知の細胞へ予測するモデルでも、性能の厳密な上限でもない。
高値側割合と分割感度
分布の距離に加え、高いpERKを持つ側の割合を調べた。閾値は薬剤ごとの投与学習セルの90%点に固定し、評価セルを見て変更していない。
表4 学習群で固定した閾値を超える割合
| 薬剤 | 実測の高値側割合 | 平均倍率 | 分位点写像 |
|---|---|---|---|
| Trametinib | 7.77% | 4.87% | 10.19% |
| Dabrafenib | 9.53% | 11.51% | 10.19% |
| Everolimus | 10.02% | 8.59% | 10.19% |
分位点写像の値がすべて約10%なのは、学習分布の順位を移す構造に由来する。未知の高値集団を発見したわけではない。Trametinibでは実測7.77%に対して10.19%であり、近い全体分布を得ても、特定の尾の割合が完全に一致するわけではなかった。
この高値側を「耐性細胞」と呼ぶ証拠はない。8時間のマーカー値だけでは、その後の生存、増殖、再投与への応答は分からない。耐性を問うなら、その表現型を別に測り、マーカーによる分類と照合する必要がある。
分割をさらに2通り変えた感度解析でも、三つの薬剤で分位点写像の距離は平均倍率より小さかった。ただし距離の大きさは動く。Everolimusの学習群と評価群の参照距離は、3分割で約0.044〜0.143だった。これは分割の感度であり、独立した生物学的反復からの信頼区間ではない。
考察
ここまでは分布の評価である。対応のない測定から個々の細胞の変化まで言えるかは、別の問題になる。
4点の数理例を考える。対照と投与後のどちらにも、状態−2、−1、1、2が同じ割合である。同じ値どうしを対応させても、順序を反転させて対応させても、観測する二つの分布は同じになる。
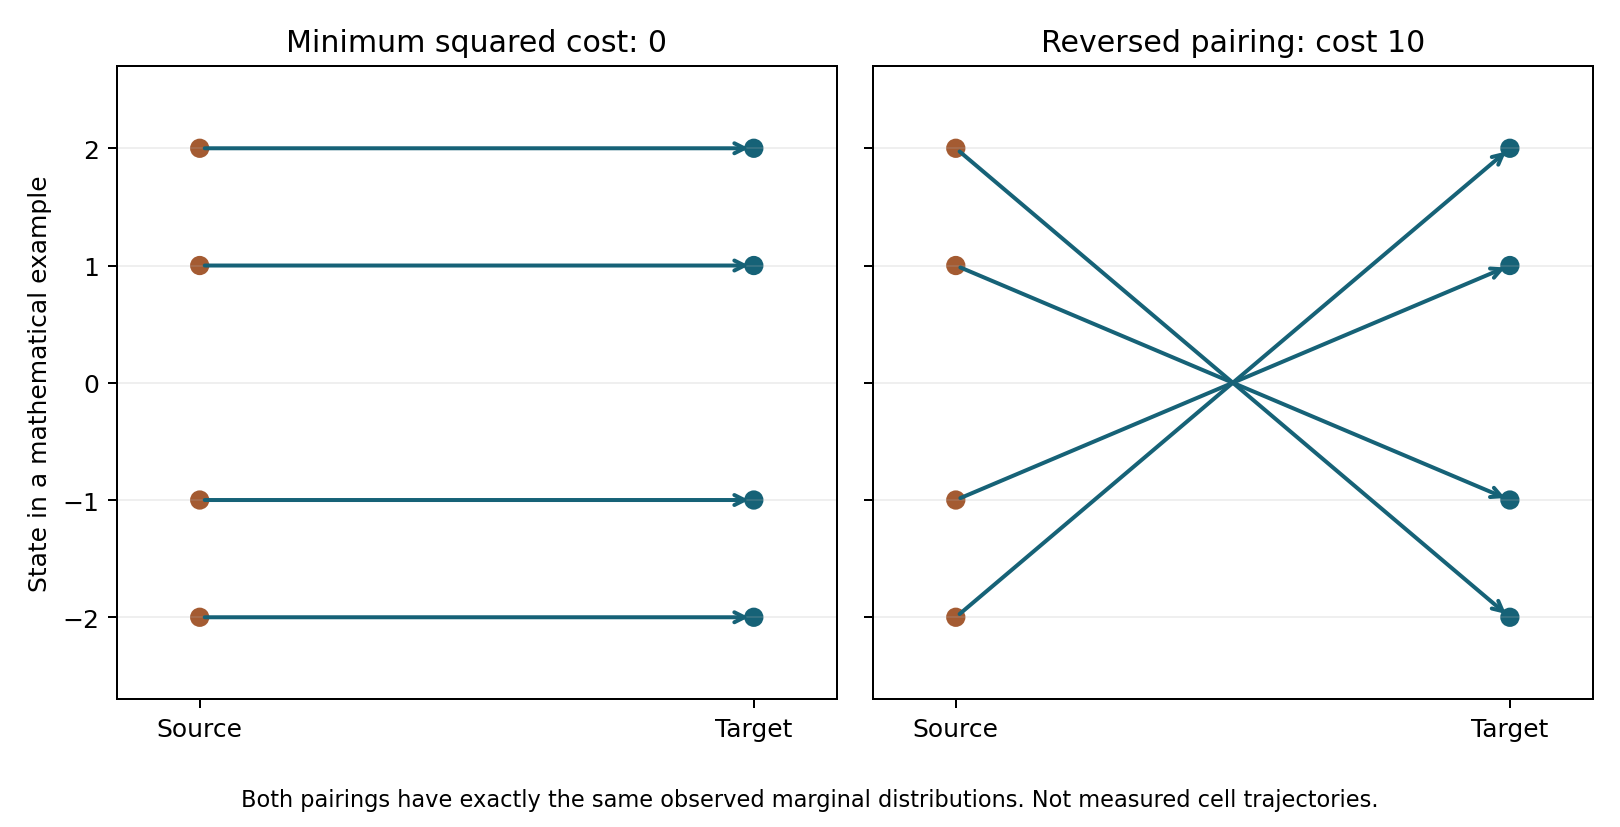
図2。 実測データとは別の数理例。左は同じ値への対応、右は逆順への対応。平均二乗の輸送コストは左0、右10。対応する状態の相関も左1、右−1になるが、対照と投与後の周辺分布は両者で同じである。
二乗距離を小さくする最適輸送は左を選ぶ。その選択は明確な数理仮定に基づく。しかし、実際の生物学が最小コストの対応に従ったという観測を、この二つの分布だけから得たわけではない。分布への適合が良いことと、細胞ごとの履歴を識別したことを区別したい。
さらに、今回の比較は、測定に残った細胞の割合を合計1にした分布を扱う。薬剤によって細胞が減ったり、集団の構成が変わったりした結果も、正規化後の分布へ入る。分布の写像だけで、細胞死、増殖、状態変化を分離できるとは言えない。
結論
マーカーの平均、分布距離、高値側割合は、今回のデータでも異なる応答の特徴を表した。ただし、これらはいずれも周辺分布の指標であり、同じ細胞の履歴や絶対数を復元するものではない。
データとコードの公開状況
自作コード・集計結果・図・再実行手順を配布する。元の4iファイルはZIPに含めず、固定URLからの取得とハッシュ確認をするfetch_data.pyを用意した。Python、NumPy、SciPy、h5py、matplotlibを使い、analysis.pyで3分割の結果を再計算できる。
解析は探索的で、データの代表値を確認した後に範囲を固定した。3薬剤・一マーカーのセル分割を、未知薬剤・患者・実験系への汎化と解釈しない。
資料はCellOT (1)、CMonge (2)、4i data record (3)、取得に用いた公式研究ベンチマーク (4)である。第三者の図・論文・コード・モデル重み・個別セル識別子は配布物に含めていない。
参照
- Bunne C, Stark SG, Gut G, del Castillo JS, Levesque M, Lehmann KV, et al. Learning single-cell perturbation responses using neural optimal transport. Nature Methods. 2023;20(11):1759–1768. doi:10.1038/s41592-023-01969-x.
- Driessen A, Rajwade DA, Harsanyi B, Rapsomaniki M, Born J. Conditional Monge Gap enables generalizable single-cell perturbation modelling. Nature Machine Intelligence. 2026;8(6):984–996. doi:10.1038/s42256-026-01242-8.
- Bunne C, Stark S, Gut G, Lehmann KV, Pelkmans L, Krause RA, et al. Datasets of Learning Single-Cell Perturbation Responses using Neural Optimal Transport [Dataset]. ETH Zurich; 2023 Apr 27. Data record.
- EntropicOTBenchmark contributors. EntropicOTBenchmark: single-cell drug 4i data [Research benchmark distribution]. Commit db2a4d0888e593659786fa27785c2fe1c82678fc [cited 2026 Oct 12]. Fixed files.