CytoVIでバッチ差を消すと残したい差はどうなるか
健康骨髄の公開測定に既知のバッチ差を加え、交差した設計と完全交絡を比較する。CytoVIの保存出力から、粗い細胞型の読出しと同一型内の参照差を別々に診断する。
On this page
背景と目的
別々に測った細胞を一つの図へ並べるとき、バッチ差を消すだけでは足りない。病態やドナーによる差まで消してしまえば、その後の比較の目的を失う。逆に、差を残せたように見えても、技術的なずれが残っている場合もある。
CytoVIは、フローサイトメトリー、質量サイトメトリー、CITE-seqなどの抗体に基づく単一細胞測定を扱う生成モデルだ。2026年9月30日公開の(1)は、統合、未測定タンパク質の補完、差次的発現などを示している。ここではモデル紹介から進めて、何を消して、何を残すかを検査できる測定設計になっているかを点検する。
原著でも使われた公開骨髄データに既知の人工バッチ差を加え、CytoVIを実行した。健康な2人のデータを使う半合成実験であり、患者の病態差を保存できたと実証するものではない。
細胞型が保たれても型の中の差は別に残る
CytoVIは測定値から潜在表現を推定し、バッチなどの共変量を条件に測定値を再構成する。補正した表現と、同じバッチ条件へ揃えて復号したタンパク質発現は、元の実測値とは異なる推定量である。(2)
統合後にもT細胞、B細胞、単球などの区別が残ることは重要だ。しかし、同じT細胞型の中で患者群に特徴的だった発現差まで残るとは限らない。粗い細胞型のラベルが正しいことと、その型の内部にある比較対象の差を保存することは別の検査になる。
さらに、細胞型のラベルが測定されたマーカーから手動gatingで作られている場合、そのラベルとの一致は独立した臨床的な正解ではない。統合の指標を、どの生物学的な判断に使うかまで決める必要がある。
二人を両バッチで測る場合と別々に測る場合
Levineらの32次元骨髄CyTOFデータ (3)を使った。公開FCSには265,627細胞、32タンパク質、健康な2ドナーがある。14の手動gatingラベルが付くのは104,184細胞で、残り161,443細胞は未割当だった。FCSの全数とドナー別の数を独立に読み取って照合した。
各ドナー・細胞型から固定乱数で最大150細胞を選び、4,109細胞を解析した。ドナー1は2,100細胞、ドナー2は2,009細胞である。これは細胞型を点検しやすくする抽出で、元の骨髄における細胞型の割合を代表する標本ではない。未割当の細胞も適合対象にしていない。
配布FCSのマーカー値は既にarcsinh変換されているため、もう一度変換していない。抽出集合内で32タンパク質を標準化し、8マーカーにバッチ1だけで+0.8の既知シフトを加えた。CD4、CD8、CD19、CD20、CD34、CD38、CD14、HLA-DRが対象で、0.8は標準化後の単位だ。
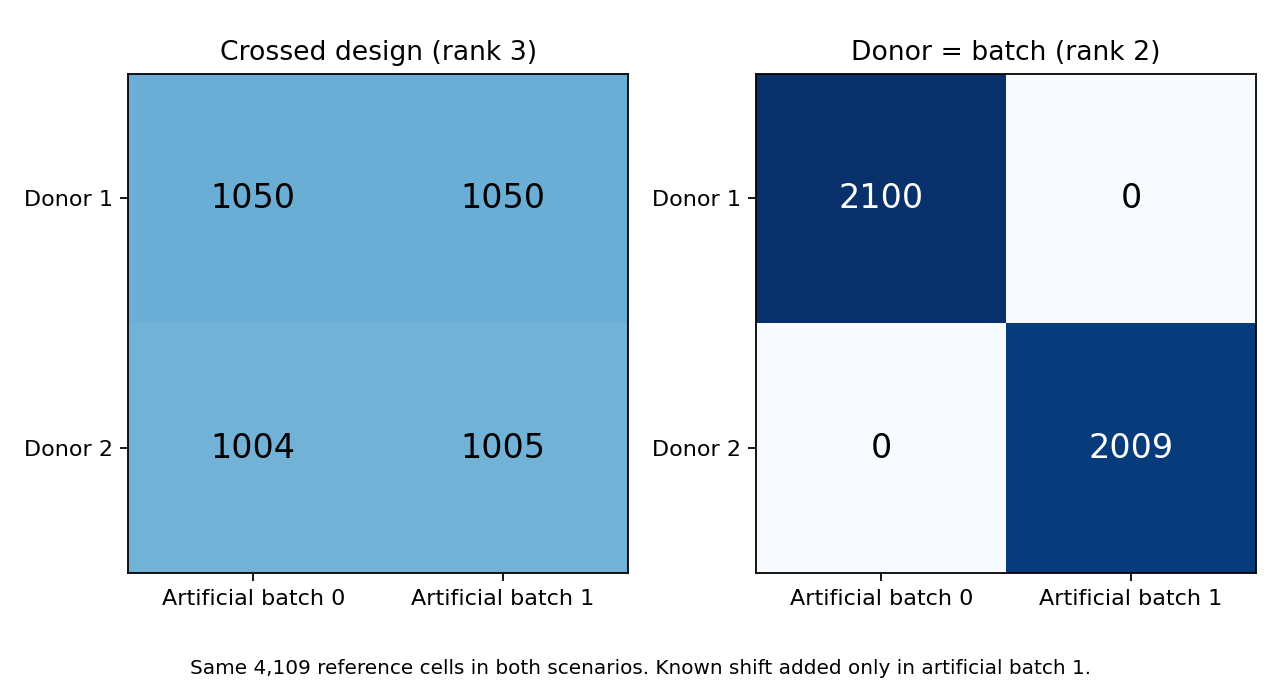
図1. 両条件で使う参照細胞は同じ。左は各ドナー・細胞型を二つの人工バッチへほぼ半数ずつ割り付ける。右はドナー1をバッチ0、ドナー2をバッチ1へ割り付ける。図中の数は実際の細胞数であり、独立したドナーや実験反復の数ではない。
注入前の測定を参照として保存した。ただし、そのドナー差自体にも元の技術差や標本誤差が含まれ得る。ここで残したいのは、追加操作の前にあった参照上の差であり、誤差のない生物学的真値や病態差と呼んでいない。
完全に重なる二つの原因はデータだけでは分けられない
あるタンパク質の値を単純化して
\[ x=\mu+\delta_D D+\delta_B B+\varepsilon \]
と表す。\(D\)はドナー2の指示変数、\(B\)はバッチ1の指示変数とする。両ドナーを両バッチで測れば、この二つの列は同じではない。
一方、ドナー2だけをバッチ1で測ると\(D=B\)になる。観測が説明できるのは\(\delta_D+\delta_B\)という和で、ドナー差とバッチ差を別々には決められない。今回の切片・ドナー・バッチのデザイン行列も、交差した設計ではrank 3、完全交絡ではrank 2だった。
深いモデルに変えても、この情報が測定から増えるわけではない。モデルの仮定や外部の参照に基づいて分けることはできるが、その分け方が正しいと今回の観測だけで検証したとは言えない。人工実験で既知シフトを引くoracleが正しく戻せるのは、通常の解析にはない注入量の情報を持つからだ。
CytoVIで復号した差を保存した参照と比べる
scvi-tools 1.4.2のCytoVIを、各設計で二つの乱数seedを使って適合した。32タンパク質を入力し、潜在10次元、隠れ64ノード、正規尤度・正規潜在分布、混合事前なしで120 epoch学習した。ドナーや細胞型ラベルはモデルに渡していない。復号は人工バッチ0へ揃え、20回の潜在サンプルを平均した。(4)
これは原著の設定・性能ベンチマークの再現ではない。小規模な一つの固定設定であり、最適化済みのモデルとは扱わない。学習は固定epochで終了し、収束の十分性は確認していない。学習に割り当てた3,699細胞と検証用410細胞を含む、同じ4,109細胞について診断した。
各細胞型について、32タンパク質のドナー2-ドナー1の平均差を計算した。参照の差ベクトルを\(d\)、補正後を\(\hat d\)として、14細胞型を均等に扱い、次の二つを調べた。
\[ \mathrm{RMSE}=\sqrt{\operatorname{mean}\bigl((\hat d-d)^2\bigr)},\qquad c=\frac{\sum d\hat d}{\sum d^2} \]
RMSEは参照との差の誤差、\(c\)は参照方向への射影係数である。\(c=1\)ならその方向の大きさが一致し、0なら参照方向の成分がない。ただし1でも別方向の誤差はあり得るため、RMSEと一緒に見る。負の値や1超も取り得る係数で、0~100%の保存率ではない。
表1.同じ細胞型内のドナー対比と保存した参照との差。
| Design | Correction | Contrast RMSE | Reference-direction coefficient |
|---|---|---|---|
| Crossed | Simple batch-mean alignment | 0.00003 | 1.000 |
| Crossed | CytoVI seed 0 / 1 | 0.250 / 0.245 | 0.540 / 0.551 |
| Fully confounded | Simple batch-mean alignment | 0.349 | 0.386 |
| Fully confounded | CytoVI seed 0 / 1 | 0.406 / 0.413 | 0.122 / 0.108 |
| Both designs | Oracle subtracting known shift | 0 | 1 |
単純な平均合わせに有利な、一定の加算シフトを作った実験である。この表から複雑な現実のバッチ差でも単純補正が最良だとは結論しない。また、CytoVIの復号値はdenoisingも含むため、参照との差をすべて過剰補正による生物学的情報の損失だと断定していない。
交差した設計では、補正なしでもドナー対比のRMSEは約0.00061、射影係数は約1だった。両ドナーにほぼ同じ人工シフトが加わり、差を取ると打ち消されるためだ。しかし、細胞ごとの参照値に対するRMSEは約0.283残っていた。ドナー差の保存だけでも、バッチ差の除去だけでも、補正の成否は判定できない。
粗いラベルの読出しと型の中の参照差を分けて測る
主解析を見た後の補助診断として、15近傍の分類器で手動細胞型ラベルを読み出し、5分割のmacro recallを調べた。CytoVIでは10次元の潜在表現、他の方法では32タンパク質の表現を使う。表現の次元も違うため、公平なモデル性能の順位比較ではない。ラベルは分類器の分割内で評価するが、CytoVI自体は評価細胞の発現も学習時に利用している。同じデータ内のtransductiveな診断で、外部ドナーの評価ではない。
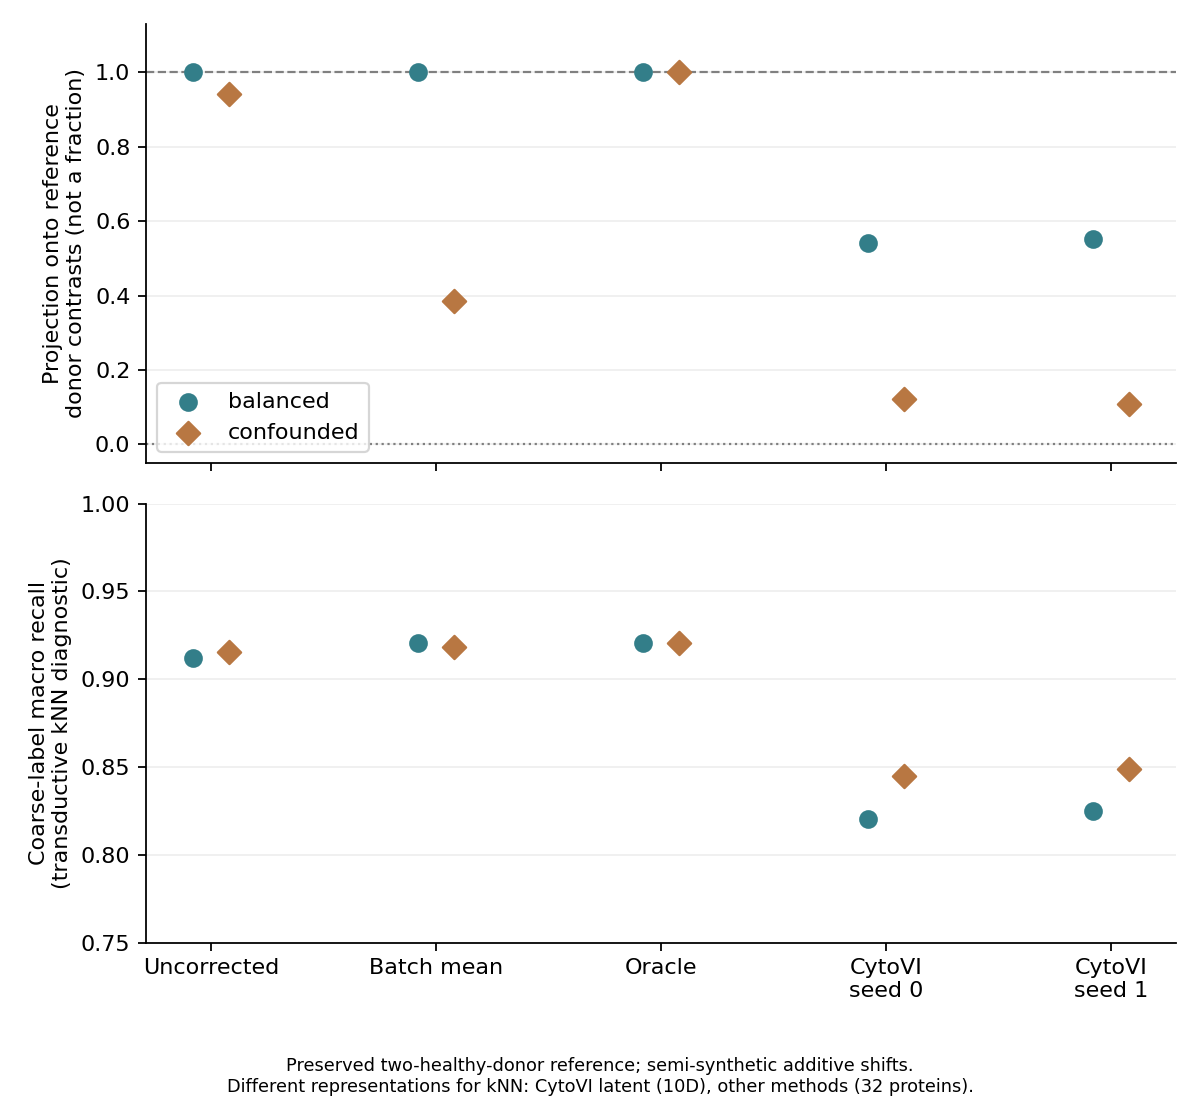
図2. 上は参照方向への射影係数、下は粗い細胞型ラベルのmacro recall。二つのseedは最適化の反復であり、生物学的な独立反復ではない。oracleは注入した量を知る比較対象。
CytoVIの粗いラベルのmacro recallは、交差した設計で0.820–0.825、完全交絡で0.845–0.849だった。一方、同一細胞型内のドナー対比の射影係数は、約0.54–0.55から約0.11–0.12へ変わった。粗いラベルの読出しが良くなったことを、残したい参照差も保存できたという証拠にはできない。
ここで二人の差を消すことが、実際の生物学的な誤りだと確定したわけではない。観測されたドナー差をどこまでノイズとして扱うかは別の問題だ。半合成実験だから参照との差を点検できるが、現実の完全交絡データでは、追加の測定や妥当な外部参照なしに同じ判断はできない。
考察
病態群が一つのバッチ、対照群が別のバッチでしか測られていない場合、群差とバッチ差を観測だけから分離することはできない。統合後に群が混ざる図も、病態の差を正しく残した証拠にはならない。
粗い細胞型が保存されても、細胞型内の群差や少数集団の割合まで保存されたとは限らない。細胞数を増やすことと、患者・ドナーの独立した反復数を増やすことも、異なる情報を与える。
CytoVIの原著にあるCLLの臨床フローデータには取得申請の条件がある。本記事では取得や臨床成績の追試をしていない。今回の結果は、健康骨髄の公開測定に人工的なずれを加えた条件でのものだ。(原論文のData availability (1))
データとコードの公開
解析コード・参照入力・保存出力・独自図をダウンロード。numpyとscikit-learnで保存出力の診断と10件のテストを再実行できる。元の公開FCS約44 MBからの抽出と、scvi-tools 1.4.2でのモデル再適合の手順も収録した。学習済み重みや原著図、元FCSは同梱していない。
input-provenance.jsonに出典版、SHA-256、入力と保存出力のハッシュを、REPRODUCE.mdに設定と範囲を記録した。主解析は適合前に設定を固定したが、粗いラベルの補助診断は結果確認後に追加した。公開資料と結果を見た後の探索的な点検であり、事前登録した臨床研究ではない。保存出力からの再計算は再現できるが、別環境で再学習した浮動小数点値の完全一致は保証しない。
本記事は、CytoVIの一般的な優劣、全種類のバッチ差、未注釈細胞、病態差の真値、診断性能、独立患者への一般化を検証していない。参照差が変わったという結果と、臨床上残すべき差を消したという結論を分けて読む必要がある。
参照
- Ingelfinger F, Levy N, Ergen C, Bakulin A, Becker A, Boyeau P, et al. CytoVI: deep generative modeling of antibody-based single cell data. Nature Methods. 2026;23(10):2054–2065. doi:10.1038/s41592-026-03224-5.
- scvi-tools developers. CytoVI: model description. User guide. Accessed 2026 Oct 14; analysis used scvi-tools 1.4.2.
- Weber LM. Clustering benchmark data: 32-dimensional data set from Levine et al. (2015) [Dataset and preparation code]. Revision c6737786dcff3a50145993efed451a2af55e0a00. GitHub. Accessed 2026 Oct 14.
- scvi-tools developers. scvi.external.CYTOVI: API reference. Documentation. Accessed 2026 Oct 14; analysis used scvi-tools 1.4.2.