AIエージェントに PK/PD 解析を任せられるか:公開のスキル集でワルファリン解析を再現させる
公開のPK/PDスキルを与えた場合と与えない場合で、AIエージェントに公開のワルファリンデータの母集団PK/PD解析を4回行わせ、私の解析と比べて、何ができて何を人が確かめる必要があるかを整理する。
実験日:2026年10月18〜19日。エージェントの出力、私の確認、私の解釈を区別して書く。
AIエージェントに科学の手順を教える「スキル」が増えている。K-Denseが公開した Scientific Agent Skills は、ゲノミクスから臨床研究までのスキルを集めたもので(リポジトリでは177)、Claude Code や Codex に入れて使える (1)。 薬物動態・薬力学(PK/PD)のスキル(pkpd-modeling)も含まれる。
スキル集の論文(163のスキルを記述)は、エージェントは動くコードは書けても、擁護できる解析を出すとは限らない、という問題意識から出発している (2)。 ただし論文自身が、タスク単位の評価は報告していないと書いている。
そこで、私が以前公開したワルファリンのPK/PD解析と同じデータと問いを、AIエージェントに任せてみた。スキルを与えた場合と与えない場合で2回ずつ、計4回である。基準にしたのは、その記事の第1.0版(2026年10月4日)である。この実験の結果を受けて、ワルファリンの記事は、PKモデルにラグタイムを加えた第1.1版(10月19日)と、Hill係数を推定した第1.2版(10月20日)に改訂した(後述)。
4回とも主要な推定値と問いへの答えは近かったが、レポートに現れない実装・再推定の誤りもあった。同じ条件内のばらつきが大きく、各2回からスキルの効果は判断できない。以下では、エージェントが出した結果とコードを読んで判明した問題を分けて記録する。
スキルの中身
pkpd-modeling スキル(2026年10月12日時点、MITライセンス)は、指示書(SKILL.md)、14の参考資料、10のPythonスクリプトからなる (1)。 スクリプトは、ノンコンパートメント解析、個別のコンパートメントモデルの当てはめ、母集団PKのデータセットの点検、投与計画のシミュレーション、生物学的同等性、薬物相互作用、TDMなどを扱う。
母集団PK(非線形混合効果モデル)の推定そのものは、スキルの中にはない。指示書は、推定にはNONMEM、Monolix、nlmixr2などの推定エンジンを使うよう書いている。スキルが与えるのは、単位と規約を先に決める、収束を識別可能性の証拠とみなさない、データセットの形式を点検する、といった手順と注意書きである。
実験の設計
- エージェント: Claude Code のサブエージェント(Claude、汎用型、モデルは claude-opus-5-5)。毎回新しい文脈で始めた。本記事の作成に使ったアシスタントと同じ系列のモデルである。
- 条件: スキルあり(S1、S2)とスキルなし(N1、N2)。スキルありでは、スキルのフォルダを作業場所に置き、最初にSKILL.mdを読むよう指示した。スキルの本来の起動の仕組みは使っていない。
- 作業場所: 回ごとに空のフォルダを用意し、データ(nlmixr2dataのwarfarin、515行)(3) だけを置いた。私の解析が同じコンピュータの別のフォルダとWebにあるため、作業フォルダの外を読まないこと、Web検索をしないこと、パッケージを追加しないことを指示した。これは指示であって、仕組みで強制したものではない。R 4.5.3(nlmixr2est 7.1.0、rxode2 5.1.8)とPython 3.12が使える。
- 課題(4回共通): データの点検、母集団PKモデル、PK/PDモデル、推定値と不確実性・診断・比較・限界の報告、そして「24時間までの本人の濃度を使うと、24時間以降のプロトロンビン複合体活性(PCA)の予測は、母集団予測より良くなるか」に答えること。指示文は公開ファイルに含めた。
- 採点: 実験の前に、私の解析を基準にした採点項目を決めた。採点は、基準の解析を作った側(私と、私が使うアシスタント)が行い、盲検化していない。基準は一人の解析者の解析であって正解ではない。
各条件2回なので、スキルの効果を推定するものではない。何ができて何ができないかの記述である。
条件をそろえられなかった点が三つある。第一に、エージェントには、私の作業環境の共通ルール(データの漏れを作らない、数値は実行したコードの出力から取る、など、私の解析プロジェクト全般の決まり)が両方の条件で読み込まれていた可能性が高い。スキルなしの条件も、一般的な解析ルールは与えられていたことになる。第二に、Claude Codeのサブエージェントはレポートのファイルを書くことを許されておらず、4回ともレポートを最終メッセージの本文で返した。第三に、利用上限で3回が途中で止まり、決まった文面で再開させた(文面は公開ファイルに含めた)。そのため所要時間とトークン数は比べられない(止まらなかったS2は約53分、17.7万トークン、52回のツール実行)。
結果
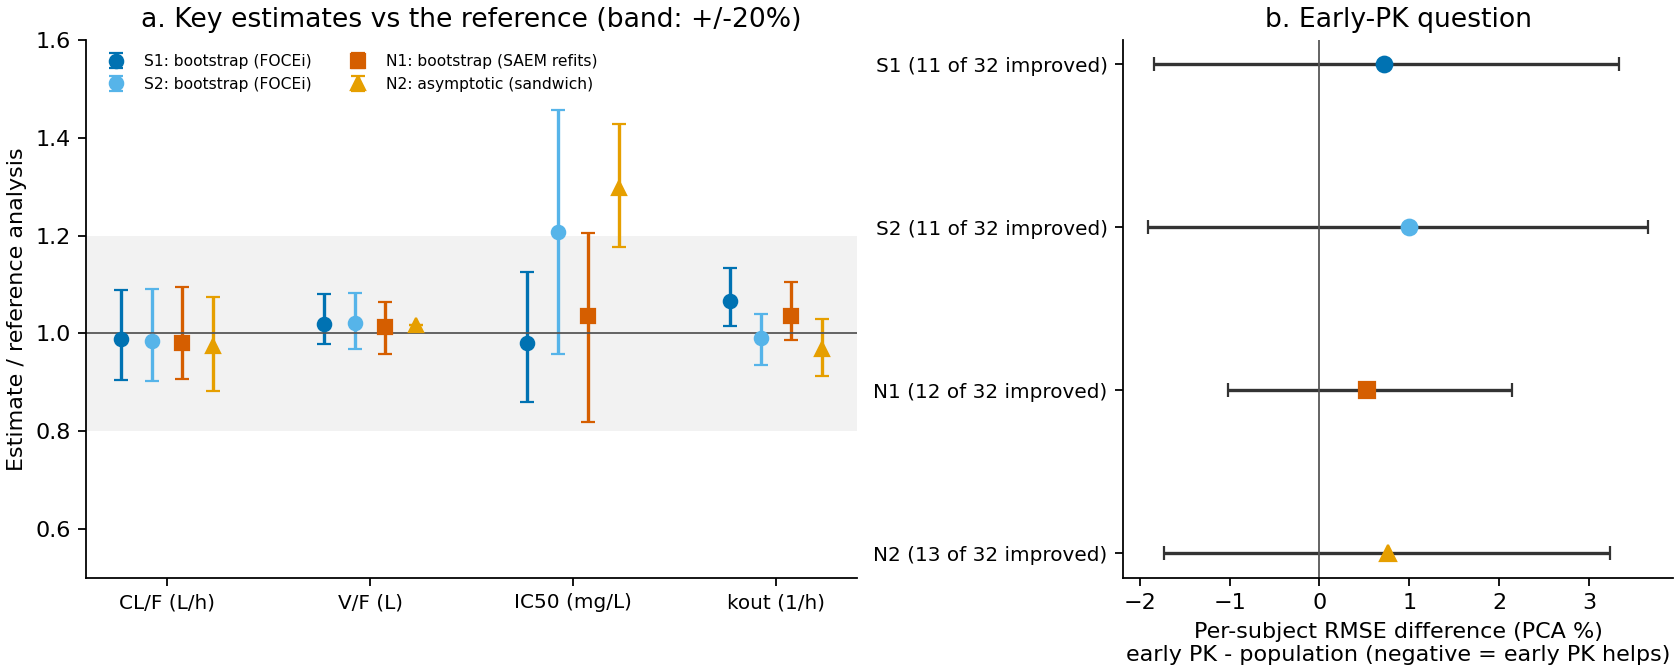
図1. (a) 4回のエージェントの主要な推定値を、私の解析(体重補正ありのモデル:CL/F 0.136 L/h、V/F 7.92 L、IC50 1.15 mg/L、kout 0.0514 /h)との比で示した。誤差棒は各エージェントが報告した95%区間で、種類が違う(S1とS2はFOCEiのブートストラップ、N1はSAEMで推定し直したブートストラップ、N2は漸近的な区間)。私の解析の推定値には最適化の警告があり、区間はない。N2のV/Fは2-コンパートメントモデルの容積の和(V1+Vp、区間なし)。灰色の帯は±20%。(b) 24時間までの本人の濃度を使った予測と母集団予測の、被験者ごとのRMSE(PCAの%ポイント)の差の平均と95%区間。負なら濃度の情報が役立ったことを示す。
(出力:results/comparison.csv、results/rubric.csv)
用語を簡単に補っておく。FOCEiとSAEMは、非線形混合効果モデルの推定の方法である。目的関数値(OFV)は当てはまりの悪さの指標で、同じデータの入れ子のモデルでは、差が約3.84以上なら1パラメータを加える価値があるとみなすことが多い。ただしこれは正則な条件での近似で、分散成分が0の境界などにはそのまま適用できない。turnoverモデルは、薬が凝固因子の合成を阻害し、因子は自分の速度(kout)で減るという形で、作用の遅れを表す。
データの点検
4回とも、32人・515行という構成、ID 1と7で基準時のPCAがないこと、0.5時間の濃度0が4件あること、ID 9に同じ時刻の異なる濃度が4組あること、体重あたり1.5 mg/kgの投与で用量と体重が分けられないこと、PCAが100%で頭打ちになっていることを見つけた。24時間より前の濃度があるのは13人だけで、残る19人は24時間の1点だけであることも、4回とも指摘した。
扱い方は分かれた。濃度0は、S2が観測値として残し(除いた場合を感度分析で確認)、他の3回は除外した。S1は打ち切りとして扱う感度分析を試みたが、推定が動かず結論は出なかった。
「経口投与なので求まるのは見かけのクリアランス(CL/F)と見かけの分布容積(V/F)」と明記したのは、スキルありの2回だけだった。スキルの指示書はこの点を明記するよう書いているが、2回対2回では偶然と区別できない。
PKモデル
4回ともnlmixr2で母集団PKモデルを組み、体重による補正を入れた。そして4回とも、吸収の遅れ(ラグタイム)とその個人差を加えたモデルを選んだ。私の解析(第1.0版)には、ラグタイムはなかった。
同じ回の中で比べると、ラグタイムを加えると目的関数値は約80下がり(S1、N1。濃度0を除いた場合)、さらにその個人差を加えると約60下がった。濃度0を残したS2では、ラグタイムとその個人差で約200下がった。ただし、warfarinはnlmixr2の解析例として広く使われているデータで、ラグタイムとturnoverを組み合わせた形は公開されている例に近い。エージェントが自分で見つけたのか、学習した知識を思い出したのかは区別できない。
ここで一つ、エージェントが気づいていない誤りがあった。S2の比較表には「ラグタイムあり、体重補正あり」と名付けたモデルがあり、目的関数値は393.49で、ラグタイムのない私のモデル(393.52)とほぼ同じだった。コードを見ると、S2はこのモデルで tlag という変数を定義しただけで、ラグタイムをモデルに組み込む指定をしていなかった。rxode2の解析解(linCmt())はこの変数を無視する。私がrxode2で確かめると、tlag を定義してもしなくても、計算される濃度は完全に同じだった。S2はこの効いていないパラメータに推定値と標準誤差を報告していた。最終モデルでは正しい指定を使っていたので、最終的な推定値には影響しない。
CL/Fの推定値は4回とも0.132〜0.134 L/hで、私の解析(0.136 L/h)より1〜3%低かった。V/Fは8.02〜8.09 L(2-コンパートメントのN2は容積の和)で、私の解析(7.92 L)より1〜2%高かった。
PK/PDモデル
4回とも、PCAの低下が濃度より遅れることを捉え、turnoverモデルを選んだ。直接作用のモデルと比べたのは3回で、N1は効果コンパートメントのモデルとだけ比べた。
違いは、阻害の曲線の傾き(Hill係数)を推定するかどうかだった。傾きを推定すると、3回で当てはまりが良くなった(目的関数値で7.5〜17.9の改善)。そのうちS2とN2は傾きを推定したモデルを選び(傾き1.20と1.28)、IC50は1.39と1.49 mg/Lで、私の値(1.15)より21〜30%高かった。S1は、傾きを推定するとIC50が定まらないとして1に固定し、その判断が結果を見てからのものだと開示していた。データは傾き1より急な曲線を支持していた。これを受けて、私の解析も傾きを推定する形に改訂した(後述)。
turnoverの速度(kout)は4回とも0.050〜0.055 /hで、私の0.0514 /hと近かった。
問いへの答え
4回とも、被験者を分けた交差検証で答えた(3回は1人ずつ抜く方法、1回は8分割)。抜いた被験者を除いてモデルを推定し直し、その被験者の24時間までの濃度だけで個人のPKを推定し(MAP推定)、24時間以降のPCAで予測誤差を比べた。
答えは4回とも「改善の証拠はない」だった。被験者ごとのRMSEの差は+0.52〜+0.99(PCAの%ポイント、正なら悪化)で、95%区間はいずれも0をまたぎ、改善した被験者は32人中11〜13人だった。ただし、24時間より前の濃度がある13人に限ると、差は+0.17〜+1.02で、95%区間の幅は片側3〜7ポイントと広い(N2は区間を報告していない)。この13人での改善を否定できるほどの精度はない。私の解析(予測誤差の指標は違う)も、改善しないという答えだった。
比べ方には、私の解析との違いもある。エージェントの母集団予測は、本人の基準時のPCAを使っていない(基準時の値はモデルの推定値)。私の解析は基準時の値で正規化した。S2の追加の比較では、基準時のPCAを加えると予測はわずかに良くなった。
私がコードで確かめた範囲では、24時間の区切りは4回とも正しく守られていた。一方で、推定し直しには問題が残っていた。S1の8分割のうち2つでは、PKの推定し直しが初期値(全データの推定値を丸めた値)から動いておらず、抜いた被験者を含むデータの推定値で予測したことになる。S2の1人抜きも、全データの推定値を初期値にしたFOCEiで、推定が動いたかを確かめていない(N2は、同じやり方で32回中26回が初期値で止まることを確かめ、SAEMを併用していた)。結論の向きを変えるほどの影響とは考えにくいが、厳密には交差検証の一部が成立していない。
弱点
採点項目の多くは4回とも満たした。目立ったのは、数値計算の不安定さと、それを確かめる手間である。
- 推定が初期値から動かない。 4回とも、FOCEiの推定が初期値のまま止まる問題に当たった。多点開始、SAEMとの併用、最適化手法の変更で対処した回が多かったが、前節のとおり、見落としもあった。
- 区間の扱い。 共分散行列から求めた区間が狭すぎることを、4回とも指摘した(相対標準誤差0.02〜0.04%など)。S1、S2、N1はブートストラップの区間を主とし、N2は途中のモデルでこれを指摘しつつ、最終モデルでは漸近的な区間を報告した。
- nlmixr2での指定の問題。 S1とN1は、ラグタイムのあるモデルで、被験者の最初の行が投与時刻以前の観測のとき、一部の観測が誤った区画に割り当てられる問題を見つけ、データの並びや解析解への書き直しで回避した。ソフトウェアの不具合か、データの指定の問題かは、切り分けていない。
- 再現できない数字。 S1は、診断用に書いて消したスクリプトの数字を二つ報告に残し、そのことを開示していた。
- 適用範囲の注意書き。 単回投与のPCAの解析であり、INRや投与量の判断には使えないという注意を、S1ははっきり書かなかった。
エージェントが自分で報告した問題(S1の消したスクリプト、S2の移行区画モデルの実装の誤り、N1の推定方法の違い)がある一方で、ラグタイムの指定の誤りや交差検証の推定し直しの失敗は、エージェントのレポートには書かれておらず、コードと出力を読んで初めて分かった。
レポートでは見えなかった再推定の停止
この実験では、エージェントの解析は下書きと別の視点を得る材料になった。一方、モデルの選択と出力の確認には、レポートだけでは済まない作業が残った。
4回のエージェントは、データの点検から交差検証まで一通りの解析を終え、私の解析の簡略化(ラグタイムなし、傾き1の固定)を見直す材料も出した。一方で、モデルの選び方で推定値は2〜3割動き、エージェントのレポートだけでは見つからない誤りもあった。どの選択が目的に合うかを決め、出力を確かめるのは、問いを持つ人である。
実際に、私はこの実験を受けて元のワルファリン解析を見直し、ラグタイムとその個人差を加えた第1.1版に改訂した。PKの目的関数値は約198下がった。見直しの途中で、私自身の第1.0版にも、エージェントで指摘したのと同じ問題があったことが分かった。交差検証とブートストラップのPKの再推定67回のうち20回が、全データの推定値から動いていなかった。第1.1版では、すべての再推定を全データの推定値ではない初期値から始め、動いたかを記録するようにした。続く第1.2版でHill係数を推定すると、傾きは1.28、目的関数値は17.3下がった。エージェントN2の推定(1.28)とほぼ同じである。ただし、未使用の被験者での予測は良くならなかった(RMSE 0.0827、傾き1では0.0807)。当てはまりの改善が予測の改善を意味しない例である。結論の向き(24時間までの濃度で予測は良くならない)は、どの版でも変わらなかった。エージェントの解析の弱点として挙げた点は、人の解析にもそのまま当てはまる。
スキルについては、各2回の比較では効果を判断できなかった。同じ条件の2回の間でも、Hill係数を推定するかどうかで分かれた。今回の課題は母集団PKの推定エンジンを使う課題で、スキルのスクリプトの多くは出番がなかった。ノンコンパートメント解析や生物学的同等性のように、スキルのスクリプトがそのまま使える課題では、違う結果になるかもしれない。
規制の判断に使う解析では、さらに、解析計画の事前の固定、版管理と監査証跡、人による独立した確認、外部のAIサービスに送るデータの扱い、ソフトウェアと環境の管理が必要になる。FDAのAI利用に関するドラフトガイダンス(2025年1月)やEMAの考察文書(2024年)は、使う目的(context of use)とモデルの影響の大きさに応じて信頼性を示すことを求めている (4) (5)。 ICH M15(2026年1月にStep 4)も、モデルに基づく医薬品開発の文書化と評価の原則を定めている (6)。 エージェントが書いた解析も、この枠組みの外にはない。
限界
- 各条件2回で、エージェントの出力は回ごとにばらつく。スキルの効果は推定していない。
- エージェントは一つのモデル系列(Claude)だけで、私自身のアシスタントと同じ系列である。
- 作業フォルダの外を読まないことは指示しただけで、仕組みでは強制していない。warfarinは広く使われる教材のデータで、エージェントが学習した知識を使った可能性がある。
- 採点は盲検化しておらず、基準の解析を作った側が行った。事前の計画にあったエージェントのスクリプトの再実行(全体で数時間)は行っていない。代わりに、レポートの数字が出力ファイルと一致すること、24時間の区切りと主なモデル指定をコードで確かめた。確認の深さには限りがあり、見落としがありうる。
- 4回は同じコンピュータで並行して動いた。N1は、他の回のRのプロセス名が見えたと報告した(中身は読んでいないとしている)。
- 基準とした私の解析(第1.0版)にも最適化の警告があり、エージェントの方が当てはまりの良いモデルを選んだ点もある。改訂後の推定値(第1.2版、体重補正なしのモデル:CL/F 0.134 L/h、V/F 8.03 L、IC50 1.46 mg/L、Hill係数1.28、kout 0.0495 /h)は、図1の基準値とは比べていない。
- 課題は単回投与の公開データ一つで、PK/PD解析の一般的な能力を測ったものではない。
データとコードの公開状況
比較のコードは、4回の作業フォルダから集めた集計の表(agent_tables/、同梱)を読み、results/comparison.csvと図1を作る。エージェントへの指示文と再開の文面(prompts/)、事前に決めた採点項目(analysis-plan.md)、採点の結果(results/rubric.csv)、ラグタイムの指定の確認に使ったコード(check_lincmt_tlag.R)も公開した。エージェントの作業フォルダの残り(個人別の予測値、モデルファイル)は、元データの再配布を避ける方針(私の元の解析と同じ)から公開していない。データは nlmixr2data から取得できる。
参照
- K-Dense. Scientific Agent Skills: pkpd-modeling [source code]. Commit a1043ef, 2026 Oct 12. MIT License. Repository.
- Kassis T, Agarwal V, He Y, Patel D, Brueckner AM. Scientific Agent Skills: A Library of Procedural Knowledge for Research Agents. arXiv [preprint]. 2026;2609.00065. doi:10.48550/arXiv.2609.00065.
- Fidler M, Wang W. nlmixr2data: nonlinear mixed effects models in population PK/PD, data [software]. Version 2.0.10. CRAN. doi:10.32614/CRAN.package.nlmixr2data.
- US Food and Drug Administration. Considerations for the use of artificial intelligence to support regulatory decision-making for drug and biological products. Draft guidance. 2025 Jan. FDA guidance.
- European Medicines Agency. Reflection paper on the use of artificial intelligence in the medicinal product lifecycle. EMA/CHMP/CVMP/83833/2023. 2024. EMA reflection paper.
- International Council for Harmonisation. M15: general principles for model-informed drug development. Step 4, 2026 Jan 29. Guideline.