Nimotuzumabの実測PKによる曝露比較とモデルの複雑さ
On this page
要旨
公開された個人別濃度データから、線形1区画、線形2区画、非線形消失を含む2区画の母集団薬物動態(population pharmacokinetics、PopPK)モデルを推定した。投与条件による曝露の違いを比較するために必要な構造と、推定結果の信頼性を検討する。
今回、複雑なモデルは学習データへの適合を改善した。しかし、被験者を除外した内部検証での改善は小さく、再標本化推定にも収束上の問題が残った。投与条件の順位は一致しても、絶対曝露と用量比は一致しない。したがって、非線形モデルを採用する根拠も、線形モデルで十分と断定する根拠も揃わなかった。この結論に至る計算と、推論を制約する情報の不足を示す。
背景と目的
Nimotuzumabの原研究では、進行乳がん患者のデータに対して半機序的な非線形PKモデルが検討されている (1)。本解析は原論文モデルの完全再現ではない。公開パッケージの配布データを使って、用途に対するモデルの複雑さを比較する二次解析である。
- 解析の問い(question of interest、QOI):50–400 mgの反復投与について、モデル構造を変えると、初回・第10回の曝露と投与条件間の比較がどれだけ変わるか。
- 利用範囲(context of use、COU):公開データを用いた研究・学習上の曝露比較、構造の必要性と追加測定の検討。
- 対象外:治療用量の選択、個人の安全性・有効性予測、EGFR占有率、臨床試験の用量決定。
「同じ順番に並ぶ」と「数値が用途に十分な精度で一致する」は別の判断である。解析計画では、複雑化を支持する条件として、被験者単位の予測RMSEの10%以上の改善に加え、較正と識別性を要求した。簡単な構造で十分とするには、妥当な代替モデルに対して主要曝露・比の差が10%以内であることと、不確実性の評価を要求した。この10%は本研究の事前基準であり、一般的な規制基準ではない。
方法
固定commitのnlmixr2data 2.0.10にあるnimoDataを使った (2)。原本RDAのSHA-256は896d256aee8919061b76358c5e723a786571182f88e5069bf5aa79fc24b82352。RDAからCSVに書き出し、投与と観測を分けて確認した。
表1に配布データの実体と扱いを示す。
表1.配布データの実体と扱い
| Item | Distributed content and handling |
|---|---|
| Subjects | 12; 3 each at 50 / 100 / 200 / 400 mg |
| Events | 441 rows: 120 doses and 321 concentration observations |
| Repeated dosing | 10 doses for everyone; actual TIME used continuously |
| DV | Natural-log concentration; exp(DV) is in µg/mL (equivalent to mg/L) |
| Time, dose, rate | h, mg, mg/h |
| Infusion duration | 0.37–2.91 h from the recorded AMT/RATE; correspondence with the nominal 0.5 h of the original study is unresolved |
| TAD | Inconsistent with the time since the previous dose in 143/321 observations; not used in the ODE |
| BLQ | No dedicated flag; whether unrecorded BLQ values exist cannot be determined |
| Independent information | Not 321 rows but, first of all, 12 people; 3 independent subjects per dose |
対数尺度は公式モデル例のIPRED = log(conc)と整合する (3)。投与行のDV=0を濃度観測に混ぜない。投与間隔は記録上93.0–312.6 hであり、推定時に名目168 hへ丸めていない。
先の原論文の確認では443濃度観測と記録したが、配布実体は321であり、抽出・加工の対応表はない (1, 2)。解析対象は配布された321観測である。元試験の全データを再現したとは書けない。記録RATEを優先して推定し、全点滴を0.5 hへ置き換える場合は別の感度解析として再推定した。
候補モデルと推定
濃度を C = A1 / V1、点滴入力を R_in(t) とする。M1は線形1区画、M2は以下の線形2区画である。
\[ \frac{dA_1}{dt}=R_{\mathrm{in}}(t)-CL\,C-Q\frac{A_1}{V_1}+Q\frac{A_2}{V_2},\qquad \frac{dA_2}{dt}=Q\frac{A_1}{V_1}-Q\frac{A_2}{V_2}. \]
M3はM2の中心区画消失に、次のMichaelis–Menten項を追加する。
\[ \frac{dA_1}{dt}=R_{\mathrm{in}}(t)-CL\,C-Q\frac{A_1}{V_1}+Q\frac{A_2}{V_2} -\frac{V_{\max}C}{K_m+C}. \]
M1ではQと末梢区画を除く。3候補共通でCLとV1に対数正規の個体間変動(interindividual variability、IIV)を置き、共分散を0に固定した。
\[ CL_i=CL_{\mathrm{pop}}\exp(\eta_{CL,i}),\quad V_{1,i}=V_{1,\mathrm{pop}}\exp(\eta_{V,i}),\quad \eta_i\sim N(0,\Omega). \]
残差はlog濃度への加算誤差とした。
\[ y_{ij}=\log\{C_i(t_{ij})+10^{-12}\}+\epsilon_{ij},\qquad \epsilon_{ij}\sim N(0,\sigma^2). \]
M3のKmはEGFR結合親和性や受容体占有率ではない。公式例のTMDDモデルとも異なる。今回の非線形項はPK曲線を表す候補構造であり、生物学的な機序を同定したとは解釈しない。
推定にはR 4.5.1、nlmixr2est 7.1.0、rxode2 5.1.8を使用した。基準の推定では3開始点ずつのSAEM、M2/M3では各3開始点のFOCEi精密化を行った。尤度の積分設定による違いを検出したため、同じデータ尺度で独立した適応Gauss–Hermite求積(25点)によりAICを比較した。15点との差も保存した。診断用の再推定はFOCEi、上限outer 1000 / inner 300、ODE atol 1e-9、rtol 1e-6 とした (4)。
結果
選択した候補解の推定値を次に示す。CL/QはL/h、V1/V2はL、Vmaxはmg/h、Kmはµg/mL。値は指数変換後の自然尺度である。sigmaはlog濃度のSD、omegaはlogパラメータの分散である。
表2に候補モデルの推定値を示す。
表2.候補モデルの推定値
| Model | CL | V1 | Q | V2 | Vmax | Km | sigma | omega_CL | omega_V1 |
|---|---|---|---|---|---|---|---|---|---|
| M1 | 0.008629 | 1.775 | — | — | — | — | 0.7459 | 0.2394 | 0.2786 |
| M2 | 0.003797 | 1.47 | 0.004676 | 60.65 | — | — | 0.7035 | 0.8028 | 0.2611 |
| M3 | 0.001595 | 1.473 | 0.001861 | 8.279 | 2.372 | 396.7 | 0.6932 | 2.133 | 0.2803 |
共通尤度でのAICはM1 790.42、M2 751.25、M3 747.47だった。M3はM2より約3.78低い。しかし、基準推定のM3ではパラメータ相関の絶対値が最大約0.990であり、共分散とoptimizerの警告が残る。AICの順番だけで採用しない。
適合度と新規被験者への予測
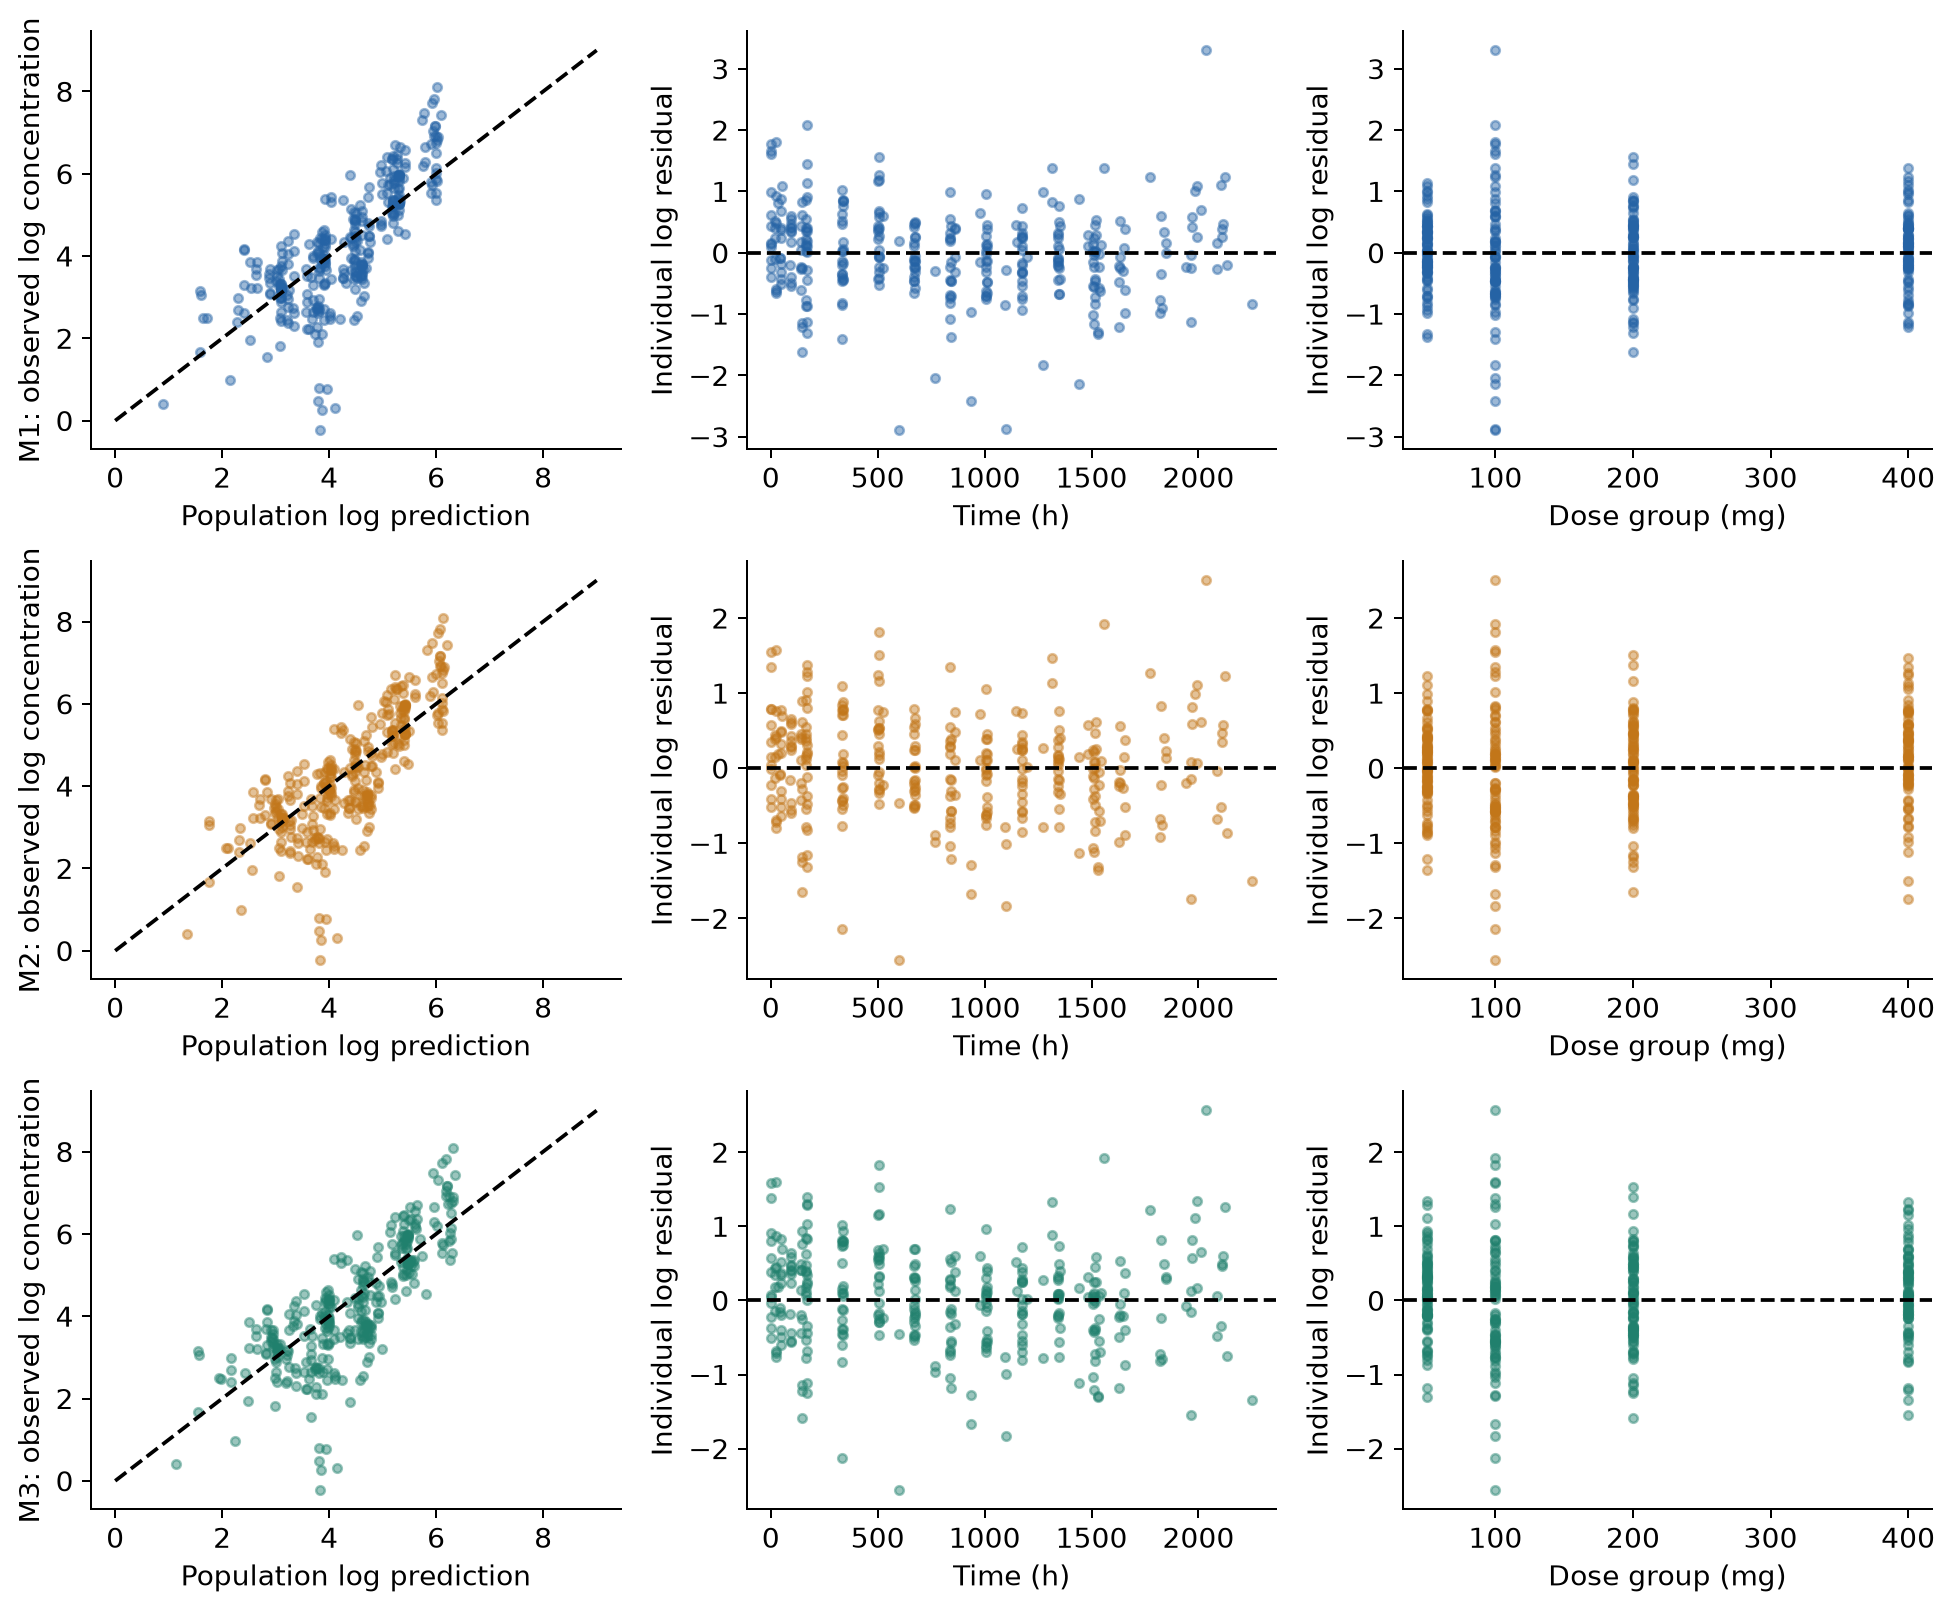
図1. 学習データへのPREDとDV、IRESと時間・用量。対数尺度の図である。IRESは個人効果を推定した後の残差で、学習データへの当てはまりを示す。独立した予測検証ではない。
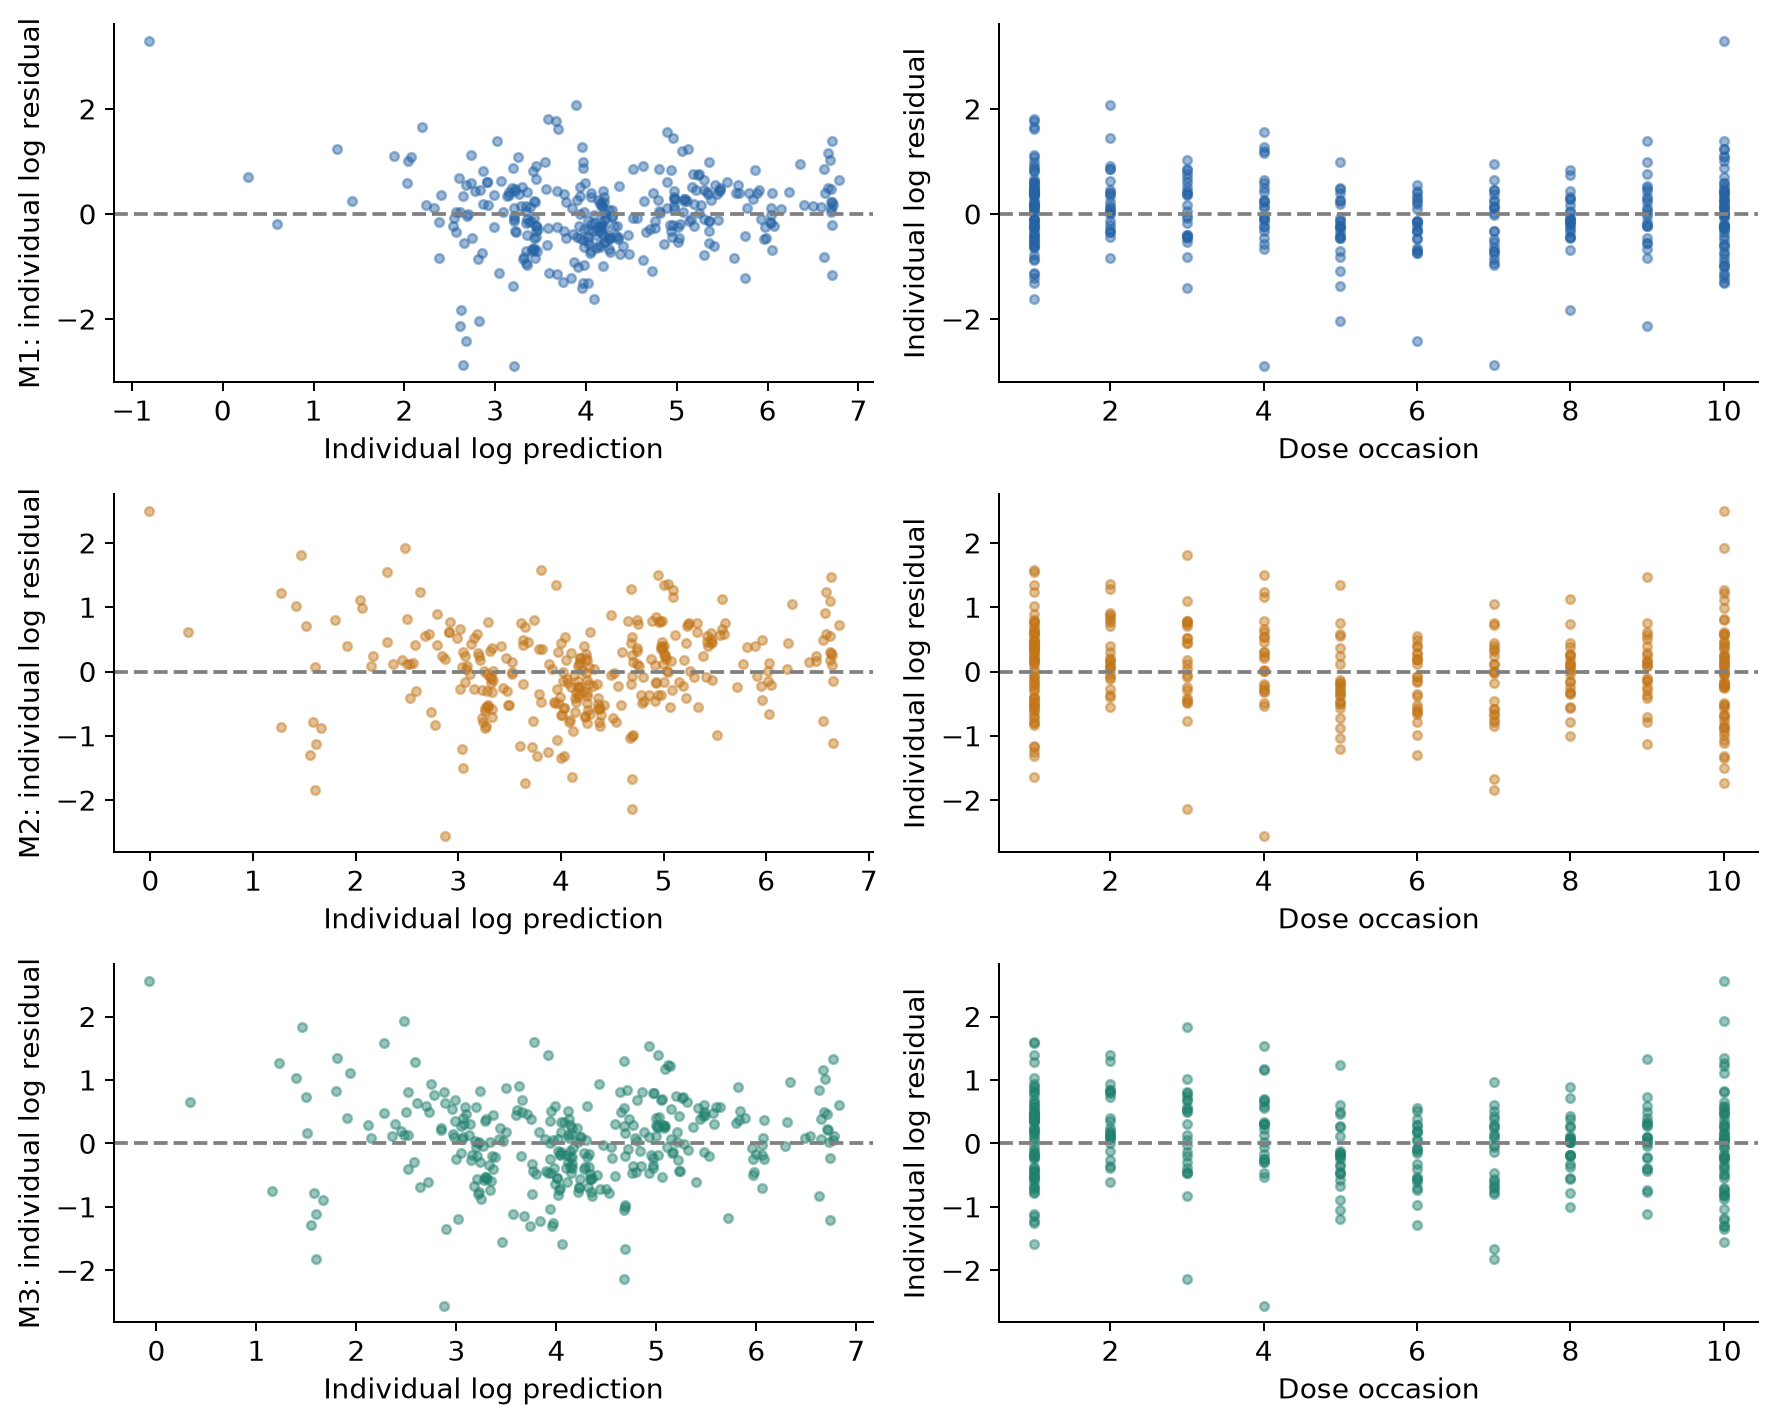
図2. IRESとIPRED、投与occasion。単純な平均残差だけでは、時間や反復投与に依存する偏りを見逃す可能性がある。図1と合わせて確認する。
個人効果が0へ縮む程度も確認した。SDで定義したeta shrinkageは次のとおり(%)。分散で定義した値もCSVに保存した。定義を混ぜない。低いshrinkageでも、モデルの識別性や予測妥当性が保証されるわけではない (5)。
表3に標準偏差尺度の縮小率を示す。
表3.標準偏差尺度の縮小率
| model | parameter | SD_shrinkage |
|---|---|---|
| M1 | eta.cl | 0.3 |
| M1 | eta.v | 4.792 |
| M2 | eta.cl | 5.921 |
| M2 | eta.v | 7.557 |
| M3 | eta.cl | 13.75 |
| M3 | eta.v | 6.2 |
被験者を1人ずつ除外し、残る11人から固定効果・IIV・残差を推定し直した(LOSO、12fold)。除外した被験者のDVから個人効果を推定せず、IIVを積分した周辺予測を評価した。各fold2048回のMonte Carlo近似を使用した。下表は、各被験者で計算したlog濃度RMSE・被覆率・点ごとの対数予測密度を、12人で同じ重みで平均した結果である。予測密度は反復観測全体のjoint densityではない。
表4に被験者を除外した予測性能を示す。
表4.被験者を除外した予測性能
| model | RMSE | RMSE improvement vs M1 (%) | coverage | mean_lpd |
|---|---|---|---|---|
| M1 | 0.9458 | 0 | 0.9186 | -1.386 |
| M2 | 0.9061 | 4.195 | 0.9218 | -1.347 |
| M3 | 0.9147 | 3.288 | 0.9189 | -1.332 |
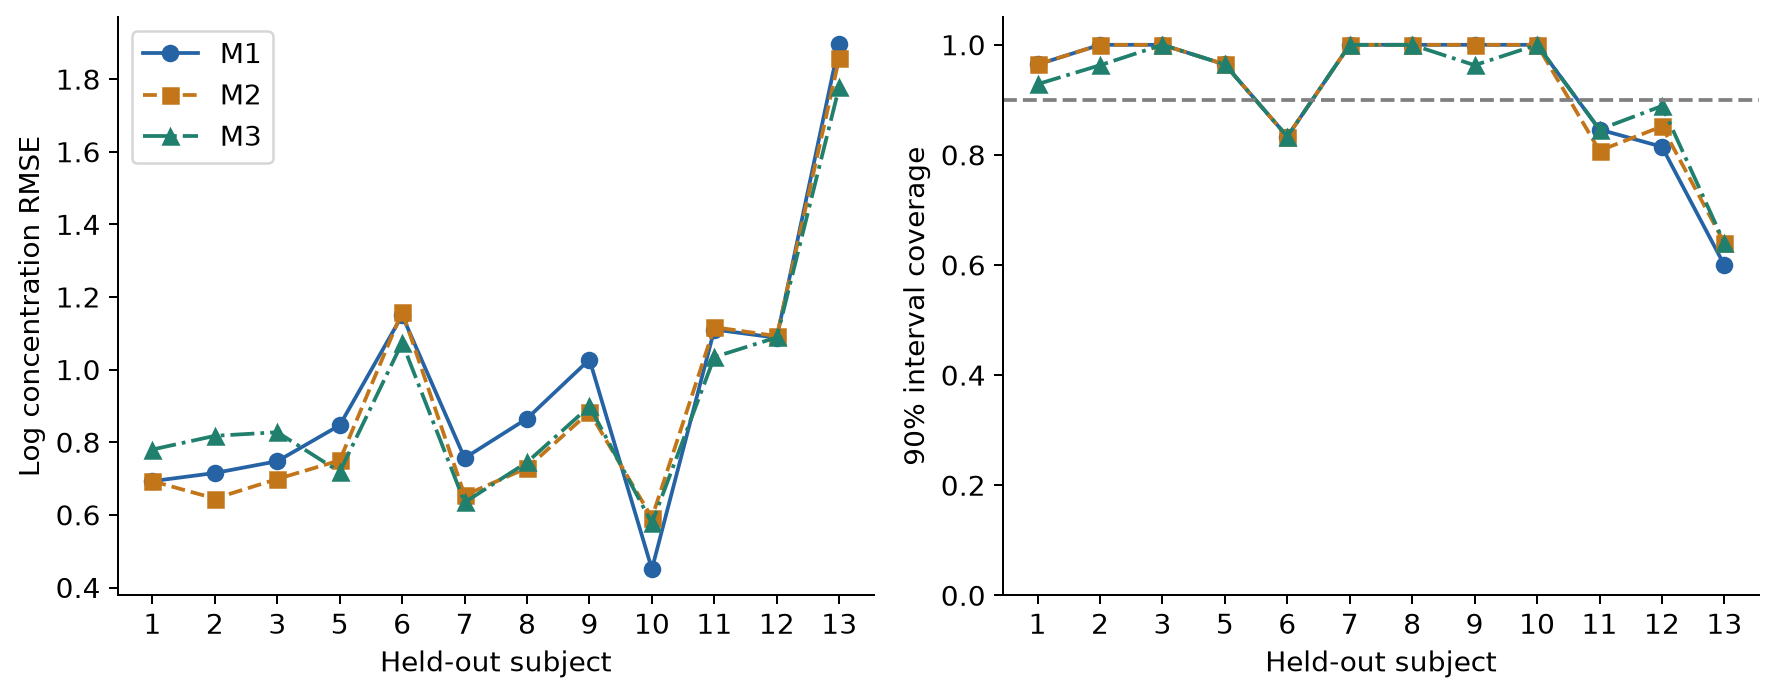
図3. 同じ被験者について、モデルごとのRMSEと90%予測区間の被覆率を比較。点の連結は対応関係を示す。観測数が多い被験者だけを重視しない。
M2/M3の平均改善は10%に届かない。別seedの8192点Sobol積分でも改善はそれぞれ4.10%、3.16%で、この判断は変わらなかった。ただし、この結果を「複雑化は不要」と結論しない。LOSOには収束警告が残っており、下表のとおり、全foldが収束スクリーニングを通過したわけではない。表の指標は全ての有限解による探索的な内部診断である。全体データで選んだ初期値を使うため、モデル選択を含むnested validationではなく、外部検証でもない。
表5に内部検証の収束状況を示す。
表5.内部検証の収束状況
| Model | Folds | Finite | Pass convergence screen |
|---|---|---|---|
| nlminb-M1 | 12 | 12 | 5 |
| M2 | 12 | 12 | 0 |
| M3 | 12 | 12 | 1 |
投与履歴を保ったVPC
視覚的予測チェック(visual predictive check、VPC)では、実際の投与時刻・速度・採血時刻を保持し、モデルごとに1000データセットを生成した。同一被験者の反復観測では同じetaを使い、観測ごとに残差を加えた。初回と第10回を用量別に分け、直前投与からの時間で集計した。時間binは0–2、2–30、30–72、72–168、168–360、360–720 h。記録スケジュールの範囲を覆うように設定し、3観測未満のbinは表示しない。
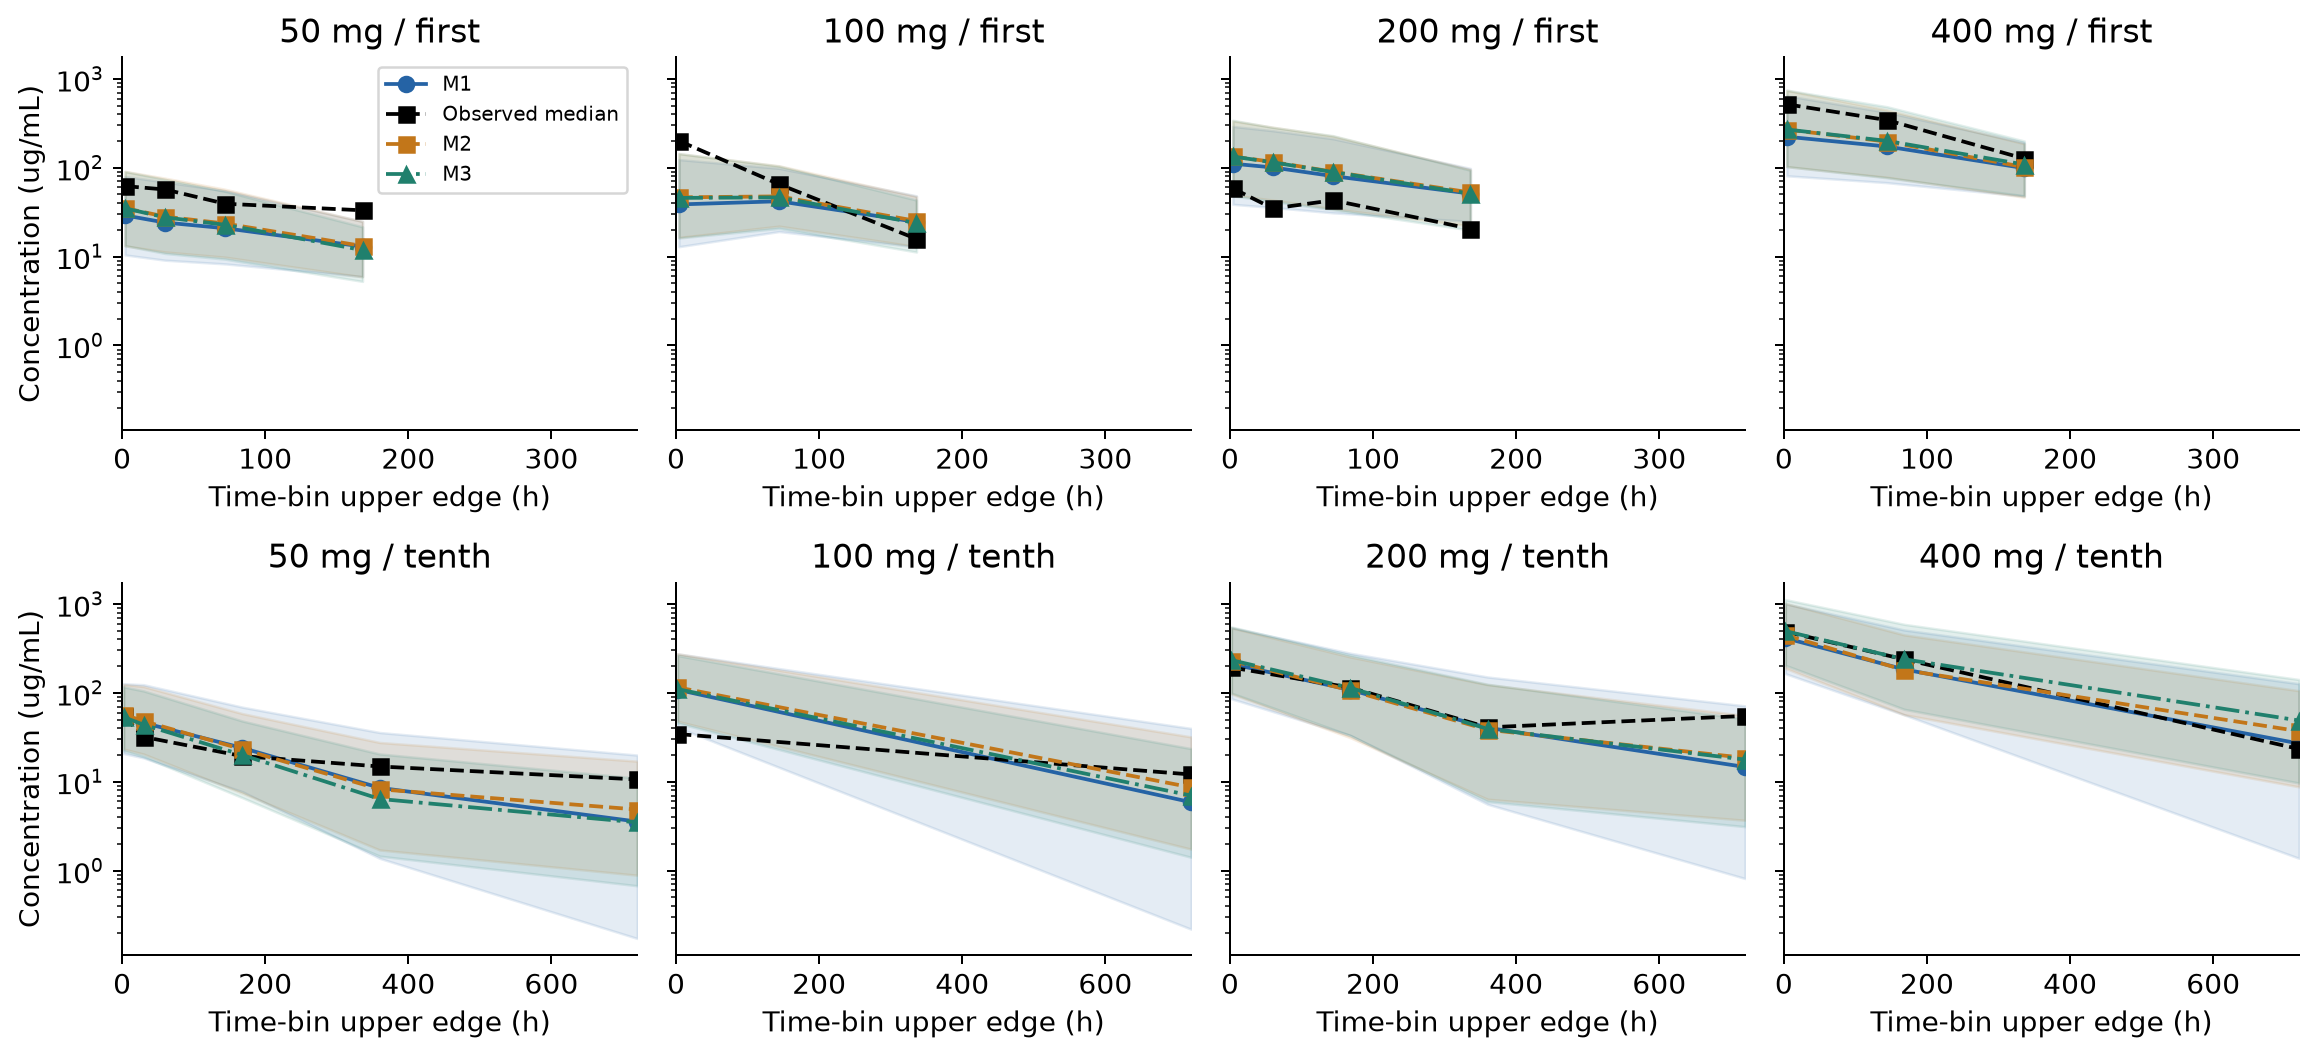
図4. 黒が観測中央値、色線が反復シミュレーションの中央値、帯が各binの中央値の90%シミュレーション区間。縦軸は対数濃度、横軸はbin上端であり採血点そのものではない。完全なVPC出力には10/50/90百分位も保存したが、図は中央値だけを示す。帯は個体間分布の90%区間でも、パラメータの信頼区間でもない。
各用量3人のため、binに複数観測があっても独立被験者は増えない。一部の用量・時期に中央値のずれがあり、広い帯への包含だけで適合を保証しない。今回はdose別の非補正VPCであり、prediction-corrected VPCではない。
再標本化と収束
用量層を保ち、被験者を復元抽出してモデルごとに200回再推定した。観測行をばらばらに再抽出しない。3人しかいない層の経験分布であるため、少数集団の情報不足は残る。M1ではbobyqaに加えてnlminbへoptimizerを変え、さらに200回を実行した。追加試行を元の結果と置き換えず、両方残した。
表6に再標本化の出力と収束判定を示す。
表6.再標本化の出力と収束判定
| group | attempted | finite | qualified | qualified_rate | CI_defensible |
|---|---|---|---|---|---|
| M1 | 200 | 200 | 9 | 0.045 | False |
| M2 | 200 | 200 | 9 | 0.045 | False |
| M3 | 200 | 200 | 11 | 0.055 | False |
| nlminb-M1 | 200 | 200 | 44 | 0.22 | False |
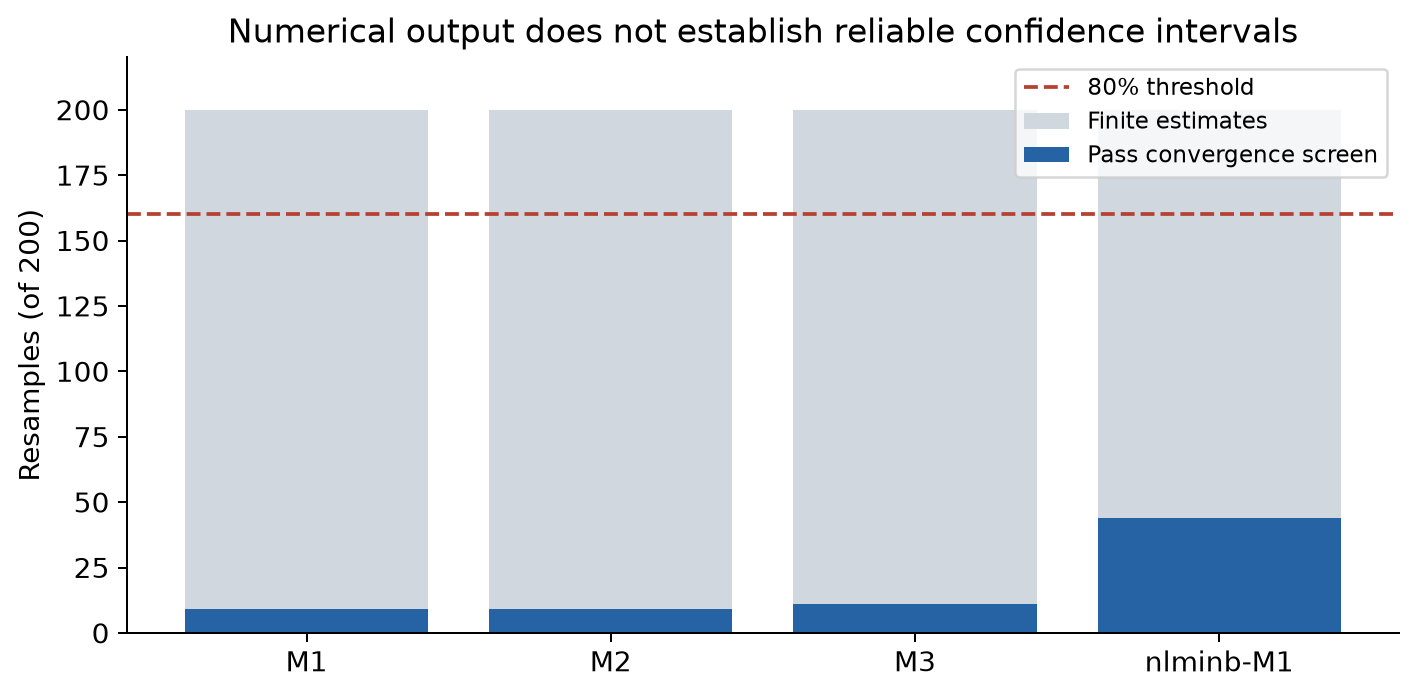
図5. 灰色は有限推定値が得られた数、青色は指定の収束スクリーニングを通過した数。not at minimum、最大反復、failure、convergence関連の記録を全件確認した。通過していてもgradient等の注意記録が残り得るため、通過数を「完全に警告なしの成功数」と解釈しない。
全候補が事前の80%基準に届かない。したがって、このbootstrapによる95%信頼区間は報告しない。成功した少数だけを選んで区間を作ると、失敗するデータ構成を除外した分布になる。有限出力、収束記録、推定値自体は監査用に保存した。
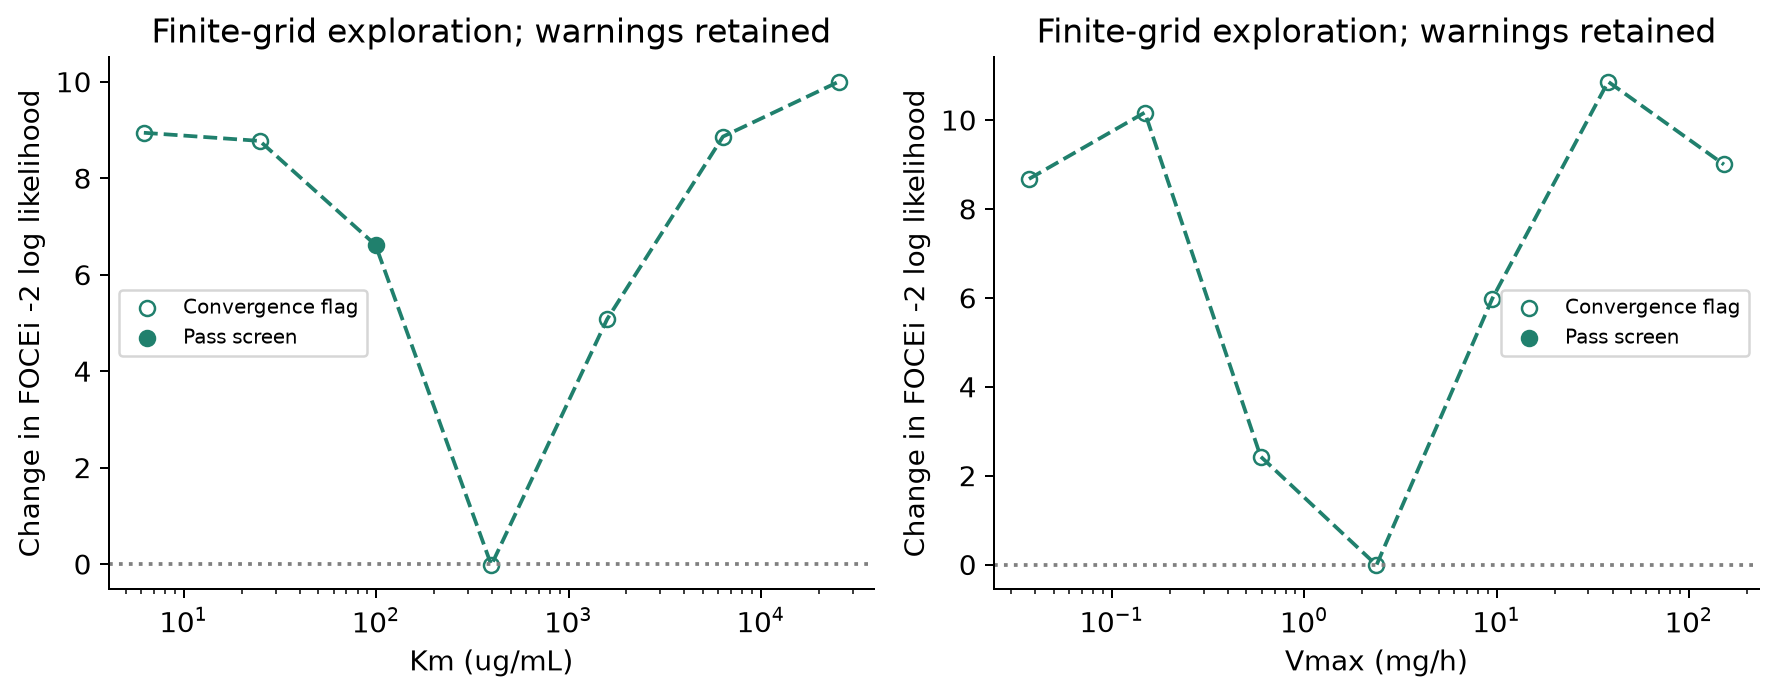
図6. KmまたはVmaxを候補解の1/64〜64倍(7点)に固定して残るパラメータを再推定した。縦軸は診断の基準FOCEi目的関数との差。これは有限グリッドの探索であり、AICに使った独立求積の曲線でも、正式なprofile信頼区間でもない。収束警告付きの点も隠さず白抜きで示す。曲線を滑らかな真のprofileとみなさず、区間の有界性を断定しない。
投与条件の順位と曝露値の違い
推定時には実際の投与履歴を使った。一方、比較シミュレーションでは条件を揃え、50 / 100 / 200 / 400 mg、168 h間隔、0.5 h点滴、10回投与を設定した。固定効果を候補解に固定し、同じ標準正規乱数から各モデルのOmegaに従う10000人を生成した。各モデル内では同一仮想個体へ全条件を与えるpaired比較である。モデル間の同じ乱数は、同一実患者の同じ生物学的個体差を保証しない。
濃度から初回0–168 hと第10回1512–1680 hのAUC、Cmax、Ctrough、Cavgを計算した。第10回を定常状態と呼ばない。Cmaxは点滴終了を含む評価グリッド上の最大値で、AUCは数値積分である。IIVを示す曝露シミュレーションには残差を加えていない。
下表は第10回AUC(µg·h/mL)の10/50/90百分位と、各仮想個体の200 mg条件に対する比の中央値である。「中央値の比」と「個体ごとの比の中央値」を区別する。
表7に第10回投与区間のAUCと用量比を示す。
表7.第10回投与区間のAUCと用量比
| model | amount_mg | p10 | median | p90 | Paired median ratio vs 200 mg |
|---|---|---|---|---|---|
| M1 | 50 | 3102 | 5781 | 1.046e+04 | 0.25 |
| M1 | 100 | 6205 | 1.156e+04 | 2.092e+04 | 0.5 |
| M1 | 200 | 1.241e+04 | 2.312e+04 | 4.184e+04 | 1 |
| M1 | 400 | 2.482e+04 | 4.625e+04 | 8.369e+04 | 2 |
| M2 | 50 | 3107 | 6213 | 9010 | 0.25 |
| M2 | 100 | 6213 | 1.243e+04 | 1.802e+04 | 0.5 |
| M2 | 200 | 1.243e+04 | 2.485e+04 | 3.604e+04 | 1 |
| M2 | 400 | 2.485e+04 | 4.97e+04 | 7.208e+04 | 2 |
| M3 | 50 | 2891 | 5905 | 7086 | 0.2141 |
| M3 | 100 | 5879 | 1.248e+04 | 1.534e+04 | 0.4524 |
| M3 | 200 | 1.212e+04 | 2.758e+04 | 3.563e+04 | 1 |
| M3 | 400 | 2.541e+04 | 6.497e+04 | 9.158e+04 | 2.351 |
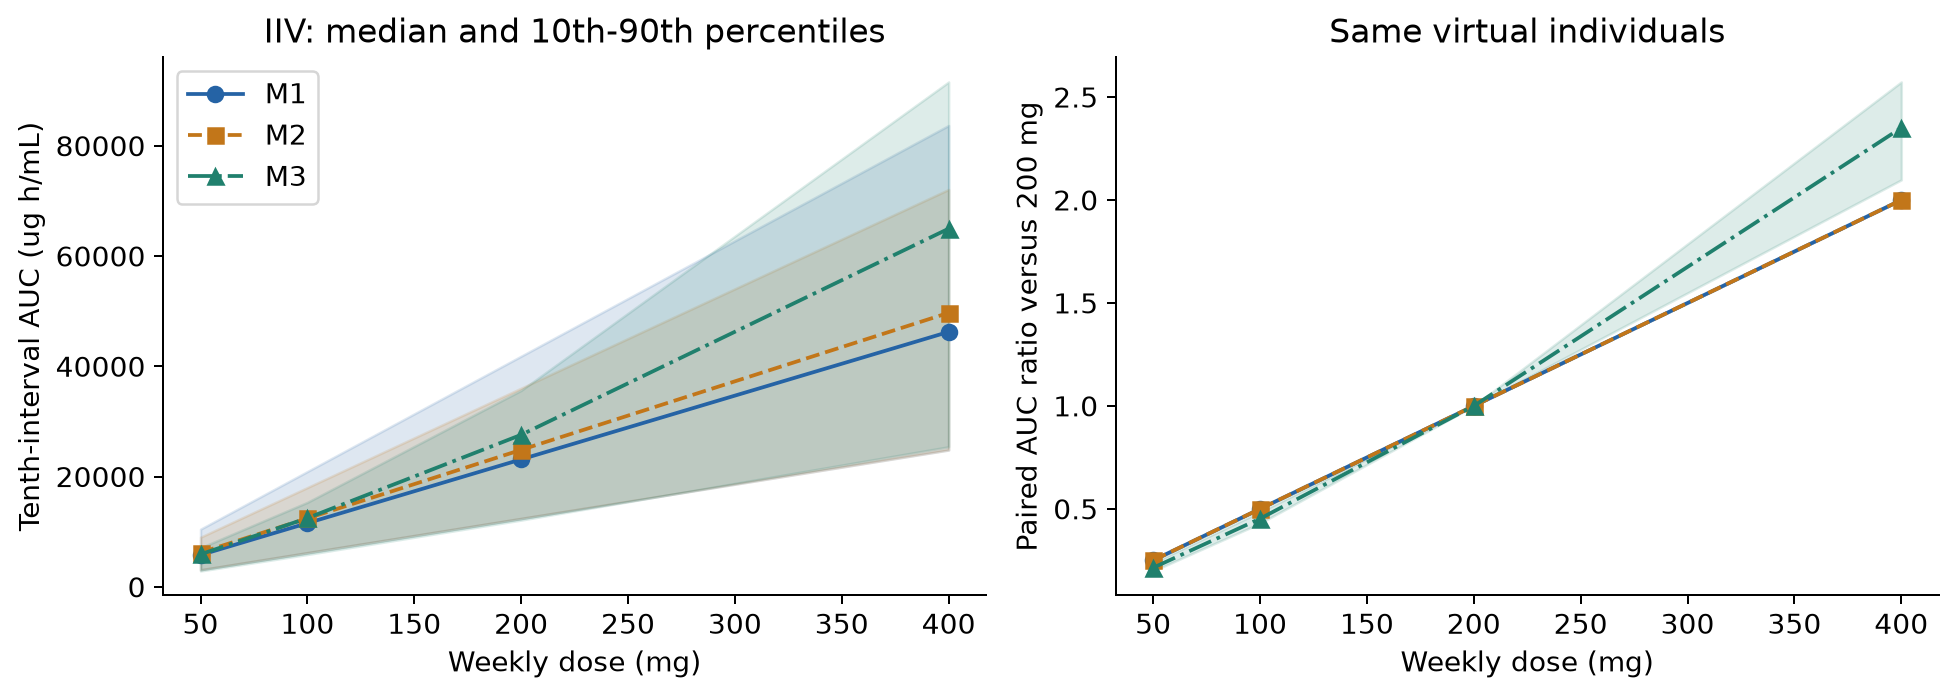
図7. 左はIIVによるAUCの中央値と10–90百分位、右は同一仮想個体内のAUC比。帯はパラメータ推定の信頼区間ではない。
M1/M2では線形性により400 mg対200 mgのAUC比は厳密に2となる。M3のpaired中央値は約2.35となった。この比の差は事前の10%基準を超える。一方、M3は非線形項の識別と再推定の安定性に問題を残す。したがって、「2.35が正しい用量比」とも、「線形の2で十分」とも判断できない。モデル依存性を確認できたことが、ここで支持できる成果である。
200 mgを144 / 168 / 192 h間隔で10回投与する条件も比較した。総投与量は同じだが、総期間が異なるため、AUCだけでなく第10回区間のCavgを比較する。短い間隔で濃度が上がることを、安全性・有効性上の利点と読み替えない。
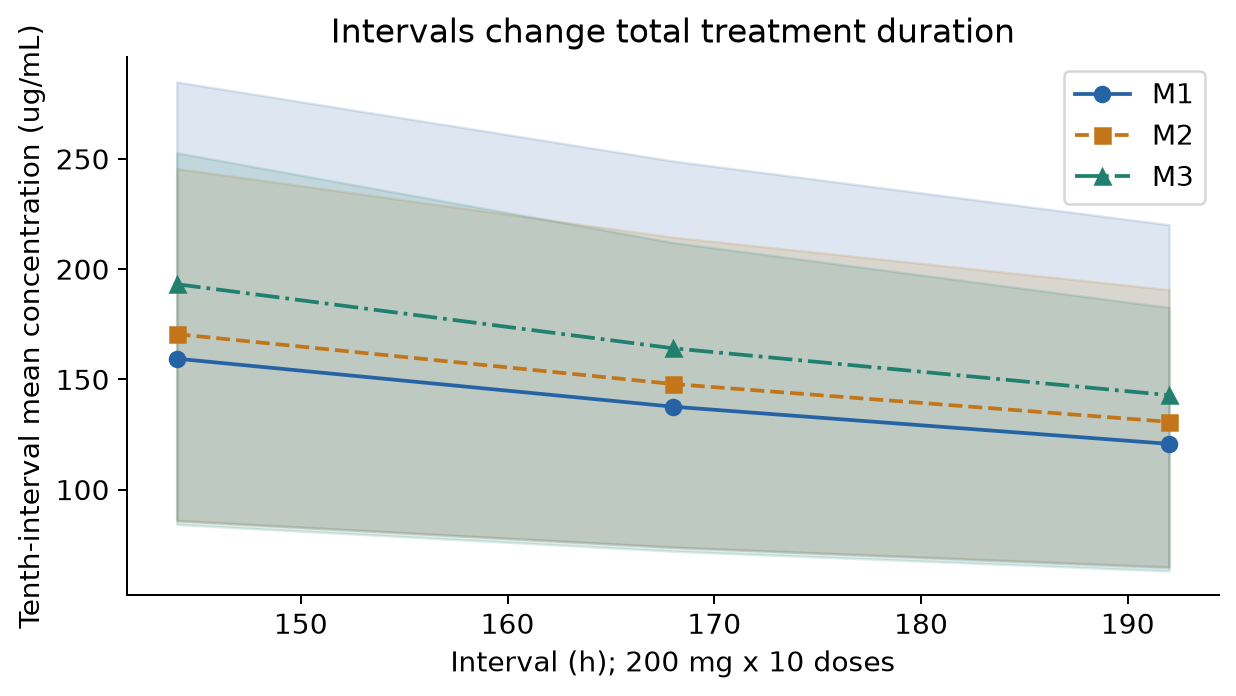
図8. 各候補解のIIVによる中央値と10–90百分位。10回目の区間長自体が条件によって異なる。固定効果の推定不確実性は帯に含まない。
同じパラメータのまま0.5 h点滴を1 hにすると、初回Cmaxのpaired中央値の変化は3モデルとも約−0.1〜−0.2%だった。これは「同じ薬物動態で点滴だけを変更した」比較であり、次の入力履歴感度とは異なる。
入力履歴と体重の仮定を変更するとどうなるか
被験者を除いた再推定解による曝露も調べた。次は第10回の典型個体AUC200 mgと、400/200 mg比の12除外解における範囲である。個体間分布や信頼区間ではない。
表8に被験者除外解による曝露の範囲を示す。
表8.被験者除外解による曝露の範囲
| model | endpoint | minimum | maximum | screen_pass_folds |
|---|---|---|---|---|
| M1 | typical_AUC200 | 2.126e+04 | 2.513e+04 | 5 |
| M1 | typical_ratio400_200 | 2 | 2 | 5 |
| M2 | typical_AUC200 | 2.342e+04 | 2.723e+04 | 0 |
| M2 | typical_ratio400_200 | 2 | 2 | 0 |
| M3 | typical_AUC200 | 2.558e+04 | 3.113e+04 | 1 |
| M3 | typical_ratio400_200 | 2.187 | 2.466 | 1 |
M3の用量比は1人ずつ除外しても約2.19–2.47で、線形の2と異なった。ただし、収束スクリーニングを通過したM3は1/12解だけである。単一被験者だけで変化するかを調べた感度として残し、頑健な集団予測とはしない。Km/Vmaxの除外解も別のCSVに保存した。
全ての記録点滴を0.5 hへ置き換えた再推定、初回体重を使う固定allometry(CL指数0.75、V1指数1、基準70 kg)の再推定を、元の候補と別に保存した。指数は推定していない。次は各再推定解の200 mg週1回・10回・0.5 h点滴における典型個体の第10回AUCである。allometryは70 kgで比較する。
表9に投与履歴・体重の仮定を変えた典型曝露を示す。
表9.投与履歴・体重の仮定を変えた典型曝露
| group | allometry-fixed | baseline | infusion-0.5h | infusion-0.5h / baseline | allometry-fixed / baseline |
|---|---|---|---|---|---|
| M1 | 2.164e+04 | 2.299e+04 | 2.293e+04 | 0.9973 | 0.9412 |
| M2 | 2.406e+04 | 2.483e+04 | 2.499e+04 | 1.007 | 0.9693 |
| M3 | 2.759e+04 | 2.751e+04 | 2.797e+04 | 1.017 | 1.003 |
| nlminb-M1 | 2.159e+04 | 2.317e+04 | 2.28e+04 | 0.9839 | 0.9319 |
各感度再推定にも収束警告が残るため、差を頑健な共変量効果や正しい点滴時間の証明として扱わない。さらに、記録された初回体重を復元抽出した10000人について、体重とIIVを加えた曝露も計算した(allometry-exposure.csv)。これは観測された12人の体重分布に条件付けた感度であり、一般患者集団の分布ではない。未知の患者背景のjoint distributionを合成したとは主張しない。
数値検証で確かめたこと
独立したPython実装(線形モデルは解析的遷移、M3はDOP853)とRの予測を、基準・点滴感度・allometryの9推定解で比較した。最大log予測差は3.3e-06だった。積分グリッド337→673点の変更によるAUCの最大相対差は3.6e-07(32人の同一乱数コホート)だった。M1/M2のpaired用量比が線形理論値と一致すること、LOSOが36被験者fold・963観測評価、曝露表が168行であることも確認した。
これらは実装と数値積分の確認であり、データの由来、推定の収束、モデルの生物学的妥当性を解決する検証ではない。
考察
表10に問いと支持される範囲を示す。
表10.問いと支持される範囲
| Judgment | What is supported here | What is not supported |
|---|---|---|
| PopPK with measured data | Estimated and compared three candidates including between-subject variability | Full reproduction of the whole original study |
| Adding structure | Training fit improves, but prediction improvement is small and instability remains | Confirming adoption of the nonlinear model |
| Sufficiency of the linear model | Usable as a simple reference for comparison | Guaranteeing that dose ratios and absolute exposure are accurate enough |
| Comparing dosing conditions | Exposure and ratio differences within fixed candidate models can be quantified | Optimizing therapeutic doses, predicting clinical risk |
| Uncertainty | IIV, structural differences and re-estimation failures can be distinguished | Reliable 95% CIs from the bootstrap |
結論
複雑な構造の追加は学習データへの適合を改善したが、内部予測と推定の安定性はその採用を十分に支持しなかった。線形モデルで十分だという判断にも、同じ検証上の制約が残る。
点滴・採血時刻の原記録と配布対象の選択・加工履歴は未確認であり、初期分布相と低濃度の末端相の識別にも制約がある。今回の比較では最適採血時刻や必要人数を求めておらず、複雑な構造の追加だけで不確実性が解消するとは言えない。
データとコードの公開状況
解析記録は実行済みa03-diagnostics.ipynbに保存した。配布用には、患者別データなしで動くレビューNotebook、再実行手順、モデル定義・R再推定スクリプト、Pythonの独立予測・診断・シミュレーション、集計CSV、図を準備した。レビューNotebookは保存結果から比較と検算を再実行する。長時間のR推定そのものは別コマンドである。配布用資料に患者別データやRDSは含めず、固定版の取得元と原本hashを記載した。コードの利用条件と、元データの利用権限・原論文の著作権は分けて扱う。
解析資料一式(コード・集計結果・実行済みNotebook)。
参照
- Rodríguez-Vera L, Ramos-Suzarte M, Fernández-Sánchez E, Soriano JL, Peraire Guitart C, Castañeda Hernández G, et al. Semimechanistic model to characterize nonlinear pharmacokinetics of nimotuzumab in patients with advanced breast cancer. J Clin Pharmacol. 2015;55(8):888–898. doi:10.1002/jcph.496. Author-shared manuscript used in the original source audit.
- nlmixr2data developers. nlmixr2data: nimoData [Dataset]. Version 2.0.10. Commit f2cfb01ade88d4d30e66f56b19efce2a2c6e26bd. Pinned source.
- nlmixr2 developers. Nimotuzumab [Internet; model documentation]. Official example. Used for the data scale and the source model; the present M3 is a different model.
- nlmixr2est developers. Control options for FOCEi [Internet; software documentation]. foceiControl reference. The analysis used nlmixr2est 7.1.0.
- Savic RM, Karlsson MO. Importance of shrinkage in empirical Bayes estimates for diagnostics: problems and solutions. AAPS J. 2009;11(3):558–569. doi:10.1208/s12248-009-9133-0. Open full text.