欲しい細胞を増やしたい。LabCompassはどの実験を選んだか
LabCompassの公開注釈済みデータから12培養条件・67ウェルを再集計する。細胞の濃縮とモデル更新の情報獲得、ウェル平均とセル重み付き割合、候補の不確実性と実測のばらつきを分けて実験選択を考える。
On this page
細胞が薬剤やサイトカインにどう反応するかを予測できたとして、次にどの条件を試せばよいのだろう。目的の細胞を多く得る条件と、モデルが苦手な領域を確かめる条件は、必ずしも同じではない。
2026年10月9日公開のプレプリントGenerative inverse design steers human hematopoietic cell fate in vitroは (1)、LabCompassという逆設計の枠組みを使い、ヒトCD34陽性細胞の培養条件を選んでいる。入力はサイトカインや小分子の濃度、酸素濃度、培養期間など。出力は、スペクトルフローサイトメトリーで測る細胞状態の分布だ。RNA-seqだけから細胞の将来を推定する研究ではなく、条件の設計と実際の培養を往復する研究である。
公開された注釈済み測定を使い、最初の新規候補実験で選ばれた12条件・67ウェルを再集計した。目標細胞の濃縮と、次の予測を改善するための情報獲得を分けて見ると、よく働いた条件と、低い割合にとどまった条件の両方に意味がある。ただし、低い結果なら何でも有益だったと解釈してよいわけではない。
順方向の予測を条件の逆設計へ使う
順方向モデルは、培養条件から細胞の分布を予測する。逆設計では、そのモデルが予測する表現型を手掛かりに、目的に合う培養条件を生成する。LabCompassはflow matchingによる条件の生成モデルと、細胞応答の順方向モデルを組み合わせ、学んだ条件の事前分布を利用して候補を探す。(原著のFig. 1とMethods)
目標細胞型\(t\)の割合を増やす目的だけを簡略に書くと、
\[ \max_{x\in\mathcal{X}}\;\widehat p_t(x) \]
となる。\(x\)は培養条件、\(\mathcal{X}\)は許容する条件の範囲、\(\widehat p_t\)は予測割合だ。これは目的の説明であり、原著の学習損失や逆設計ODEを再実装した式ではない。
モデルが正確でない領域に進むと、予測上の最大値が実験でもよい条件とは限らない。そこで、候補の妥当性、実験で扱える濃度、予測の不確実性も選択に入る。原著では予測割合や条件範囲で候補を絞った後、各目標について不確実性の低い1候補と高い2候補を実験へ回している。低い候補は期待する結果を確かめ、高い候補はモデルが十分に知らない領域を調べる役割を持つ。この選択に使う不確実性は、モデルが生成した複数の細胞集団での損失の標準偏差を指す。
既知条件の回収と新しい実験を区別する
最初のLoop 1は、既知の培養条件を隠して評価した段階である。巨核球系を強く誘導する条件210を学習から外し、その近くへ逆設計が到達するかなどを調べた。実際にモデルが選んだ新しい条件を培養で評価するのはLoop 2からだ。(原著のFigs. 3–4)
Loop 2では、巨核球系前駆細胞(MgkPro)、赤血球系前駆細胞(EryPro)、表現型上のHSC(pHSC)、Pre-ProBの4目標に対して3条件ずつを選んでいる。今回の再集計はこの12条件に限定した。各条件の目標と選択時の低・高不確実性は、Author analysis notebookの対応表から読み取った (2)。ただしPre-ProBの条件245は、ノートブックでは高不確実性、原著のLoop 3の説明では低不確実性と記載され、資料間で一致しない。245・246の区分はノートブックに限定して表示し、確定した不確実性順位とは解釈しない。
使ったのはPublic data (3) のloop2_annotated.h5adとloop2p5_annotated.h5ad。加工・注釈・サブサンプリング後のデータであり、生の測定全量ではない。2ファイルには合計999,995セルがあり、対象外の条件247に属する55,555セルを除くと、12条件・67ウェル・944,440セルになる。
両ファイルの実験ID、日付、試料の出所欄は同じで、出所はpooledと記載されている。ファイル名に異なるloopが付いていても、同じ条件の独立した追試を二回行ったとは読めない。また、このメタデータから個々のドナーや人数は復元できない。多くのセルがあっても、それだけ独立した生物学的反復があるわけではない。
12候補は同じようには働かなかった
ウェルごとに、保存された目標細胞の数を、そのウェルの保存セル数で割った。条件ごとの主な集計値は、その割合をウェル間で均等に平均したものだ。注釈は変更していない。
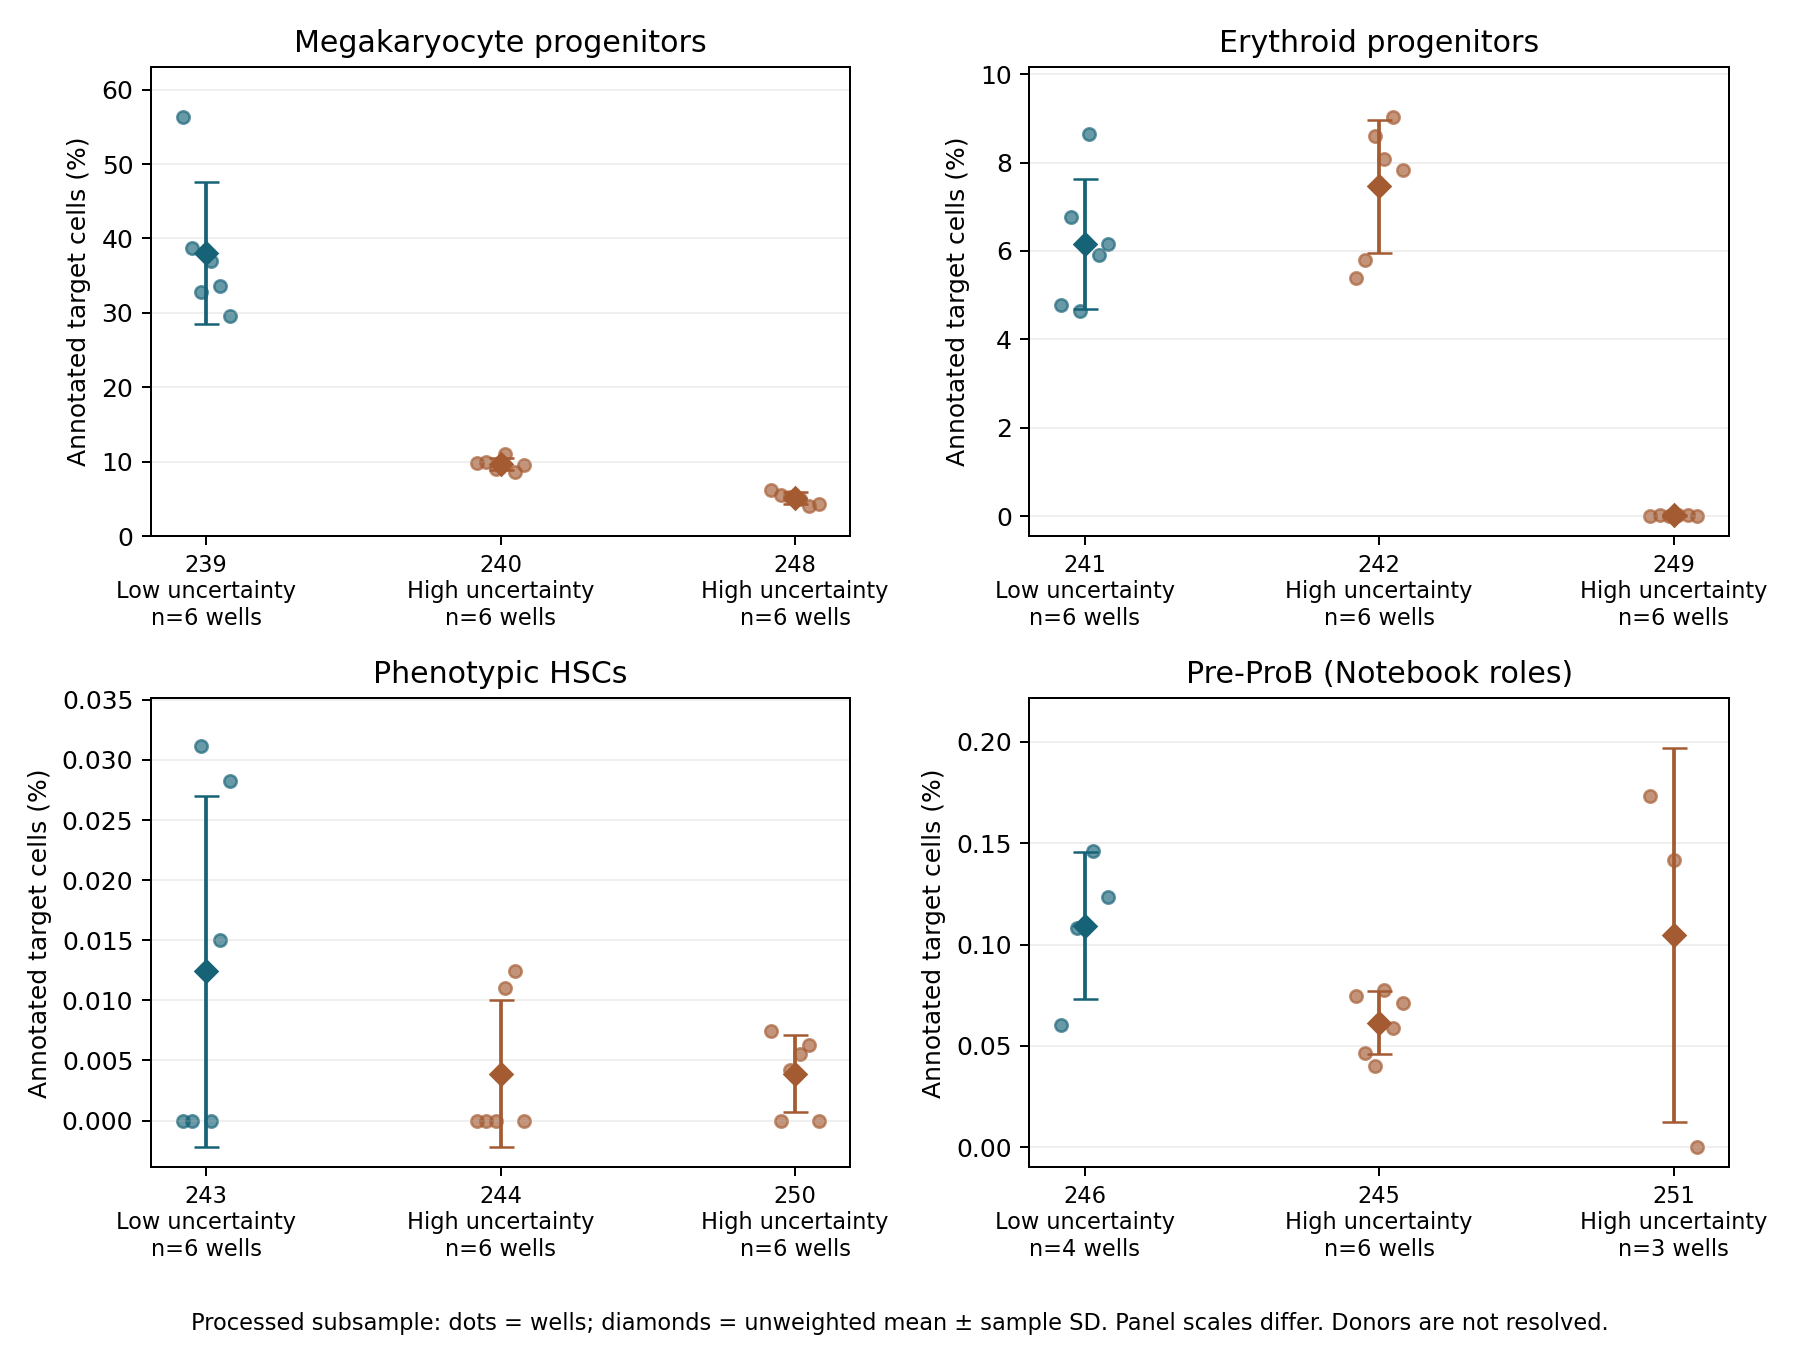
図1.丸はウェルごとの割合、菱形はウェル均等平均、誤差棒は標本標準偏差。目標ごとに縦軸の尺度が違う。低・高不確実性は著者の公開ノートブックの区分で、図の誤差棒とは別物である。Pre-ProBの区分は上記の資料不一致があるため、図中でNotebookと明示した。条件246・251の取得データにはそれぞれ4・3ウェルが残り、他の条件は6ウェル。欠けたウェルを補完していない。誤差棒はドナー間の信頼区間ではない。
表1 Loop 2の目標別候補とウェル均等平均の細胞割合。Pre-ProBの不確実性区分はノートブックによる。
| Target | Low-uncertainty condition / mean fraction | High-uncertainty candidate 1 / mean fraction | High-uncertainty candidate 2 / mean fraction |
|---|---|---|---|
| MgkPro | 239 / 38.0% | 240 / 9.66% | 248 / 5.08% |
| EryPro | 241 / 6.15% | 242 / 7.46% | 249 / 0.0180% |
| pHSC | 243 / 0.0124% | 244 / 0.0039% | 250 / 0.0039% |
| Pre-ProB | 246 / 0.109% | 245 / 0.0614% | 251 / 0.105% |
MgkProでは低不確実性の条件239が高い割合を示す。一方、EryProでは高不確実性の条件242の平均が、低不確実性の条件241より高い。不確実性が低い順と、実測割合が高い順は同じではない。 不確実性は予測についての指標であり、測定後の濃縮割合を並べ直した順位ではない。
pHSCやPre-ProBは、選ばれた条件でも割合が低い。HSCという注釈があることから、機能的な自己複製能を確認したことにはならない。原著も、この段階では目標の濃縮が限定的だったと述べ、後の段階でリンパ系・単球系へ作用する新しい条件を設計空間に加えている。今回のコードは、その後の段階の結果を再集計していない。(Original paper , Loop 3 and Discussion)
ウェルを平均するかセルをまとめるか
条件239では、ウェル均等平均は38.0%、全保存セルをまとめた割合は40.9%だった。ウェルごとに保存されたセル数が違うため、
\[ \overline p_{\mathrm{well}}=\frac{1}{W}\sum_{w=1}^{W}\frac{k_w}{n_w}, \qquad p_{\mathrm{cell}}=\frac{\sum_w k_w}{\sum_w n_w} \]
は一致しない。\(k_w\)は目標セル数、\(n_w\)は保存セル数だ。原著本文のMgkPro約44%と、この取得版・注釈・集計単位による値を同一の再現結果として扱っていない。原著の全量処理と同じ値を再現するには、対象イベントと注釈・集計方法まで揃える必要がある。
ウェルを一つずつ除いた記述的な感度確認では、条件239の平均は34.4〜39.7%となった。特定の一ウェルだけで高い平均が生じたわけではないが、これはドナーを替えたときの範囲ではない。Pre-ProBの条件246と251は、この除外により平均の順序が入れ替わり得る。小さな平均差を確定した優劣として読むべきではない。
濃縮が小さい候補でも更新後に何が変わったか
モデルを学び直す価値は、濃縮割合とは別に評価する必要がある。原著では新しく測った一部の条件を学習へ追加し、条件248と249を残して、更新前後の予測を比較している。その後、全条件を取り込む段階もあるため、どのモデルの比較かを区別する。(Original paper , Loop 2 and Model update between loops)
原著のSupplementary Tables 13–14の報告値を転記し、更新前後の変化を計算した。ここは著者のモデル結果の算術再集計であり、今回独立にモデルを動かした結果ではない。
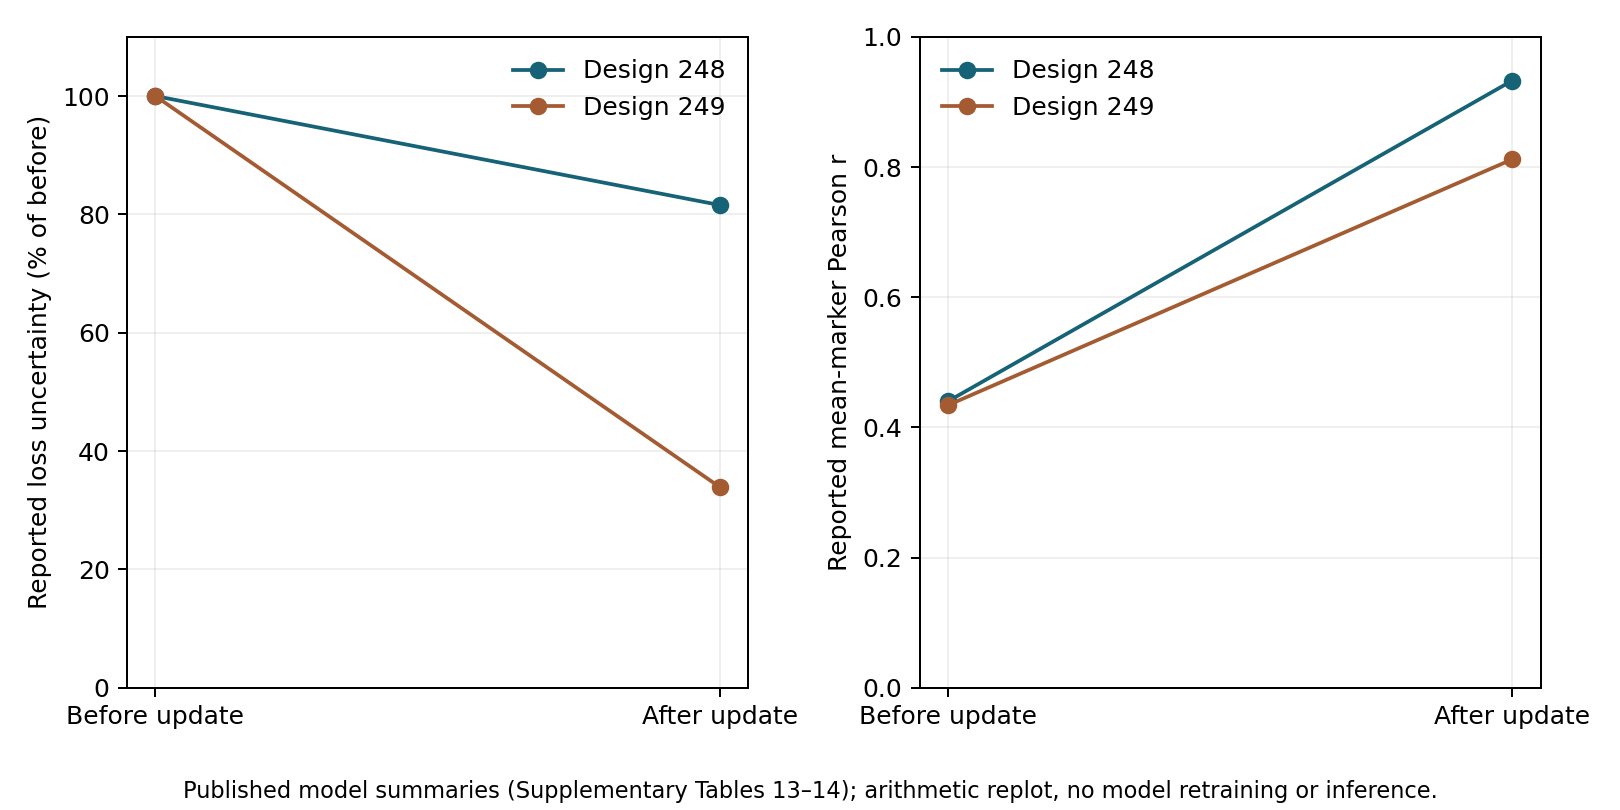
図2.左は損失関数に関する予測不確実性を更新前100%として表示。右は、同じ条件におけるタンパク質マーカー平均の予測と実測のPearson相関。元データは原著のSupplementary Tables 13–14。モデルの再学習・推論は行っていない。
表2 原著が報告したモデル更新前後の指標。追加学習から条件248・249を除いた比較。
| Held-out evaluation condition | Predictive loss uncertainty: before → after | Relative decrease | Marker-mean correlation: before → after |
|---|---|---|---|
| 248 (MgkPro) | 5.97×10⁻⁴ → 4.87×10⁻⁴ | 18.4% | 0.440 → 0.933 |
| 249 (EryPro) | 5.37×10⁻⁵ → 1.82×10⁻⁵ | 66.1% | 0.434 → 0.812 |
ここでの不確実性は、順方向モデルから生成した複数の細胞集団で計算される損失のばらつきだ。実測ウェルの標準偏差や、独立したドナーでの誤差範囲を直接表しているわけではない。数値が小さくなっただけでは、予測が正しくなったとは決まらない。原著が併せて報告したマーカー予測の相関改善は、その評価を補う情報になる。ただし相関だけで絶対量の一致や不確実性の校正まで確認したことにはならない。
今回の実測集計では、条件249のEryPro割合は0.0180%と低かった。条件249自体はこの比較の追加学習に入れず、他の新規条件を使って更新したモデルで、その条件に対するマーカー予測が改善したと報告されている。これは「よく濃縮する条件を見つけた」という成功と、「予測の弱い領域を学んだ」という成功を分ける例である。
一方、この比較だけで高不確実性候補を選ぶ戦略が最適だったとは言えない。ランダムに選んだ条件や、同じ測定予算で別の候補を選ぶ方法との比較が必要だ。低い実測結果を、事後的にすべて情報獲得の成功へ置き換えることもできない。
条件の違いは単独の作用を示さない
MgkProの条件239ではUM171が66.54 nM、butyzamideが110.51 nMだった。条件240ではそれぞれ0、5.03 nMで、GM-CSF、SCF、レチノイン酸、酸素濃度なども変わっている。培養期間は両方14日だ。公開メタデータから抽出した条件表を配布CSVに収録した。
この比較から「UM171を増やせば何%改善する」と推定することはできない。複数の因子が同時に変わり、プレートも揃った対照になっていない。条件全体としての結果と、特定分子の因果効果は別の問いだ。
今回の条件間比較では、同じ試料での因子別の作用も、別のドナーでの再現性も特定できていない。また、目標細胞の割合を上げるだけでなく、得られる絶対細胞数、機能、他の細胞型への影響も必要になる。今回の保存セル数はサンプリング後の数であり、絶対収量の比較には使っていない。
予測の不確実性と濃縮の実測順位は一致しなかった
LabCompassは培養条件を提案し、測定結果をモデルへ戻している。ただ、12候補の再集計では目標ごとの濃縮は一様でなく、予測の不確実性と実測順位も一致しなかった。
目的の細胞を多く得ることと、予測が弱い領域の情報を増やすことは、実験の評価として異なる。候補を生成できたことだけでは、その両方を達成したとは言えない。今回の表は、実際の濃縮や収量と、モデルの不確実性を同じ成功指標として扱えないことを示している。
データとコードの公開状況
再集計コード・入力CSV・図をダウンロード。集計と7件の計算テストはPythonの標準ライブラリで実行できる。図の再描画にはmatplotlibが必要だ。実行方法はREPRODUCE.md、取得版とハッシュはinput-provenance.jsonに記録した。
原著はVersion 1 released October 9で、査読前のプレプリント。測定入力はPublic data under CC BY 4.0のrevision 3c5002d8c9af70ad6b728d999719a26bef3dedfc、対応表はAuthor reproduction repositoryのcommit 0d0ffb093431b2e0a0ff765d0423071aa380c3dcに基づく。元のH5AD、PDF、著者の図・コード・学習済みモデルはZIPに含めていない。図は公開数値から独自に作成した。
本解析は公開資料を見た後の探索的な再集計である。保存注釈の妥当性、全量測定からの処理、生成された個々の候補と選択条件の完全な対応、モデル推論、戦略間の最適性、ドナー間の再現性は検証していない。前臨床の培養条件研究を、臨床的な細胞製造や投与条件の推奨へ置き換えていない。
参照
- Paulas-Condori L, Palma A, Consoli L, Rubio-Lara JA, Hidajat O, Zheng W, et al. Generative inverse design steers human hematopoietic cell fate in vitro. bioRxiv [preprint]. 2026 Oct 9. doi:10.64898/2026.10.07.756550.
- Theis Laboratory. LabCompass-reproducibility [source code and notebooks]. Commit 0d0ffb093431b2e0a0ff765d0423071aa380c3dc. Reproduction repository.
- Theis Laboratory. LabCompass [dataset]. Revision 3c5002d8c9af70ad6b728d999719a26bef3dedfc. Hugging Face. CC BY 4.0. Dataset.