Carbon-Aの5億6,600万の遺伝子候補はどれだけ本物か
Hugging FaceのCarbon-Aが公開した遺伝子予測のファイルを数え直し、5億6,600万という数を、同じ種の重複、確信度とRefSeqとの一致、予測の取りこぼしに分けて確かめる。
On this page
背景と目的
資料の確認日:2026年10月18日。公開された予測ファイルとNCBIのデータだけを使う。
2026年10月8日、Hugging Faceの生物学チームは、DNA配列からタンパク質をコードする領域を予測するモデル Carbon-A(12億パラメータ)と、その予測をGenBankの真核生物のゲノムに当てはめたデータベースを公開した。(1) 発表によれば、48,167のアセンブリ(ゲノム配列の一つの組み立て版)、22,617の分類群で、5億6,600万の「タンパク質をコードする遺伝子座」を予測した。予測はすべて公開されている。
この5億6,600万という数字には、何が入っているのか。公開されたファイルを数え直し、重複(同じ種の別のアセンブリ)と正しさ(確信度、既存の注釈との一致)と取りこぼしに分けてみた。
公開されているもの
発表によれば、Carbon-AはDNA配列(約9万8千塩基の窓)から、各塩基がタンパク質をコードする領域(CDS)である確率を予測する。(1) その確率から、別の後処理で遺伝子の構造(エキソンの並び)を1遺伝子座につき1本作り、確信度を付ける。学習には、NCBIの参照用の注釈であるRefSeqを正解として使った。発表は、42ゲノムでの塩基単位のF1が0.944、確信度で「構造が完全に一致する予測」を見分けるAUROCが0.876だったと報告している。(1) 一方で、翻訳やタンパク質としての存在はまだ示されていないこと、RefSeq側に欠けている遺伝子もありうることも明記している。
データベースは、Hugging Faceの公開ストレージに、アセンブリごとのファイルとして置かれている。(2) 遺伝子の構造(GFF3形式)、CDSとタンパク質の配列、メタデータ(遺伝子数、処理した塩基数、対応するRefSeqのアセンブリ)である。GFFの各遺伝子には、構造が完全か(開始・終止コドンがあり、長さが3の倍数か)と、確信度(0〜1)が付いている。
第三者による評価としては、RohitAIの解説がある。(3) 主張と根拠を丁寧に整理しているが、著者自身が述べているとおり、予測ファイルの解析は行っていない。本記事は、その解析を行う。
方法
- 全体の集計。 公開ストレージのファイル一覧から、遺伝子の予測があるアセンブリをすべて列挙した(34,060)。各アセンブリのメタデータの先頭部分から、遺伝子数と分類(taxid)を読み、NCBIの分類表で種の階級までまとめた (4)。1種1アセンブリは、解析計画どおり最も新しい登録番号のアセンブリを選んだ。選び方による違いも示す。
- 抽出標本。 6つの分類群(菌類、無脊椎動物、植物、原生生物、哺乳類、その他の脊椎動物)から20アセンブリずつ、無作為に選んだ(計120、約158万遺伝子)。GFFから、構造の完全さと確信度を数えた。全体への外挿は、分類群ごとの割合に遺伝子数を掛けて行い、全分類群を同時にリサンプリングするブートストラップ(2,000回)で95%区間を付けた。
- RefSeqとの比較。 配列が同一のRefSeqのアセンブリがある場合に限り、分類群ごとに異なる種を3つずつ無作為に選んだ(計18)。予測した遺伝子ごとに、RefSeqのCDSと同じ鎖で重なるか、エキソンの境界までRefSeqのいずれかの転写産物と一致するか(終止コドンの3塩基の扱いの違いは許す)を判定した。RefSeqは1遺伝子に複数の転写産物を持つが、Carbon-Aは1本しか出さない。また、RefSeqの遺伝子のうち予測と重なるものの割合(回収率)も数えた。
当初の比較では、予測ファイルの大きさが中央値以下のアセンブリから選んでいたが、予測の少ないアセンブリを選びやすくなるとレビューで指摘を受け、選び直した。当初の結果も記録として残した。
数の中身
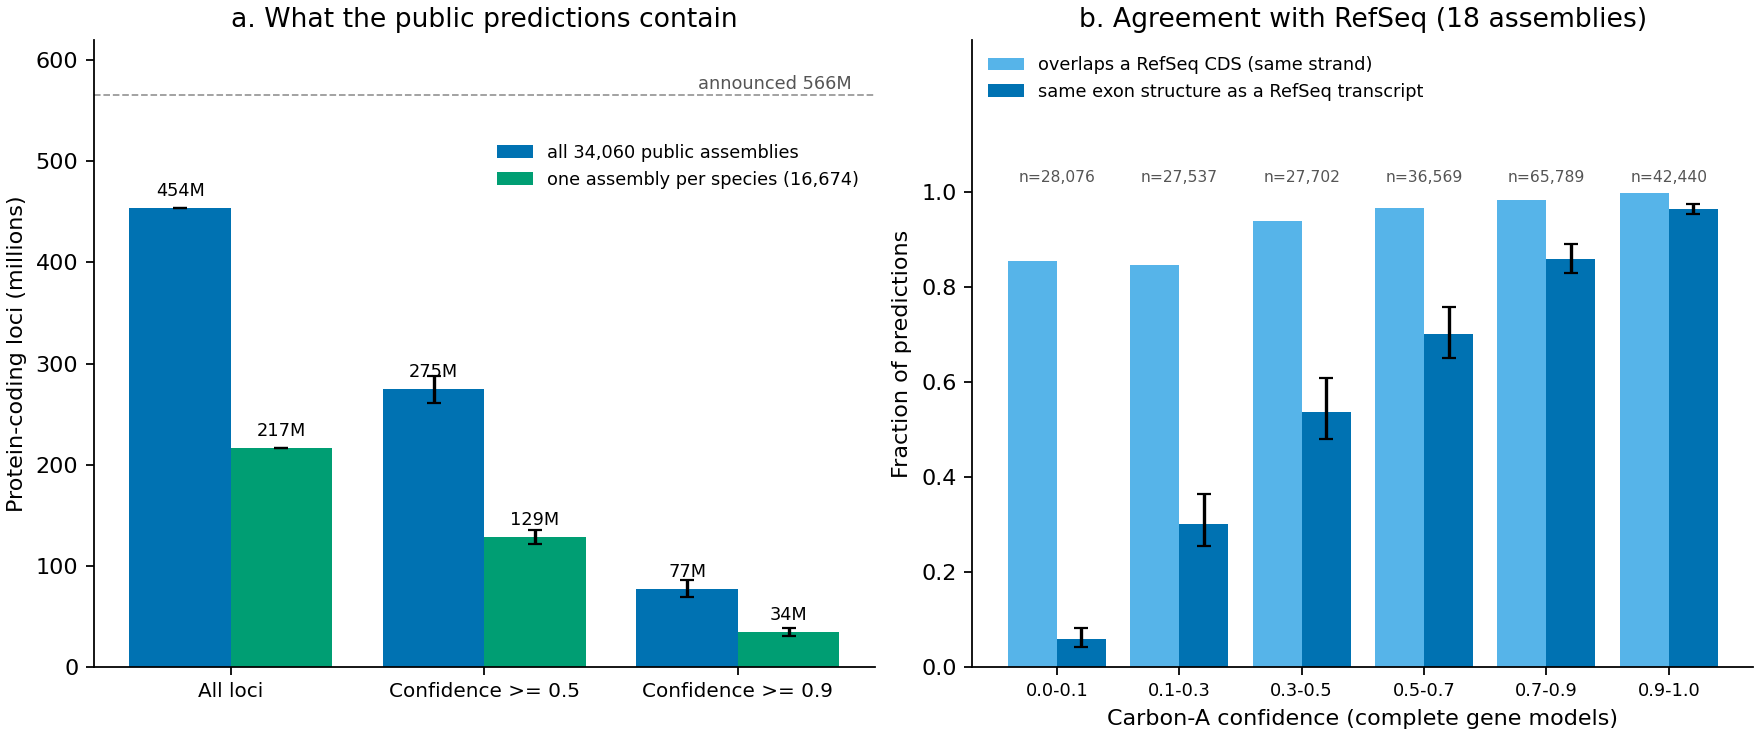
図1. (a) 2026年10月18日に公開されていた予測の遺伝子座の数(百万)。青は全34,060アセンブリ、緑は1種につき最新の1アセンブリ(16,674種)。確信度で絞った値は120アセンブリの標本からの外挿で、誤差棒は95%区間。破線は発表の5億6,600万。(b) 配列が同一のRefSeqアセンブリがある18アセンブリで、構造が完全な予測を確信度で分け、RefSeqのCDSと同じ鎖で重なる割合(薄い青)と、エキソン構造までRefSeqの転写産物と一致する割合(濃い青、誤差棒はアセンブリ単位のブートストラップ95%区間)を示した。nは各区分の予測数。RefSeqは学習に使われた注釈なので、楽観的な値である。
(出力:results/census.json、results/sample_assemblies.csv、results/refseq_agreement.csv)
発表の数字と公開ファイル
公開ファイルは34,060アセンブリ、4億5,379万遺伝子座で、発表の48,167アセンブリ、5億6,600万の、それぞれ71%と80%だった。ファイルは10月6日から18日まで毎日追加されている。発表も、対象のアセンブリの約半分を注釈済みで、次のまとまりを数週間後に出す予定としている。(1) 公開分の分類(taxid)は17,390で、発表の22,617とも異なる。本集計は10月18日の取得一覧に対するものであり、公開時期や一覧取得範囲のどちらが差を生んだかは確定していない。次回追加の予定だけでは、今回取得できなかった分の原因を説明したことにはならない。
同じ種の重複
34,060アセンブリは16,674種にまたがり、5,155種は複数のアセンブリを持つ。最も多いのはヒトで、1,411アセンブリ、合わせて2,644万遺伝子座あった。ヒトのアセンブリ1つあたりの遺伝子数の中央値は19,159で、既知のタンパク質をコードする遺伝子の数(約2万)に近い。ただし、複数の配列のまとまりを含むと思われる大きなアセンブリでは、1アセンブリで最大84,693あった。
1種1アセンブリに絞ると、2億1,672万になった。選び方を変えると、種内の中央値に近いアセンブリで2億1,301万、処理した塩基数が最大のアセンブリで2億2,513万だった。どの選び方でも、全体の約半分は同じ種の別のアセンブリでの予測である。同じ種でも株や個体によって遺伝子の構成は少しずつ違うので、重複分がすべて同じ遺伝子というわけではない。種ごとの遺伝子の数を知りたいなら、足し合わせてはいけない、ということである。
構造の完全さと確信度
標本の120アセンブリでは、遺伝子の96〜100%(分類群ごとの割合)が、開始・終止コドンをそろえた完全な構造だった。後処理が完全な読み枠を作るように組まれているため、完全さだけでは構造の正しさを検証できない。
手がかりになるのは確信度である。確信度0.5以上の割合は分類群によって49〜69%、0.9以上は9〜31%だった。全アセンブリに外挿すると、確信度0.5以上が約2億7,500万(95%区間 2億6,100万〜2億8,800万)、0.9以上が約7,700万(6,900万〜8,600万)である。1種1アセンブリでは、確信度0.5以上が約1億2,900万(1億2,100万〜1億3,600万)、0.9以上が約3,400万だった。ただし、哺乳類の標本20のうち8がヒトのアセンブリで、1種1アセンブリへの当てはめには偏りが残りうる。
既存の注釈とどれだけ一致するか
RefSeqと比べた18アセンブリの結果は次のとおりである(中央値、括弧内は範囲)。
表1.18アセンブリのRefSeqとの一致。
| Measure | Across 18 assemblies |
|---|---|
| Predictions with same-strand RefSeq CDS overlap | 95% (52–100%) |
| Predictions exactly matching a RefSeq transcript's exon structure | 67% (16–93%) |
| RefSeq genes overlapping predictions, recovery | 94% (0.3–100%) |
多くのアセンブリでは、予測の大部分が既知の遺伝子の位置に当たっていた。構造の一致は確信度とよく対応していた(図1b)。確信度0.1未満では一致は6%、0.9以上では96%で、0.5未満をまとめると30%だった。一方、同じ鎖で重なる割合は確信度0.1未満でも86%あった。確信度の低い予測の多くは、遺伝子の位置は合っていて、エキソンの境界が違う予測である。なお、確信度は順位づけの指標で、「この確率で正しい」という意味ではない。
18のうち2つでは、予測が極端に少なかった。緑藻の Monoraphidium neglectum(予測86、RefSeq 16,755)と、海鳥のフルマカモメ(予測1,284、RefSeq 15,106)である。
この比較には大きな注意がある。RefSeqはCarbon-Aの学習の正解であり、比べたアセンブリの注釈そのものが学習に含まれていた可能性が高い。発表の42ゲノムの評価も、RohitAIによれば、技術報告では学習に使ったゲノム28と、時期で分けたゲノム14の組み合わせである。(3) したがって、この一致は「学習した注釈をどれだけ再現するか」に近く、RefSeqのない種での正しさを示すものではない。データベースの大部分は、RefSeqの注釈がない種である。
取りこぼし:予測がないことは遺伝子がないことではない
公開ファイルの34,060アセンブリのうち2,976(8.7%)は、遺伝子の予測が0だった。調べると、少なくとも二つの理由が見えた。
8 kb未満の配列は処理されていない。 標本の120アセンブリでは、処理された配列の最短がどれも8,000塩基以上で、25アセンブリではちょうど8,000塩基だった。メタデータの後処理の設定(最短の配列長 0)とは別の段階で、短い配列が除かれていると考えられる。断片の多いアセンブリでは、ゲノムの一部しか処理されない。標本の118アセンブリのうち33では、処理された塩基がゲノムの90%未満だった。予測0の標本9アセンブリでは、処理された割合は0.1〜40%だった。
特定のアセンブリ群で予測が極端に少ない。 ただし、短い配列だけでは説明できない例もある。予測0の標本の中には、8 kb以上の配列が294 Mb処理されたパーチ(スズキ目の魚)や、104 Mb処理されたコムギの近縁種があった。脊椎動物では、全8,434アセンブリのうち1,429(17%)で予測が3,000未満だった(脊椎動物は通常1万5千〜2万5千のタンパク質をコードする遺伝子を持つ)。配列が同一のRefSeqがあり、予測が1以上3,000未満の22アセンブリのうち20は鳥類で、すべて2014年5〜6月にBGIが登録した、連続した番号のアセンブリ(GCA_000687205〜GCA_000710305)だった。NCBIのコンティグN50(配列の断片の長さの指標)は中央値24 kbで断片化しているが、同じくらい断片化したガラゴ(コンティグN50 27 kb)では、RefSeqの遺伝子の96%を回収していた。断片化だけでなく、このアセンブリ群に固有の処理の問題があると考えられる(原因は分からない)。
比較ゲノミクスや創薬では、「この種にはこの遺伝子(の相同遺伝子)がない」という判断が重要になることがある。Carbon-Aのデータベースでは、予測がないことをそのまま「ない」と読んではいけない。
証拠の段階
5億6,600万という数字を、ここまでの結果で読み直す。
- 公開分の約半分は、同じ種の別のアセンブリでの予測である(重複)。
- 確信度0.5以上は、公開分の約6割(2億7,500万)である。RefSeqのある種では、確信度0.5以上の予測の多くは構造まで一致した。
- 予測がない、または極端に少ないアセンブリがあり、その分は数に入っていない(取りこぼし)。
RefSeqの注釈がない数千の種に、確信度付きの遺伝子の地図ができたことには大きな価値がある。そのうえで、「本物」には段階がある。
- 位置が合っている。 既知の遺伝子と重なる。RefSeqがある種では、多くのアセンブリで9割以上。
- 構造が合っている。 エキソンの境界まで一致する。確信度に強く依存する。
- 転写されている。 発表は、4種のIso-Seq(長鎖のRNA配列)で、完全なCDSの約62%が支持されたと報告している。(1) RefSeqの値(ほぼ同じ)と並べた数字である。
- タンパク質として存在し、働いている。 まだ示されていない。発表も、リボソームプロファイリングや質量分析を今後の課題としている。(1)
使う側の目的によって、必要な段階は違う。ある遺伝子がその種にあることを示すなら1から始められる。タンパク質の配列を使う(構造予測、標的のオルソログの比較)なら2が要り、確信度で絞るべきである。新しい転写産物の候補と、翻訳され機能する新しいタンパク質の主張では、必要な裏付けが異なる。後者には転写に加えて翻訳・機能の証拠が関係する。
考察
Carbon-Aの利用価値は、既存のRefSeqやEnsembl注釈を持たない種でとくに大きい。一方、RefSeqのある種では、確信度0.5未満の予測で構造まで一致した割合は約30%だった。予測があること自体を、遺伝子構造の確定とは扱えない。
種ごとの遺伝子数にも、複数アセンブリの重複と、処理された塩基の範囲が影響する。予測のない領域が、生物学的に遺伝子のない領域とは限らない。発表された規模と、確認日時点で取得できた公開ファイル数にも差が残っていた。
データとコードの公開
計算コードは7本のスクリプト(00_fetch_explorer_taxonomy.py〜06_census.py)からなる。公開ストレージのファイル一覧、メタデータの先頭部分(34,060回の部分取得)、標本120アセンブリと比較18アセンブリのGFF(RefSeqを含め数百MB)、NCBIのアセンブリ情報を取得し、results/と図1を作る。取得には数時間かかる。公開ストレージは更新が続いているため、01をやり直すと一覧と標本が変わる。本記事の時点の一覧(data/cds_assemblies.csv)とメタデータの要約(data/metadata_heads.csv)を同梱したので、それを使えば03以降で同じ標本を再現できる。
python -m pip install -r requirements.txt
python 00_fetch_explorer_taxonomy.py
python 01_list_cds.py
python 02_fetch_metadata_heads.py
python 03_sample_gff.py
python 04_refseq_agreement.py
python 06_census.py
python 05_ncbi_assembly_stats.py
python 06_census.py
限界
- 確信度の割合は120アセンブリの標本からの外挿である。
- RefSeqとの比較は18アセンブリで、学習に使われた注釈との比較である。RefSeqのない種での精度は測っていない。BUSCOのような、RefSeqに頼らない完全性の評価は行っていない。
- 構造の一致は、RefSeqのいずれかの転写産物とのエキソン境界の完全一致で判定した。重なりは同じ鎖で1塩基以上、回収率は遺伝子の範囲(イントロンを含む)の重なりで判定した。
- 1種1アセンブリへの絞り方で数は2億1,301万〜2億2,513万の幅で変わる。
- 鳥類のアセンブリ群で予測が少ない原因は特定していない。
- 公開は進行中であり、数字は確認日のものである。
参照
- Channing G, von Werra L, Gener Team. Carbon-A: Finding genes in known and unknown genomes. Hugging Face Biology Research; 2026 Oct 8. Announcement.
- HuggingFaceBio. GenBank annotations [Prediction database]. Public storage; Carbon Annotation Database Explorer. Snapshot accessed 2026 Oct 18.
- Ramachandran R. Carbon-A's 566 Million Gene Candidates: What the Evidence Supports. RohitAI; 2026 Oct 9. Commentary. Historical commentary cited in the original audit; full text was not newly retrieved for this revision.
- National Center for Biotechnology Information. RefSeq genome annotation, assembly reports and taxonomy [Data resources]. Genome files; NCBI Datasets API. Accessed 2026 Oct 18.