AI創薬の第2相成功率を判断するには何件必要か
AIで見いだされた分子の第2相成功率をめぐる「40%のまま」という主張について、今の件数で差や同等性を判断できるかを二項分布の計算で確かめ、基準値や定義の違いを整理する。
On this page
資料の確認日:2026年10月14日。公表された集計値を入力にした、二項分布の簡単な計算だけを使う。計算結果、文献の報告、本記事の解釈を区別して書く。
2026年10月5日、X上で、AIは薬を良くしているのかを一つの数字で答える投稿が話題になった(@parmitaの投稿)。病気の患者が良くなるかを問う試験(第2相)を通る割合は、AI以前も約40%、AI以後も約40%だという趣旨である。AIで見いだされた分子の臨床試験の成績を集計した2024年の分析は、第2相の成功率を約40%、ただし少数例と報告している (1)。
「AIは第2相の成功率を上げていない」という主張にも、「上げている」という主張にも、同じ問いを向けたい。今あるデータで、その差を見分けられるのかである。
今ある数字とその単位
Jayatungaらの分析は、AIを中心に据えた新興バイオ企業の臨床パイプラインを集計し、第1相の成功率を80〜90%、第2相を約40%と報告した (1)。 著者ら自身が、第2相は少数例に基づくと断っている。本記事では原著の本文で分母を確かめられなかったため、以下では「10件のうち4件」を、少数例で約40%という状況の例として使う。
その後も第2相の結果は出ている。Recursionは2025年5月、脳海綿状血管奇形を対象とするREC-994と、神経線維腫症2型を対象とするREC-2282の開発中止を発表した (2)。 REC-994の第2相は安全性の主要評価項目を達成していたが、長期のデータを踏まえて中止された。REC-2282は低用量の群が無益性の基準を通過したが、他の群は通過しなかった。Insilicoのrentosertibは第2a相を経て、2026年9月に第3相を始めた(第2a相を読んだ記事)。これらを「成功」と数えるかどうかは、定義によって変わる。
比較の基準としては、BIO、Informa、QLS Advisorsが2011〜2020年の臨床開発を集計した報告を使う (3)。 第2相から第3相へ進んだ割合は全体で28.9%(4,933件)、第1相は52.0%(4,414件)だった。この報告を選んだのは、件数が多く、定義(次の段階へ進んだ数を、進んだ数と開発中止の数の和で割る)が公開されているからである。
ただし、二つの点で、AI側の数字と単位がそろっていない。
- 数える単位。 BIOの件数は、薬と適応の組み合わせごとの段階の移行である。AI側の集計は分子ごとである。
- 基準値の幅。 同じBIOの報告でも、第2相の成功率は疾患領域によって15.0%(泌尿器)から48.1%(血液)まで違い、がん領域は24.6%だった (3)。 AIの分子が多い領域によって、比べるべき基準値は変わる。Jayatungaらが「歴史的な業界平均と同程度」とした40%も、別の定義・期間の基準値と考えられる。
「成功」の定義がAI側とBIO側でずれていれば、どちらかが有利に見える。例えば、主要評価項目の達成を成功と数え、その後の開発中止を数えなければ、成功率は高く出やすい。
10件で分かること
4/10の成功率の95%信頼区間(Clopper–Pearson法)は12.2〜73.8%である。28.9%を基準値とした正確な二項検定のp値は0.49だった。
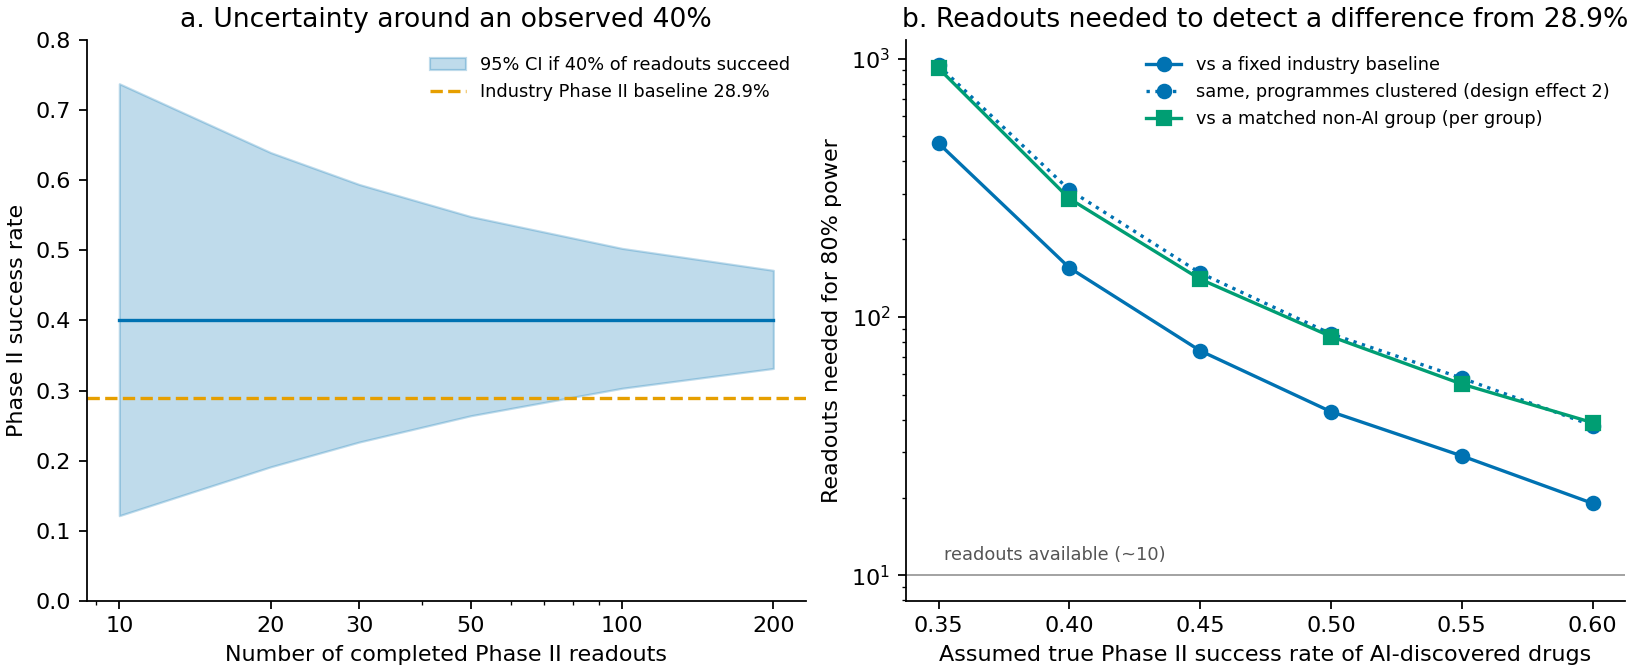
図1. (a) 成功率が40%と観測されたときの95%信頼区間を、第2相の結果の件数ごとに示す(Clopper–Pearson法)。破線は業界の基準値28.9%。(b) AIで見いだされた分子の本当の成功率を仮定したとき、基準値28.9%との差を検出力80%(両側α 0.05)で示すのに必要な件数。青の実線は基準値を既知の固定値とみなした正確な二項検定、点線は企業や標的ごとのまとまりを考えて件数を2倍にした場合、緑は同じ数の非AI群と比べる場合の各群の件数(正規近似)。縦軸は対数。横線は約10件。
10件では、信頼区間の下限は基準値を下回り、上限は70%を超える。「40%だから改善していない」とも、「28.9%より高いから改善した」とも言えない。
逆に、本当に差があったとしても、10件で見つかる見込みは小さい。本当の成功率が50%でも、10件の正確な二項検定で基準値28.9%との差を示せる確率(検出力)は約38%、60%でも約63%にとどまる。
(出力:results/summary.json、results/required_n.csv)
何件あれば判断できるか
差があることを示す
基準値を28.9%に固定し、正確な二項検定で検出力80%を確保するのに必要な件数は次のとおりだった。正確な二項検定の検出力は件数に対してのこぎり状に上下するので、二つの数え方を並べた。「First reaching 80%(初めて80%に届く件数)」と、「Minimum stable count(その件数から先の10件でも80%を下回らない最小の件数)」である。
表1. 仮定した真の成功率と比較方法に応じた必要結果件数。
| True success rate | First reaching 80% | Minimum stable count | Illustrative clustering (2×) | Equal non-AI comparison (per group) |
|---|---|---|---|---|
| 35% | 446 | 470 | 940 | 917 |
| 40% | 136 | 155 | 310 | 287 |
| 45% | 67 | 74 | 148 | 140 |
| 50% | 41 | 43 | 86 | 84 |
| 60% | 19 | 19 | 38 | 39 |
10ポイント程度の改善を確かめるには、少なくとも百件単位の第2相の結果が要る。成功率が倍になるような大きな改善でも、数十件は要る。
列ごとの前提は次のとおりである。
- 固定した基準値と比べるのは、最も楽観的な比べ方である。基準値に不確実性がなく、AIの分子と業界全体が同じ種類の課題に取り組んでいると仮定している。
- Illustrative clustering (2×)の列は、同じ企業や同じ標的から複数の分子が出ている場合の例示である。同じプラットフォーム・資金・判断で進む分子は互いに独立ではなく、独立な情報の量は件数より少なくなる。実際のまとまりの強さは分からないので、ここでは必要件数を2倍にした(1.5倍の場合は結果ファイルに残した)。
- Equal non-AI comparison (per group)の列は、条件をそろえた非AI群と比べる場合であり、、より公平な比べ方である。2026年5月にIQVIAが公表した解説は、AIの関与を確認したプログラムを同じ企業区分・規模の非AI群と比べ、第2相の成功率は同程度だったとしている (4)。 表の数字は比較群とAI群を同数とした場合で、比較群を5倍に取ればAI側は約168件、30倍なら約143件で済む(本当の成功率40%のとき)。
差がないことを示す
冒頭の投稿の主張は、「差がない」の方である。これは、差を示せなかったことからは言えない。差がないことを示すには、事前に「この幅の中なら同等」と決め、その幅に収まることを確かめる必要がある(同等性の検定)。
本当の成功率が基準値と同じ28.9%で、±10ポイントの幅で同等と示すには、検出力80%で約180件(正規近似で176件)が要る。幅を広げれば件数は減るが、そのぶん「同等」の意味は弱くなる。
件数以外の偏り
件数を増やせば解決する問題ばかりではない。
- 「AIで見いだされた」の定義。 標的探索、分子設計、既存候補の最適化など、AIの関わり方は様々である。集計によって、何をAI由来に数えるかが違う。
- 結果が出た順番の偏り。 現時点で第2相を終えたのは、早く進んだ分子である。早く進む分子は、既知の標的や効果の見えやすい適応を選んでいるかもしれない。逆に、早い失敗は早く報告されやすい。どちらに偏るかは事前には分からない。
- 何を成功と呼ぶか。 REC-994の例のように、第2相の主要評価項目を達成したことと、開発が先へ進んだことは同じではない。
- 報告の偏り。 成功は発表され、失敗は静かに開発中止として扱われることがある。公開情報だけから作った分母は、不完全になりうる。
これらは、件数がいくら増えても、比べ方そのものを歪める。
成功率の比較に残る分母の違い
報告された成功率の差には、少数の試験による幅だけでなく、何を1件と数えるかという違いも重なる。同じ会社や同じ技術に属する試験を独立な反復として数えれば、情報量を大きく見積もることになる。
したがって、報告された約40%という成功率は、そのままAIを導入した効果の推定値にはならない。比較対象の選ばれ方と開発段階がそろっていない以上、集計値からAIの寄与だけを切り出すことはできない。
データとコードの公開状況
計算コードは、上の入力値だけからresults/と図1を生成する(約2分)。確認したNumPy・SciPy・Matplotlibの版はrequirements.txtに固定した。
python -m pip install -r requirements.txt
python phase2_numbers.py
- 4/10はJayatungaらの「少数例で約40%」を表す例であり、原著の分母と分子を確認した値ではない。
- 基準値28.9%は2011〜2020年の全疾患の値で、数える単位もAI側と違う。
- 企業ごとのまとまりの影響は、件数を一律に1.5倍・2倍にする例示であり、推定値ではない。
- 非AI群との比較と同等性の件数は、正規近似による。
参照
1. Jayatunga MKP, Ayers M, Bruens L, Jayanth D, Meier C. How successful are AI-discovered drugs in clinical trials? A first analysis and emerging lessons. Drug Discovery Today. 2024;29(6):104009. doi:10.1016/j.drudis.2024.104009.
2. Genetic Engineering & Biotechnology News. Recursion halts four pipeline programs, sharpening cancer, rare disease focus. 2025 May 5. Article. Secondary reporting on the first-quarter 2025 announcement.
3. BIO, Informa Pharma Intelligence, QLS Advisors. Clinical development success rates and contributing factors 2011–2020. 2021. Report.
4. IQVIA. IQVIA Institute’s Global R&D Trends 2026 report finds credible signal on AI-enabled programs. 2026 May. Article.