OncologyBenchでは解析が正しくても判断の採点で落ちる
OncologyBenchの公開例題2件を点検し、証拠の対応関係と追加実験の価値を独自に計算する。解析の正しさを、開発判断へ接続するための条件を示す。
On this page
背景と目的
数値を正しく計算できたら、適切な判断までできるのか。2026年10月13日に公表されたOncologyBenchは、がん領域でこの接続を評価する。解析担当のエージェントが出した結果を、別のエージェントがまとめ、治療や研究開発について結論を出す構成だ。
発表者の集計では、すべての解析課題に合格した試行は57%。最終判断まで含めた全体合格は19%だった。解析課題をすべて通過した試行の約3分の2が、判断の採点で落ちたという。ただし、これは指定された課題・環境・採点基準に対する成績であり、実診療での誤判断率ではない。(1, 2)
この差を「推論力が足りない」で終わらせると、解析者が改善できる部分も見えなくなる。今回は公開例題の構造を点検し、結果を判断へ渡すときに保持すべき情報と、追加実験を選ぶための数理モデルを作った。
評価されるのは解析とその結果を使った判断
本番は25件の評価、計92の解析課題からなる。31通りのモデルと実行環境の組み合わせを各3回評価した、2,325試行の結果が報告されている。2,325件の独立した患者事例を検証したわけではない。
各解析担当は割り当てられたデータを扱う。最終判断担当に渡るのは、解析課題の質問、回答、生成物、実行記録であり、生データそのものではない。全体合格には、必要な解析課題と最終判断の両方の通過が必要だ。この設計は、解析の誤りと、正しい結果を不適切に使う誤りを分けて調べるためのものだ。(2)
判断は文章をルーブリックで採点する。正しい投資先を選んでも、代替案を退ける定量的な説明が不足して不合格となった例が報告されており、不合格が必ず誤った行動の選択を意味するわけではない。報告自身も、単一のLLM採点器、採点基準の文言、再採点時の変動を限界として挙げ、臨床家との一致度の検証を今後の課題としている。オフラインの固定環境で行われた評価から、前向きな臨床的有用性までは判断できない。
公開例題の採点構造と確認方法
10月14日に確認した公開リポジトリには、本番25件とは別の例題2件がある。本稿ではコミット c576d11144db9a5b2f8461d469e24ac05af2386a に固定し、JSONをデータとして読み、採点ノードを集計した。元の採点プログラムは実行していない。(3)
表1.固定コミットにある公開例題2件の採点ノード数。
| Public example | Analytical sections | Numeric-tolerance nodes | Numeric-range nodes | Predicate nodes | Positive/negative Decision-rubric criteria |
|---|---|---|---|---|---|
| Integration of postoperative molecular information and records | 5 | 4 | 0 | 10 | 6/5 |
| TGFβ–PD-L1 development decision | 4 | 9 | 2 | 6 | 7/4 |
これは採点構造の記述であり、独立した必須問題の数ではない。2件目には複数の定義を許容する枝もあり、すべての末端ノードを同時に満たす必要がある、と数えてはいけない。本番全体の難易度や合格率も、この2件からは推定できない。
開発判断の例題は、ヒトの単剤試験、マウスの空間指標、腫瘍増殖と細胞除去、標的への作用を示す測定を統合する。抗体の種類が記録されている実験と、記録されていない実験が混在する。(4)
ここで必要なのは、測定値の大小だけではない。どの系で、どの介入を、何と比較し、何を測ったかを保ったまま統合することである。
表2.証拠を統合するときに保持する条件。
| Context attached to a result | Distinction during integration |
|---|---|
| Human single-arm monotherapy study | Distinguish it from a comparative combination-treatment trial |
| Mouse spatial measurement | Its measured endpoint differs from a human clinical outcome |
| Experiment using a vehicle comparator | It does not measure added benefit over monotherapy |
| Experiment without recorded antibody identity | Do not assign the result to a specific antibody |
| Record without a documented finding | Distinguish unrecorded status from confirmed absence |
これらの違いは、結果を捨てる理由ではない。どの主張を直接支持でき、どの接続に追加の仮定やデータが必要かを示す情報になる。直接の臨床効果がまだ証明されていなくても、試験を行う価値はあり得る。
7つの例で証拠の対応関係を点検する
この区別を小さなコードにした。独自に作った7件のメタデータ例について、系・介入・比較対象・測定項目・記録状態を、使おうとする主張と照合する。完全な文字列一致なら「対応」、値が異なれば「不一致」、必要な情報が未記録なら「未解決」とする。未記録を未記録のまま述べる場合は対応と扱う。
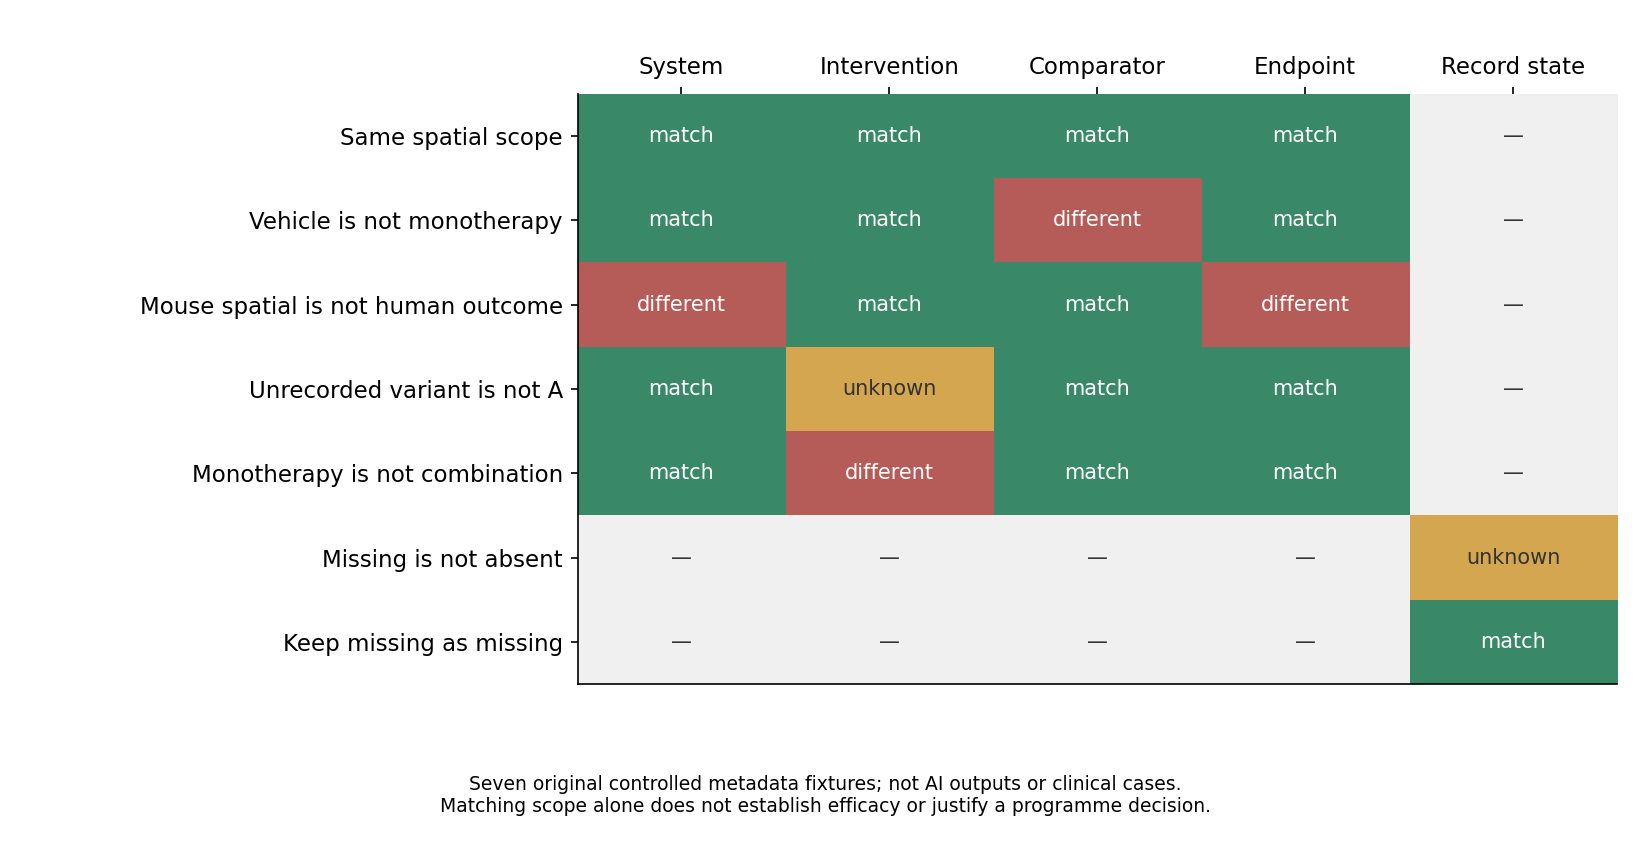
図1.独自に作成した7件の証拠と主張の対応関係。 灰色の「—」は、主張が照合を求めていない項目を表す。結果は対応2件、不一致3件、未解決2件だった。これは意図的に作った例の動作確認であり、AIの正答率ではない。マウスの空間指標をヒトの臨床結果として使う例や、対照群を取り違える例を検出できる。一方、名称の同義性や実験品質、因果関係は、この単純な照合では評価できない。「対応」は有効性や開発継続の根拠が十分だという意味でもない。
数値だけを集約するより、各結果に比較対象と欠測状態を添える方が、判断担当が必要とする情報を残せる。オミクスや空間解析でも、結果表の1行が何を比較したものなのかを追える形にしておきたい。
追加情報の価値は仮定した効用で変わる
対応関係を保持しても、「今進む」「追加実験をする」「中止する」の選択は残る。ここでは開発プロジェクトの仮想例を置く。患者への治療選択や投与量のモデルではない。
最終的なプロジェクト成功の確率を \(q\) とする。今進んで成功すれば利得100、失敗すれば損失40、中止すれば0。すべて任意単位であり、実際の費用や健康アウトカムから推定した値ではない。リスク中立の期待効用は、
\[ U_{\mathrm{進む}}=100q-40(1-q)=140q-40, \qquad U_{\mathrm{中止}}=0 \]
となる。ここでの \(q\) はベンチマーク合格率でも、患者の奏効率でもない。実際には、判断対象に合った確率の推定と校正が必要になる。
追加実験の費用を5、感度を0.8、特異度を0.9と仮定する。この感度・特異度は、将来のプロジェクト成功/失敗という二つの状態に対して定義した仮想の実験性能であり、実在のアッセイ性能ではない。結果を見た後に、進むか中止するかをそれぞれ選び直す。
陽性結果と成功・失敗の同時確率から計算した効用への寄与は \(84q-4\)、陰性結果の寄与は \(56q-36\)。それぞれ、進む効用が負なら中止するため、
\[ U_{\mathrm{追加実験}} =\max(84q-4,0)+\max(56q-36,0)-5 \]
となる。陽性なら必ず進む、陰性なら必ず中止する、とは固定していない。
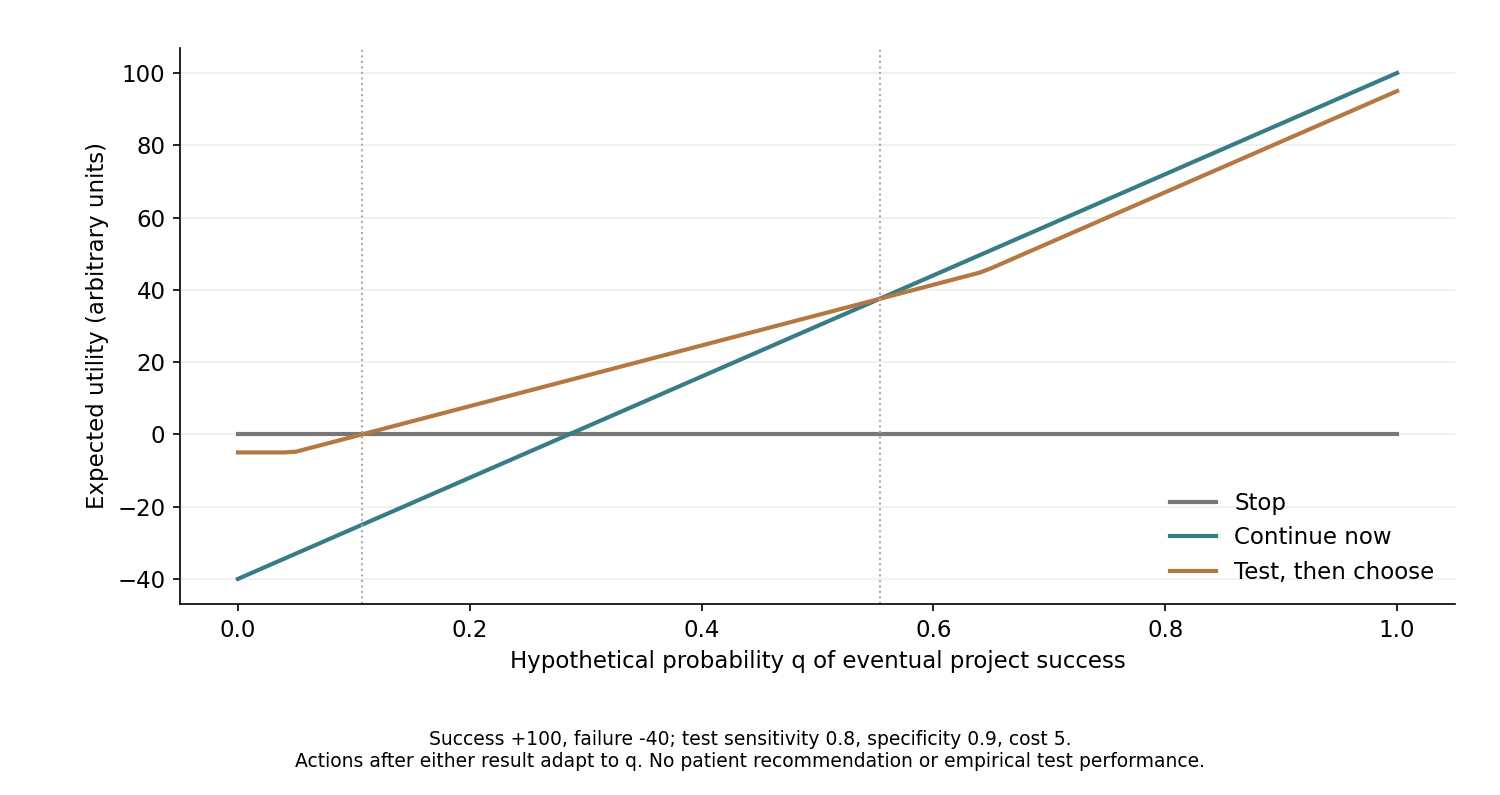
図2.仮定した成功確率と3行動の期待効用。 実データから推定した成功確率ではない。
表3.仮想の成功確率に対する期待効用。値は任意単位。
| Assumed \(q\) | Stop | Continue now | Experiment and decide again | Action with maximum expected utility |
|---|---|---|---|---|
| 0.2 | 0 | −12 | 7.8 | Experiment |
| 0.4 | 0 | 16 | 24.6 | Experiment |
| 0.8 | 0 | 72 | 67 | Continue now |
\(q=0.2\) では、そのまま進む期待効用は負だが、実験後に選び直す価値が費用を上回る。\(q=0.4\) では、進む判断が既に正の期待効用を持っていても、追加実験の方が大きい。
\(q=0.8\) では、陰性の後にも進む方が有利になる。この仮定の下では、実験結果が行動を変えず、情報の期待価値は0となり、費用5だけを失う。情報が増えることと、意思決定が改善することは同じではない。
基本設定で最良の行動が切り替わる境界は、\(q=9/84\approx0.107\) と \(q=31/56\approx0.554\)。それぞれの境界では2行動が同点になる。この閾値は仮定した利得、損失、実験性能、費用に依存する。普遍的な開発基準として使える値ではない。
費用を0・5・20、感度と特異度を3組に変え、101点の \(q\) に対する909行の感度分析も出力した。例えば同じ \(q=0.4\) と実験性能でも、費用を20に上げると追加実験の期待効用は9.6となり、今進む16を下回る。確率と実験性能を既知とする二状態のモデルなので、推定誤差、試験の遅延、複数候補への資源配分、リスク回避は扱っていない。
考察
OncologyBenchの成績は、解析を通過した結果にも、最終判断で別の失敗が起こり得ることを示している。ただし、ルーブリック合格は期待効用の最大化を検証したものではない。本稿の数理例も、公開ベンチマークの再評価ではない。
解析から判断へつなぐには、少なくとも三つの接続を明示したい。結果がどの介入・比較対象・測定項目に対応するか。その結果が、判断したい将来の状態について何を更新するか。そして、誤って進む損失、見送る機会損失、追加実験の費用をどう比較するかである。
同じ解析値でも、比較対象や未記録の条件、外挿の仮定が違えば支持できる主張は変わる。さらに追加実験の価値は、実験結果が行動を変えるかに依存する。本稿の例では、証拠の対応関係と意思決定上の価値を別々に確認する必要があった。
データとコードの公開
解析コード・7件の独自例・結果表・図をダウンロード。Python 3.12、NumPy 1.26.4、Matplotlib 3.9.1で確認した。analysis.py、13件の単体テスト、plot.pyを順に実行する。通常の再実行はネットワークを使わない。
公開例題の構造集計は、出典URLとSHA-256を添えた集計JSONから再実行できる。原本との照合が必要な場合だけ、audit_sources.py --fetch で固定コミットの2件を取得する。原本の課題文、解答キー、第三者の図や患者データは配布物に含めていない。実際のLLM実行も行っていない。
参照
- LatchBio. OncologyBench: Benchmarking AI Decisions in Cancer Research and Treatment. 2026 Oct 13. Blog post.
- Badshah J, Saye BK, Banerjee A, Shrishrimal S, Ramasamy R, Flood D, et al. OncologyBench: Benchmarking multiagent AI systems on grounded systems in oncology research and treatment. LatchBio; 2026. Technical report.
- LatchBio. oncologybench [Software repository]. Commit c576d11144db9a5b2f8461d469e24ac05af2386a. GitHub. Accessed 2026 Oct 14.
- LatchBio. TGFβ–PD-L1 programme review [Benchmark example]. In: oncologybench. Commit c576d11144db9a5b2f8461d469e24ac05af2386a. Evaluation JSON. Accessed 2026 Oct 14.