閉経の生理学的な変化を年齢の異なる集団からどう復元したか
最終月経を基準にした集団軌跡を復元するYoGlenを読む。独自の合成計算で、年齢平均のぼけと、FMP年齢のばらつきに依存する応答幅を確かめる。
On this page
「閉経で全身の検査値が急に変わる」。そう聞くと、同じ人から何年も採血し、その変わり目を捉えた研究を想像する。今回おもしろいのは、別の道を通っているところだ。
Pridham、Hayutらの研究は、年齢の異なる人たちの検査データから、最終月経を基準にした集団の時間変化を復元した。2026年10月12日にNature Medicineで公開され、The journal also featured it on X (1)。
私は「崖」という言葉より、時計の合わせ方が気になった。50歳という年齢が同じでも、最終月経の前にいる人と後にいる人が混ざっている。その混ざり方が分かれば、ぼやけた変化をどこまで戻せるのだろう。
まず原著の方法を整理し、そのあとで小さな計算をする。計算に使うのは私が設定した合成データである。実際の閉経年齢の分布や検査値を推定したものでも、原著のYoGlenを再実行したものでもない。
年齢をそろえても生物学的な時刻はそろわない
最終月経をFMP(final menstrual period)と書く。ここでの時間ゼロは、最後の月経があった時点だ。閉経を確認できるのは、その後12か月月経がないことが分かってからになる。この二つの時点を混ぜないようにしたい (2)。
個人の現在年齢を \(a\)、FMP時の年齢を \(M\) とすれば、FMPからの時間は
\[ t=a-M \]
になる。同じ50歳でも、\(M=47\) ならFMPの3年後、\(M=53\) なら3年前である。年齢別に平均した図では、両者が同じ場所に入る。個人を通して見ると急な変化でも、集団を年齢で並べると緩やかに見えうる。
この問題は閉経だけに限らない。発症、薬の開始、再燃などからの経過時間を見たいのに、その起点が記録されていない。代わりに年齢や登録日を横軸にする。データは多くても、見たい時計で整列しているとは限らない。
原著は情報の違う二つの集団を使った
原著の対象は米国NHANESとイスラエルClalit。合わせて約3億件の検査を扱っているが、これは3億人という意味ではない。また、Clalitの元の記録が縦断的であることと、主要な復元結果が同一人物の変化を直接追った曲線であることは別だ。著者が求めたのは、FMP相対時間でそろえたときの横断的な集団平均の軌跡である。(Original paper, Methods)
著者らは、女性と男性を比較した検査値の変化が90検査中52検査で有意だったと報告している。変化の方向は一様ではなく、鉄や赤血球関連の指標も含まれる。「全身が一斉に悪くなる」という要約にはしたくない。(Original paper, Fig. 2 and Results)
表1. 二つの集団で利用できる時刻情報と復元方法。
| Data | Information for time alignment | Reconstruction |
|---|---|---|
| NHANES | Age, menstrual status and self-reported FMP age for some participants | Latent FMP ages are multiply imputed; flexible regression models are compared and averaged |
| Clalit | Age-specific laboratory measurements; menstrual status unavailable | A reference FMP-age distribution connects age-specific averages to a piecewise-linear response with a jump and slope change |
NHANESでは15組の代入データを作り、不確実性を統合している。月経状態が分かれば、FMPが現在より前か後かという制約が入る。自己申告のFMP年齢がある人は、さらに情報が増える。年齢だけから全員の時計を当てているわけではない。
Clalitの基本モデルには、次の形の項が含まれる。
\[ f(t)=\beta_0+\alpha_0t+ (\beta_m+\alpha_mt)\mathbf{1}(t>0) \]
これは原著の区分線形モデルから、追加の変化点を省いた表現だ。\(\beta_m\) がFMPでの段差、\(\alpha_m\) が前後での傾きの差を表す。段差を表現できる形を先に用意して、その大きさをデータに合わせている。
だから、復元後の図に角があるというだけで、任意の滑らかな変化より段差が正しいと決まるわけではない。一方で「段差を許したから、全部人工物だ」と片づけるのも雑だ。NHANESでは段差を持たない候補も含めたモデル比較があり、別集団との一致や、縦断研究SWANとのホルモン軌跡の比較も行っている。どの情報と検証が形を支えているかを、方法ごとに読む必要がある。(Original paper, YoGlen and model selection)
ぼける仕組みだけ式で取り出す
ここからは原著を離れ、計算しやすい設定にする。全員が同じ平均応答 \(f(t)\) を持ち、FMP年齢の分布 \(p(M)\) が現在年齢によらず共通と仮定する。年齢そのものの別の効果、出生世代の差、受診や検査の選ばれ方は入れない。
すると、年齢 \(a\) における集団平均は
\[ g(a)=\int f(a-M)p(M)\,dM \]
となる。違う時刻にいる人を重ね合わせた結果が \(g\) で、その重ね合わせを戻すのが、この設定でのデコンボリューションである。
ここでの \(f\) は、全員に共通と置いた平均的な応答だ。実際の人に同じ曲線を当てはめられるという主張ではない。月経状態や既知のFMPを使うYoGlenの情報も、この式だけの例には入っていない。
応答の形には標準正規分布の累積分布関数 \(\Phi\) を使う。
\[ f(t)=\Phi(t/\tau),\qquad M\sim N(50,\sigma_M^2) \]
\(f\) は0から1へ移る、滑らかな曲線である。検査の単位は付けず、\(\tau\) を変化の幅を調節するパラメータとする。FMP年齢も説明用に正規分布とし、その標準偏差が \(\sigma_M\) だ。この設定なら、積分した答えを厳密に書ける。
\[ g(a)=\Phi\!\left( \frac{a-50}{\sqrt{\tau^2+\sigma_M^2}} \right) \]
観測された曲線の幅には、応答そのものの幅と、FMP年齢のばらつきが合わさって入る。
同じ年齢平均を違う変化から作れてしまう
まず \(\tau=1.5\) 年、\(\sigma_M=4\) 年と置く。観測曲線の幅パラメータは
\[ \sqrt{1.5^2+4^2}=\sqrt{18.25}\simeq4.272\ \text{年} \]
になる。変化の10%から90%までにかかる時間を使うと、幅は \(2\Phi^{-1}(0.9)\tau\) で求められる。元の応答は約3.845年、年齢で平均した曲線は約10.950年になる。幅パラメータの1.5年と、10–90%幅の3.845年は別の量だ。
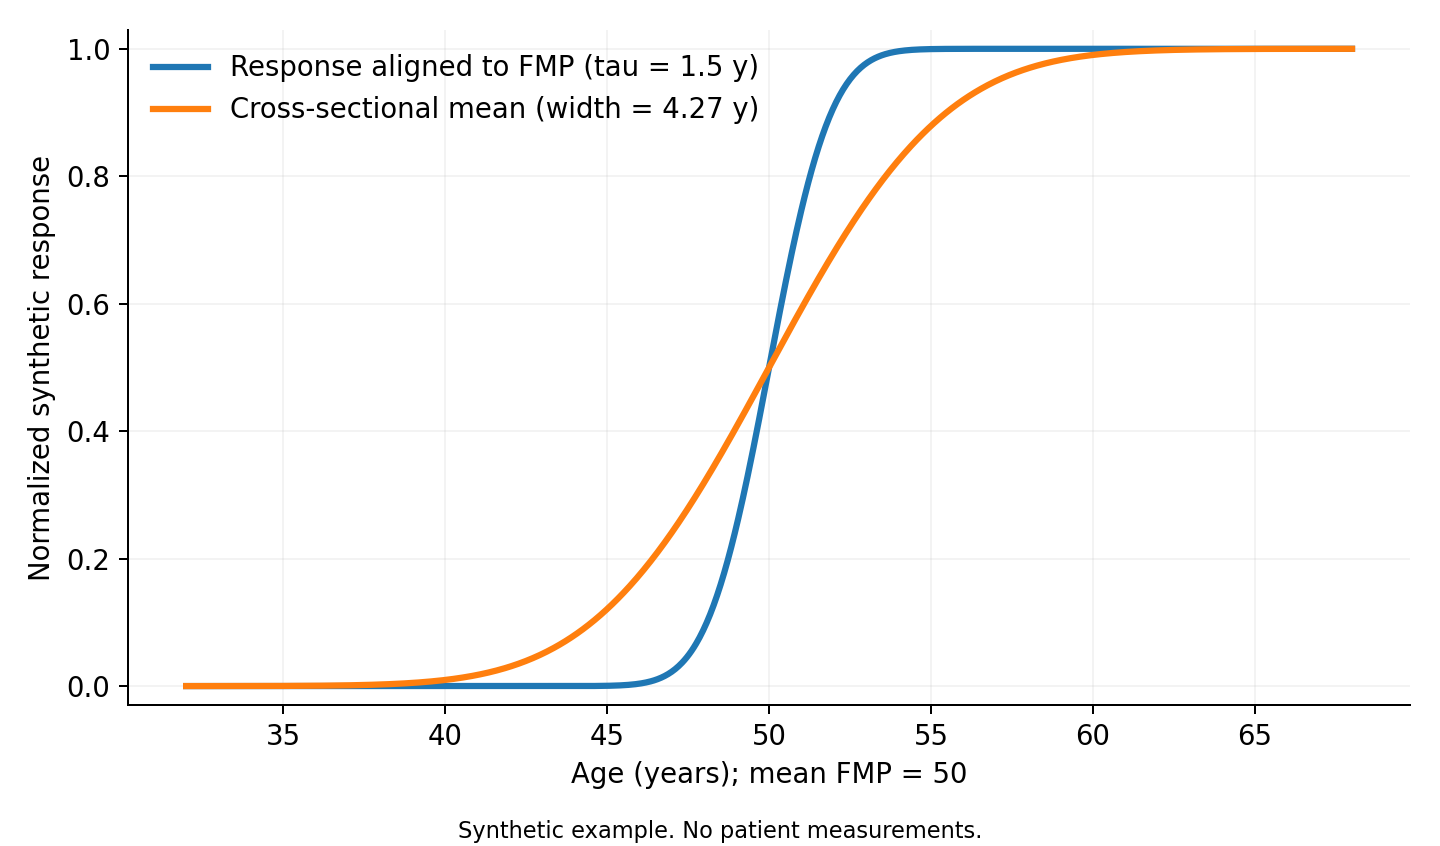
図1:筆者の合成計算。年齢平均では変化が広がる。単位のない0〜1の応答を使っており、実測検査値、臨床的な変化期間、原著の図を表すものではない。
さらに、観測曲線を固定して、FMP年齢の標準偏差について別の値を仮定してみる。復元される応答幅は
\[ \tau_{\mathrm{assumed}}= \sqrt{18.25-\sigma_{M,\mathrm{assumed}}^2} \]
になる。
表2. 同一の年齢平均を生むFMP分布と応答幅の組合せ。
| Assumed FMP-age standard deviation | Reconstructed response scale | Response 10–90% width |
|---|---|---|
| 2.0 years | 3.775 years | 9.676 years |
| 3.0 years | 3.041 years | 7.795 years |
| 4.0 years | 1.500 years | 3.845 years |
| 4.2 years | 0.781 years | 2.002 years |
この4組は、年齢平均の曲線が完全に同じになるように作ってある。データが少ないせいで区別できない、という例ではない。この設定で年齢平均だけを見ている限り、ノイズをゼロにしても二つの幅を別々には決められない。
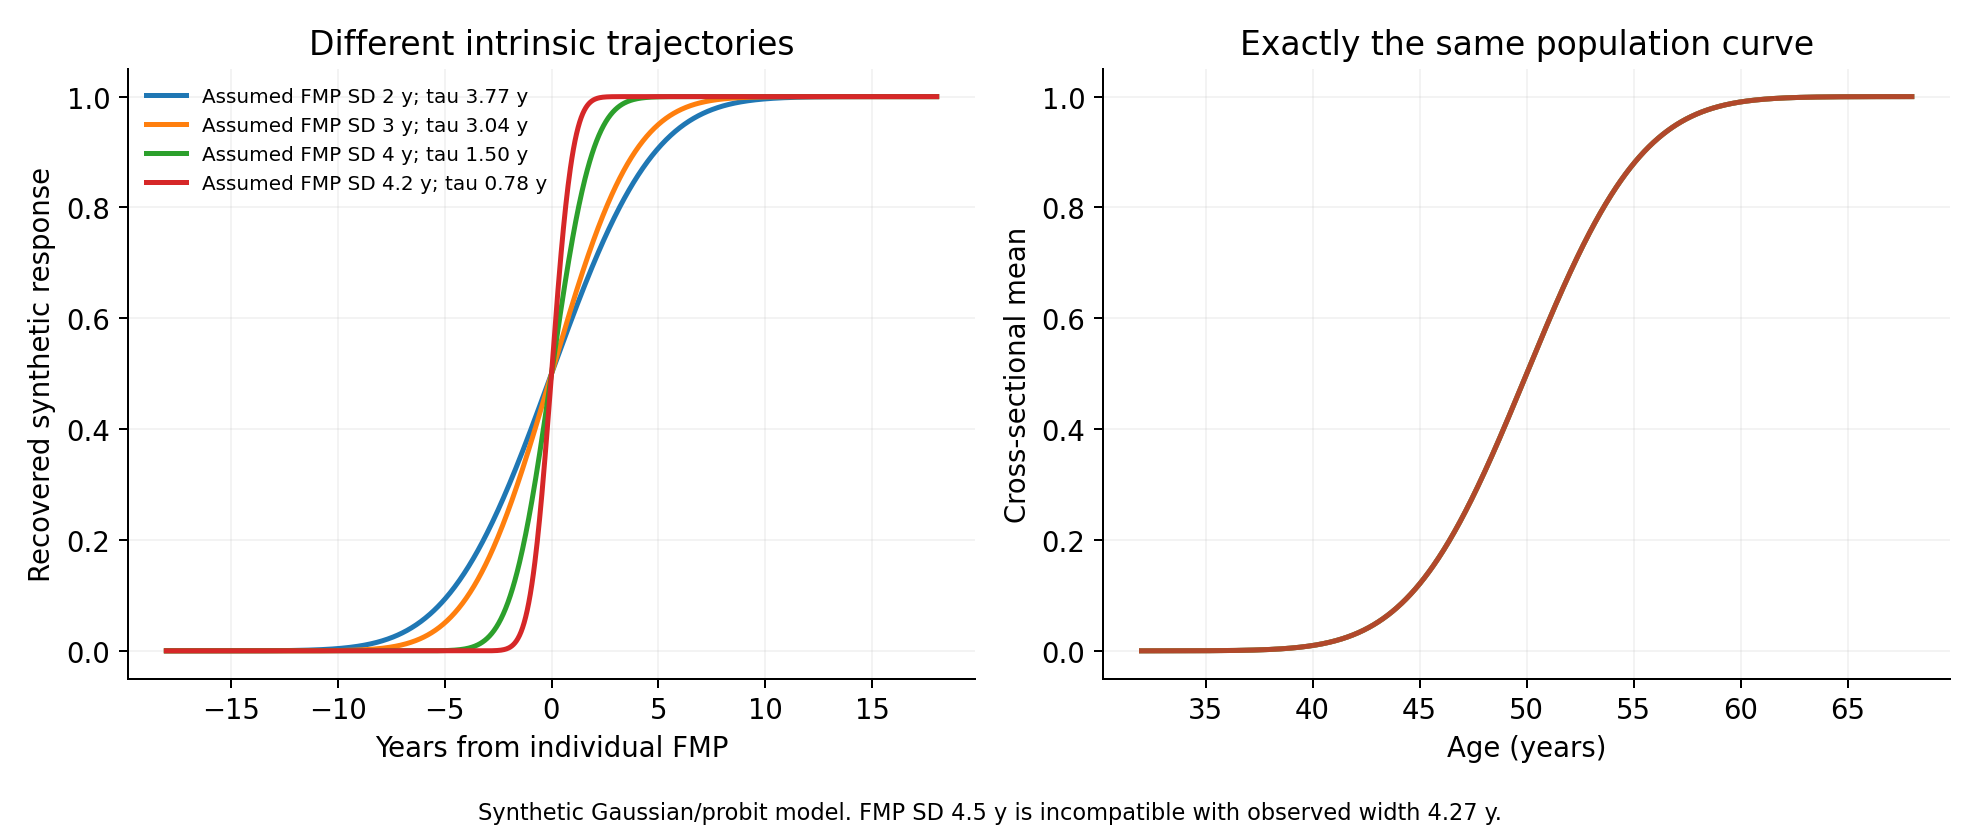
図2:筆者の合成計算。FMP年齢のばらつきと応答幅の組合せを変えても、合成された年齢平均は一致する。右の4本は重なっている。原著の感度分析の再現ではない。
FMPの標準偏差を4.5年と置くと、平方根の中は負になる。その場合、この曲線を説明できる実数の \(\tau\) は存在しない。ゼロに丸めて「瞬間的な変化」と報告するのは誤りだ。観測と仮定が、このモデルの中で両立しないという結果になる。
原著の結論へそのまま持ち込まない
この計算をしたあとに原著へ戻ると、追加情報の役割がよく見える。月経状態や自己申告のFMPがあれば、年齢平均だけに頼る例とは条件が変わる。応答の関数形にも制約がある。そうした条件の下で、何が安定して求まるかを確かめるのが実際の解析だ。
著者ら自身もFMP分布の平均や幅を変えたシミュレーションで、復元結果への影響を点検している。私の表を、著者が幅の感度を調べていないという指摘や、YoGlen全体が識別できないという証拠として読むことはできない。(Original paper, Extended Data Figs. 1–2)
復元曲線の解釈は、FMPが既知か、月経状態だけ既知か、どちらも不明かで異なる。さらに、段差や滑らかな移行を表現できるモデルの範囲と、FMP分布・モデル・対象者の選択への感度に依存する。横断的な集団平均から、個人の経過や予測へ直接は移れない。
なお、Original paper Fig. 2bのjumpは、3年間の変化を女性と男性で比較した量として定義されている。Clalitモデルの段差係数と、すべて同じ意味ではない。
「崖」が本当に数学的な不連続なのか、それとも数年のうちに起こる急な変化なのかも、別の問いである。有限の測定頻度で得られた曲線から、幅が厳密にゼロと決めるのは難しい。生理学的に重要な変化を示すために、ゼロ幅まで言い切る必要もない。
時計の情報もモデルを絞る観測になる
原著はホルモン療法を使う人で変化が小さい傾向も報告している。ただし、治療を選ぶ人と選ばない人では背景が違いうる。時間軸や観測された背景を調整しても、それだけで治療による利益や個人への推奨は決まらない。(Original paper, Discussion)
今回の計算例では、同じ観測を説明する複数の時間変化を実際に作れた。観測の横軸と、変化を起こす過程の横軸がずれていると、鋭い変化がなだらかに見えることも、その逆算が一意に定まらないこともある。
原著では、その自由度を月経情報、モデル構造、別集団や縦断研究との照合で絞っている。復元された曲線の形は、血液の測定数だけで決まったものではない。失われた時計について、どれだけ独立した記録が残っているかにも支えられている。
データとコードの公開状況
計算・図・結果CSVをまとめたZIPに、独自に書いたPythonコードと実行条件を収録した。PythonとNumPy、SciPy、Matplotlibを使う。実測データのダウンロード、YoGlenの実行、患者個人のFMP推定は行わない。
python -m pip install -r requirements.txt
python analysis.py
python -m unittest test_analysis.py
python plot.py
正規分布・probit応答の厳密式と、独立な数値積分が一致すること、異なる幅の組合せが同じ観測を生むこと、両立しない幅の指定を検出することを検査する。記事の図はすべてこの合成計算から作成した。原著の図・データ・実装は同梱していない。
参照資料の確認日は2026年10月18日。原著の公開実装YoGlen (3) は参照用で、本記事の独自計算には利用していない。
参照
1. Pridham G, Hayut Y, Lavi-Shoseyov N, Neeman M, Hovav N, Toledano Y, et al. Population-scale reconstruction of menopause dynamics reveals a physiological cliff at the final menstrual period. Nature Medicine. 2026;32:3823–3831. doi:10.1038/s41591-026-04614-0.
2. National Institute on Aging. What is menopause? Health information.
3. Alon Lab. YoGlen. GitHub repository. Source code.