がんで痩せ始めたのはいつか。悪液質データの時間軸を調べる
52,236人の公開エピソード表を集計し、基準日・最低BMI・終了の違いを読む。原著本文とコードで時刻の定義を確かめ、血液解析とリスク予測が先行性を検証していない理由を示す。
On this page
「体重が減る前に、血液に兆候が出る」。そう言えれば、早く介入する手掛かりになりそうだ。ただ、この一文の「前」は、どの日をゼロにしたかで変わる。
最後に体重が安定していた日か。減少率が基準を超えた日か。あとから記録を見直して、体重減少の区間が始まったと決めた日か。この三つを同じ発症日として扱うと、きれいな解析でも問いがずれてしまう。
Castillonらのがん悪液質アトラスは、52,236人の診療記録から、体重減少を一度きりの患者分類ではなく、繰り返しうるエピソードとして捉えた研究だ。2026年10月12日に公開された (1)。
本記事では、原著のオープンアクセス本文(Methods、Results、Discussionを含む)、公開されたエピソード表とデータ辞書、固定したコミットの検出コードとその一部の図作成スクリプトを読んだ。Supplementary Tables、Extended Data、血液検査の個票、図作成スクリプトが読み込む中間ファイルは確認していない。公開表に血液検査の時系列は含まれない。そこで、前兆を予測できたかという話へ急がず、まず体重減少の時計を確かめた。問いは二つである。公開表の時刻の変数は何を意味するか。その意味は、原著の血液解析や予測モデルの読み方に何を残すか。
一人に一つの「悪液質あり」では足りない
原著はMSK-IMPACT(Memorial Sloan Ketteringの腫瘍遺伝子パネル検査)を受けた成人の診療記録を使っている。データを得た79,240人から、複数原発がんの患者、診断日が最初のBMI測定より後の患者、18歳未満、BMIのない患者、BMI測定が2回未満または追跡180日未満の患者を除き、1,741,505件の縦断的な体格指数(BMI)の測定を検査値や腫瘍の情報と結び付けた。対象は十分な体重記録や追跡期間を持つ患者であり、すべてのがん患者をそのまま代表する集団ではない(原著のMethods、1)。
体重減少の基本基準は180日以内に5%以上、開始時の平滑化BMIが20未満なら2%以上である。原著はこれを、Fearonらの国際合意の診断基準(体重減少5%超、またはBMI 20 kg/m²未満や筋肉量減少があれば2%超)に基づくと位置付けている (2)。BMIは指数加重移動平均(α = 0.2)で平滑化し、平滑化後の軌跡へ基準を当てる。候補区間は重なるものを統合し、15日以上続くものだけを残す。浮腫のような一時的な体重増加が作る見かけの減少は、5%以上増えて30日以内に2%以内へ戻る窓と重なる区間を除く品質管理で扱っている (1)。
これは体重減少に基づくエピソードの定義だ。合意の定義には筋肉量の減少、通常の栄養支持で完全には戻らないこと、機能障害も含まれるが、原著は筋肉量の画像や栄養支持の記録が全体では得られず、これらを実装できなかったと限界に書いている (1, 2)。以下で「エピソードが終わる」と書くときも、悪液質の病態が治ったという意味には使わない。
公開CSVとデータ辞書 (3)を集計すると、行数は58,817だった。患者数より多い。エピソードを経験した人には複数行があり、経験しなかった人には非エピソード行が1行ずつあるからだ。
表1. 公開エピソード表の患者数と区間数。
| Aggregate | Result |
|---|---|
| Unique patients | 52,236 |
| Patients with episodes | 24,357 (46.63%) |
| Episodes | 30,938 |
| Patients with at least 2 episodes | 5,496 |
| Fraction with at least 2 episodes among affected patients | 22.56% |
人数の割合を計算するときには一人一票に戻した。30,938件を30,938人として扱えば、繰り返した人を何度も数えてしまう。一方、エピソードの期間を記述するときは1件を1区間として数える。この後の分布は、患者ごとの平均期間の分布ではない。
この集計は原著本文の数値と一致した。患者の46.63%、そのうち複数回の割合22.56%に加え、10%以上および15%以上の基準に相当する患者フラグから計算した割合も19.4%と6.9%で、本文の値と同じだった (1)。同じ表から作った値どうしなので独立した検証ではなく、公開表が本文と同じ検出結果であることの確認にとどまる(集計: results/summary.json)。
公開コードには開始と到達が別々にある
公開データ辞書のstart_dayは、検出の窓が始まる基準時点(180日のスライディング窓のベースライン)と説明されている。end_dayは、統合した区間のなかで基準を満たす最後の日で、最低値の日ではない。著者らの検出コードのREADME (4) には、各基準日から先の180日を探すことが明記されている。固定したコミットのスクリプトでは、各測定日を基準にして、その後の180日以内で平滑化BMIが基準より閾値以上低い最初の日をonset_day、最後の日をend_dayとして記録し、重なる検出を統合する。start_dayは統合した区間の最も早い基準日であり、最初の検出については、onset_dayがstart_dayから最大180日後になる。
原著のMethodsは、エピソードの開始を最初の基準到達時点と記している (1)。この文だけを読むと、onset_dayに近い定義にも読める。本記事は公開表の列について、データ辞書とコードに従い、start_dayを基準日として扱う。原著本文の言い回しとの差は解消できていない。
これは後から体重減少を区間として定義するための手順であり、未来を見たこと自体が誤りなのではない。ただし、その区間の基準日を「その日に悪液質を検出できた日」として使うと、用途が変わる。
説明用に、次の記録を考える。実測患者の抜粋ではない。
表2. 時刻の違いを説明する仮想体重記録。
| Day | Weight | Information available by then |
|---|---|---|
| 0 | 70.0 kg | Candidate reference measurement |
| 30 | 69.0 kg | From day 0, approximately 1.4% loss |
| 90 | 66.0 kg | From day 0, approximately 5.7% loss |
この例で生の測定値だけを使うなら、0日を基準に5%以上減ったことが分かるのは90日である。後ろ向きに「0日からの減少区間」と呼べても、0日に90日の体重は知らない。原著の実装には平滑化や区間統合などもあり、この3点の表で再現したわけではない。なお指数加重移動平均(α = 0.2)は過去の測定値も残すため、減少する系列では基準到達が生の測定値より遅れうる。公開コードはpandasの既定の正規化(adjust=True)を使い、有限系列で直近値の重みが常に0.2になるわけではない。
ところが、公開されたエピソード表にはonset_dayがない。start_day、最低BMIの日であるnadir_day、終了を表すend_dayはあるが、閾値への最初の到達時点は、この表だけでは再構築できない。したがってstartからnadirまでの日数を、検出の遅れや早期介入できる猶予と呼ぶこともできない。
180日の窓でもエピソードは180日で終わらない
公開表の30,938件について、startからnadirまでの日数を計算すると、中央値196日、四分位範囲147〜273日だった。エピソード全体のstartからendまでは中央値212日である。180日以内の減少を見る仕組みなのに、それを超える期間がある。
矛盾ではない。重なる候補窓を統合して、一つの長い区間になるからだ。検出に使う窓の幅と、統合したエピソードの長さは異なる。
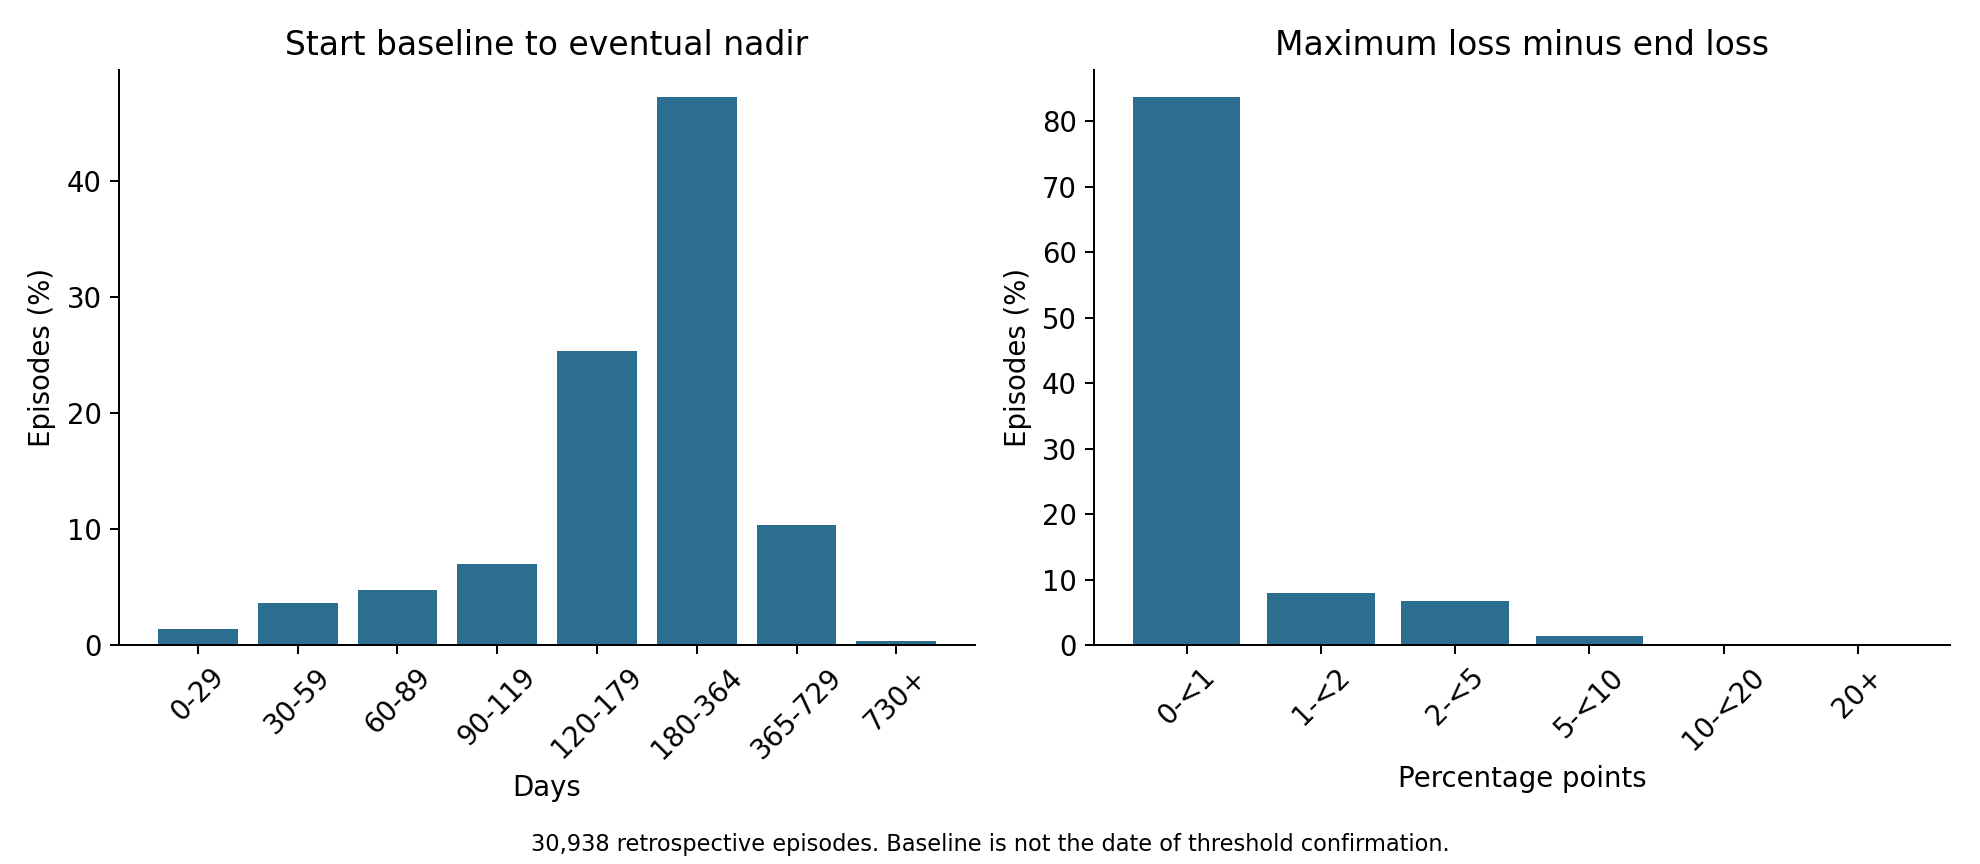
図1. 公開エピソード表から筆者が計算。左は基準日から最低BMIまでの日数、右は最大減少率と終了時減少率の差である。いずれも後ろ向きの記述量で、前向きの検出所要時間や介入可能期間ではない。
最大減少率が終了時の減少率を上回る区間、つまり最低BMIの日が終了日より前にあり、終了時のBMIがそれより高い区間も11,685件、37.77%あった。最低値から少し戻っても、統合した窓の中では減少基準を満たし続けることがある。最低BMIの日から終了日までは、中央値0日、75%点28日、90%点67日、最大363日だった。終了日には、その区間で一番低い体重が記録されているとは限らない。
最後の体重だけで判定し直すと違うイベントになる
開始時から最終時点までの減少率と、開始時から最低値までの最大減少率を比べた。公開辞書でも、この二つは別の量として定義されている。
全30,938件の最大減少率は、それぞれに適用される基準を満たしていた。一方、開始から終了までの減少率だけを使うと、1,376件、4.45%は元の基準を下回る。
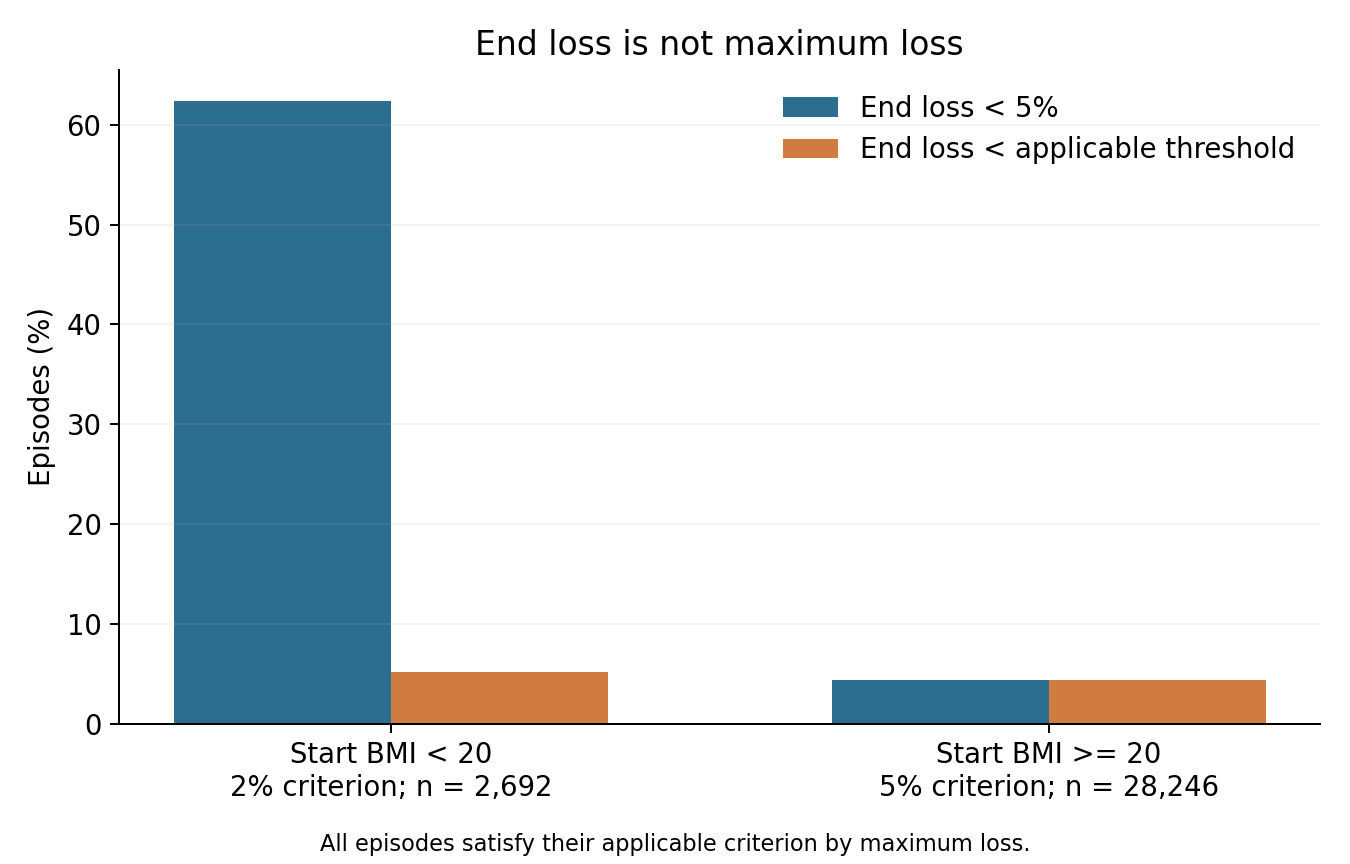
図2. 筆者の集計。開始時BMIが20未満では2%、それ以外では5%という基準を区別した。元の検出をやり直した図ではなく、公開表にある二つの要約値を比較したもの。
表3. 開始時BMI別の基準と終了時の減少率。
| Starting smoothed BMI | Applicable loss threshold | Episodes | End loss below applicable threshold |
|---|---|---|---|
| Below 20 | 2% | 2,692 | 140 |
| At least 20 | 5% | 28,246 | 1,236 |
終了時の減少率が5%未満という条件だけなら2,915件になる。しかし、この数には最初から2%基準が適用される区間が含まれる。5%を全員共通の基準として扱うと、取りこぼしを大きく見積もってしまう。
この差は、元のアルゴリズムの不備を示すものではない。区間内で一度起きた低下と、その後を含む区間の最後の状態を、別の数字が表している。データ辞書によれば、end_dayは区間内の別の基準日から見て基準を満たす最後の日であり、start_dayの基準から見た減少率がend_dayで基準を満たすとは限らない。終了時の体重だけを取り出して、同じ現象を評価しているつもりになる方が危ない。
どちらの要約値を重症度に使うかで、値が変わる区間は多くない。最大減少率と終了時減少率の差は、62.23%の区間で0、90%点でも1.7パーセントポイント、最大で19.6パーセントポイントだった。5パーセントポイント以上の差があるのは468件(1.51%)である。原著の平均の体重減少10.45%や重症度分類(WLGS)が、どちらの減少率に基づくかは、読んだ本文では明示されていない (1)。二つの量は大半の区間で一致するが、区間ごとの重症度では、上記の468件で選択が結果を変えうる。
なお、公開表には終了時刻が記載された観測・生存期間を超える行が1件あった。今回の記述集計では件数を保った全行の値と、その1件を除いた感度を確認した。日付を推測して補正せず、生存解析にも使っていない。詳細は配布資料に記録している。
血液との関連と将来の減少の予測は異なる
原著は、エピソード内の血液検査に共通する特徴や、腫瘍ゲノムとの関連も調べている。血液の解析は、検査値と年齢、性別を説明変数、検査日がエピソード区間に入るかを目的変数とし、患者ごとのランダム切片を置く混合効果ロジスティック回帰である。検査はエピソード区間との日付の重なりで「エピソード中」か「外」かに分類される (1)。アルブミンの平均log2オッズ比は−0.89(95%信頼区間 −1.01〜−0.76)で、基準値を下回る測定は区間内の28.4%、区間外の12.0%だった。原著自身が、変化は小さく多くは基準範囲内にとどまると述べ、一部は悪液質ではなく同時期の化学療法でも説明できると注記している (1)。
つまり、エピソード中の検査値が異なることは、同時期の差の記述である。将来の体重減少を予測できることは、別の検証だ。
原著のリスク予測は、血液を入力にしていない。ステージ、ECOG–KPS、ベースラインBMI、TP53やSTK11などの変異を使うCox回帰のノモグラムで、診断後1・2・3年までの累積エピソード確率を扱う。肺腺がん、前立腺がん、大腸がんでのC-indexは0.648、0.670、0.639だった。Methodsによると、これらは全コホートの200回のブートストラップで区間を求めた値であり、50%の保持データで評価した校正・時間依存AUCとは区別する。外部(DFCI)評価はECOG–KPSがないため、共有変数に絞った縮小モデルを肺がんで検討し、C-indexは0.625だった (1)。これは採血を逐次入力して目前の急減を予測するモデルと同じではない。本記事では、そのモデルの再学習も、血液検査の先行性の検証もしていない。原著も、血液の先行性を主張していない。
では、区間の時計の曖昧さは、これらの結果の読み方に何を残すか。原著の生存解析は、時間依存Coxモデルで、エピソード状態が最初のエピソードの発症時点(原文のonset)で0から1へ切り替わると記述している。血液の比較も、検査をエピソード区間との重なりで分類している (1)。固定したコミットの生存解析の図作成スクリプトは、区間ファイルのstart_dayとend_dayの列を、曝露区間の始点と終点に改名して使っている。ただし、そのファイルの作成過程は確認できていないので、公表されたハザード比や血液の比較がstart_dayに基づくのかonset_dayに基づくのかは、読んだ範囲では断定できない。
仮にstart_dayが区間の始点なら、次の読み方になる。時間依存モデルの「曝露あり」の期間は、基準到達を観測できる最大180日前から始まる。その期間の患者は、のちに基準を満たすまで生存して追跡されていた人に限られる。これは、曝露の定義が将来の生存を条件にする、不死時間の構造に当たり、曝露群の死亡を過小に見せる方向に働く (5, 6)。また、血液の「エピソード中」の比較には、基準を満たす前の検査が含まれる。この場合、比較は基準到達後の状態の差でも、基準到達前の前兆でもなく、両者の混合になる。どの方向にどれだけ影響するかは、公開表と読んだ資料からは見積もれない。この構造が実際の解析にあるかは確認できていない。公表ハザード比の偏りの方向・大きさは断定せず、まず解析に使った区間ファイルの生成過程と時間原点を照合する必要がある。
関連する先行研究として、Yinらは、入院時点までの体重変化から、1か月後に診断が外れる「可逆的な悪液質」を予測する機械学習モデルを報告し、Chenらは、ベースラインの特徴(HDL、C反応性蛋白とアルブミンの比など)から前悪液質と悪液質を識別するモデルを報告している (7, 8)。この二つは抄録だけを確認したので、方法の詳細や検証の設計は評価していない。いずれも診断時点での分類や短期の予測であり、健康システム全体の電子カルテでエピソードの開始時刻を扱った原著とは問いが異なる。ただし、予測に使える入力は、その日までに得られる情報に限るという条件は、どの設計でも同じように課される。
将来の最低体重や区間の終了は、区間が終わる前には分からない。事後的な正解ラベルの作成に使える情報と、その日に予測へ入力できた情報には差がある。
加えて、採血しなかった日は、値が正常だった日ではない。体重を測らなくなった期間も、減少が止まった期間とは限らない。観測頻度や打切りを記録しておかないと、生物学的な変化と、病院で記録される機会の変化が混ざる。
30,938件のエピソードがあっても、「その日に何を知っていたか」は別に復元しなければならない。
結論
「体重が減る前に血液に兆候が出る」を検証するには、予測を行う日と基準到達日を区別し、予測日までの検査だけを入力にする必要がある。基準到達日をゼロとして先行時間を測る設計なら、その到達日は当日までの情報で判定できるものにする。公開エピソード表にはその日(onset_day)がない。start_dayは先の180日を見て決めた基準日で、nadir_dayとend_dayも事後に決まる。したがって、この表から前兆の先行時間も介入できる猶予も、見積もれない。
確認できたのは次の点である。52,236人のうち24,357人(46.63%)に30,938件のエピソードがあり、その区間は検出窓の180日を超えて中央値212日続く。37.77%の区間では終了時のBMIが最低値より高く、終了時の体重だけで判定すると、1,376件(4.45%)が元の基準を満たさなくなる。原著の血液解析は同時期の差であり、リスク予測は血液を入力にしない。血液の先行性は、原著でも本記事でも検証されていない。
本記事の確認は、公開表、データ辞書、コードに基づく定義の整理であり、原著の個票や中間ファイルでの再解析ではない。原著の主要な結果の方向を覆す証拠は得ていない。
データとコードの公開状況
集計コード・集約入力・結果・図をまとめたZIPに、分母、閾値、期間、除外感度を記録した。患者IDや個人ごとのエピソード表は同梱せず、公開元から集約するスクリプトと出典を付けている。原著の図や実装も同梱していない。
python -m pip install -r requirements.txt
python analysis.py
python -m unittest test_analysis.py
python plot.py
追加した区間末尾との差の件数・分位点は、補助集計コードでも確認できる。pandasを導入し、公開CSVを取得したうえでpython extra-episode-checks.py 公開CSVのパスを実行する。患者IDや個別行は出力しない。
資料確認日は、公開表とコードが2026年10月18日、原著本文が2026年10月29日である。確認したのは、原著 (1)、公開データと辞書 (3)、コミットを固定した検出コードのREADMEとスクリプト (4) である。
参照
-
Castillon VJ, Xie AX, Boscenco S, Tse E, Ruthen N, Wang J, et al. A health-system-scale, episode-resolved multimodal atlas of cancer cachexia. Nat Med. 2026. doi:10.1038/s41591-026-04689-9. Published online 2026 Oct 12.
-
Fearon K, Strasser F, Anker SD, Bosaeus I, Bruera E, Fainsinger RL, et al. Definition and classification of cancer cachexia: an international consensus. Lancet Oncol. 2011;12(5):489–495. doi:10.1016/S1470-2045(10)70218-7.
-
Reznik E, Castillon VJ. A health-system-scale, episode-resolved multimodal atlas of cancer cachexia [dataset]. Zenodo. 2026. doi:10.5281/zenodo.22045313.
-
Reznik Laboratory. Cancer cachexia episode identification [source code]. Commit 5d63b83a7ca3915949d4a0131e8b0c7ec52f8903. Detection-code README.
-
Lévesque LE, Hanley JA, Kezouh A, Suissa S. Problem of immortal time bias in cohort studies: example using statins for preventing progression of diabetes. BMJ. 2010;340:b5087. doi:10.1136/bmj.b5087.
-
Suissa S. Immortal time bias in pharmaco-epidemiology. Am J Epidemiol. 2008;167(4):492–499. doi:10.1093/aje/kwm324.
-
Yin L, Li N, Lin X, Zhang L, Fan Y, Liu J, et al. Early identification of potentially reversible cancer cachexia using explainable machine learning driven by body weight dynamics: a multicenter cohort study. Am J Clin Nutr. 2025;121(3):535–547. doi:10.1016/j.ajcnut.2025.01.006.
-
Chen Y, Liu C, Zheng X, Liu T, Xie H, Lin SQ, et al. Machine learning to identify precachexia and cachexia: a multicenter, retrospective cohort study. Support Care Cancer. 2024;32(10):630. doi:10.1007/s00520-024-08833-4.