細胞の「刺激履歴」はどこまで読めるのか
IRISの刺激履歴推定を読み、現在の応答分類と軌道に沿う履歴再構成を区別する。公開予測値13万行の閾値感度を集計し、分化条件の改善実験まで検討する。
On this page
細胞を一度測っただけで、その前に何をされたかも分かる。そう聞くと、RNAの中に実験ノートが残っているように思える。
そこまで読めたら、たしかに便利だ。薬剤を除いた後も残る応答や、分化を決めた刺激の順序を、あとから調べられる。ただ、現在の応答を分類することと、過去の入力を復元することの間には距離がある。
2026年9月にNature Methodsで公開されたIRISの論文は、この距離を考えるのによい題材だった。10月のMITの紹介で知った人もいるだろう。私が面白いと思ったのは、履歴という名前以上に、推定をもとに実験条件を変え、実際に確かめた部分だ (1, 2)。
RNAに残るのは入力そのものではない
IRISは、シグナル経路を刺激・阻害した細胞の単一細胞RNA-seqから、刺激に対応する発現パターンを学習する。scANVIを用いた条件付き変分オートエンコーダーを基盤とし、バッチの異なるデータを潜在空間へまとめ、経路ごとの応答を分類する。
実験設計では6経路を扱うが、胚のアトラスに対する主な解析はTGF-β、FGF、BMP、RA、WNTの5経路である。Hedgehogは、最初のマウスES細胞データで刺激細胞数が少なく、十分な評価ができなかった。5経路を二値化すれば組合せは32通りになる。ここで「6経路」と「32通り」を同じ計算の話として混ぜない方がよい。
学習にはマウスとヒトの幹細胞を使い、内胚葉・中胚葉へ向かう異なる段階で刺激を組み合わせている。単一の細胞種で通用するマーカーを選ぶより、難しい課題だ。論文ではスクリーンを丸ごと外す評価や、内胚葉で学習して中胚葉で評価する試験、種をまたぐ評価も行っている。大量の細胞をランダムに分けただけの結果として読むのはもったいない。(1; 原著の図2と方法)
それでも、正解ラベルの出発点は実験で与えた刺激条件である。ある薬剤を添加した事実、細胞内経路がその瞬間に動いていること、その結果がRNAに残っていることは、ぴったり同じではない。
たとえば、刺激を止めてもRNAがすぐには消えないなら、現在の発現から過去の刺激を感じ取れる可能性がある。一方で、現在の刺激の有無を当てたい場面では、その記憶が誤判定の原因になる。同じ現象が、問いによって情報にも邪魔にもなる。
「履歴」は細胞を並べて作っている
IRISの発生過程の解析は、同じ細胞を何日も追いかけた記録ではない。
胚から採取した別々の細胞を、細胞種の注釈や遺伝子発現を使って分化の軌道に並べる。その上へ、各細胞で推定したシグナル応答を重ねる。こうして、どの組合せが軌道の前半に多く、どれが後半に多いかを調べる。Methodsでは、既知の細胞種やマーカーの順序に整合する拡散成分を選んだことも明記されている。
この手順で、心筋系譜や内胚葉系譜について、既知の分化プロトコルと整合するシグナルの順序が得られた。集団の発生軌道に沿った再構成として意味がある。ただし、独立した時計で履歴をすべて確認したわけではない。軌道推定の妥当性を借りている部分がある。(1; 原著の図3と方法)
ここは言葉を少し慎重にしたい。「この軌道ではWNT応答が先に現れる」と「この細胞は昨日WNTを受けた」は、違う主張になる。後者には、刺激後の経過時間や応答の減衰を区別する情報がもっと要る。
前の刺激が残ったらどうなるか
著者らも持ち越しの問題を調べている。連続した刺激ステップを含むヒト中胚葉のデータを使い、直前のステップで同じ経路を刺激した細胞と、しなかった細胞とで、後のステップの偽陽性率を比較した。
結果は一様ではなかった。事前刺激によってBMP、WNT、TGF-βの偽陽性率は上がり、RAでは下がった。FGFでは有意な影響がなかった。多くの経路で偽陽性率は0.3未満だったが、経路ごとに影響の方向まで異なる。(原著の補足図6)
これを「記憶があるから履歴が読めた」と片づけるのは早い。偽陽性の比較は、以前の刺激が現在の判定に影響することを示す。しかし、それだけでは、いつ、どの強さで、何回刺激したかを区別できるとはいえない。
薬剤応答でも同じことが気になる。洗い流した後のRNAが変わっていても、薬剤がまだ残っているのか、下流の応答が遅れて消えるのか、細胞状態自体が変わったのかで、次にすべき実験は違う。IRISをそのまま患者の投薬履歴や薬物濃度の推定に使える、という話にはならない。
公開予測値を二値化し直してみる
この論文は図の元データも公開している。そこでFigure 3 Source Dataから、5経路の予測値が揃う130,000行を取り出し、判定閾値を0.25、0.50、0.75と変えて集計した。IRISの再学習や、生のRNA-seqからの再解析はしていない。
確認したシートには139,331行のデータ領域があったが、末尾9,331行では細胞IDと予測値がなく、発生段階の列だけに値が残っていた。列どうしの対応を十分に確かめられないため、ここでは発生段階や細胞種との結合を使わず、同じ行の5予測値だけを使う。論文全体の139,331細胞を再現した集計とは区別する。
以下の陽性率は、予測値が閾値以上となった行の割合である。0.25と0.75は感度分析のために置いた値で、実験で検証された代替閾値ではない。
表1. 判定閾値を変えたときの予測陽性率と判定変更割合。
| Pathway | Threshold 0.25 | Threshold 0.50 | Threshold 0.75 | Classification changes between 0.25 and 0.75 |
|---|---|---|---|---|
| TGF-β | 37.9% | 36.5% | 35.0% | 2.9% |
| FGF | 61.8% | 52.4% | 43.5% | 18.3% |
| BMP | 46.0% | 42.3% | 38.6% | 7.4% |
| RA | 41.1% | 37.5% | 34.1% | 7.0% |
| WNT | 63.5% | 56.4% | 48.8% | 14.7% |
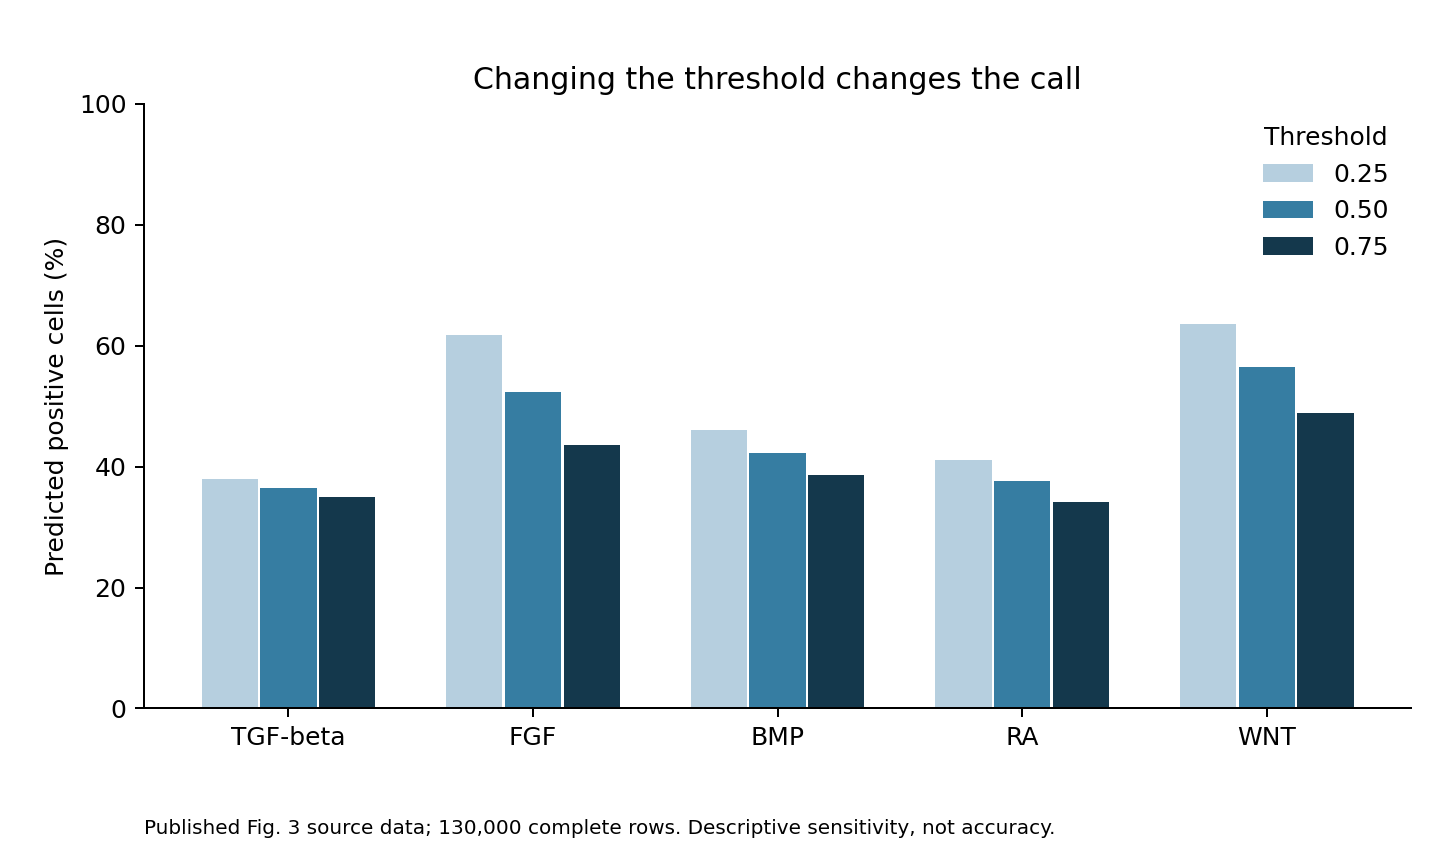
図1. 同じ130,000行の予測値を用いた経路別の閾値感度。閾値の変更による分類の変化であり、正解ラベルとの誤差ではない。
少なくとも1経路の判定が変わった行は54,000、全体の41.5%だった。 経路ごとの割合を足した値ではない。同じ細胞で複数経路が変わる場合を重複させずに数えた。
FGFとWNTでは、二値化する前の値を残して見た方がよさそうだ。一方、これを「41.5%が誤予測」と読むことはできない。このアトラスには、この集計で照合できる刺激の正解ラベルがない。閾値を広く動かしたときの感度を見ただけで、誤差率でも、信頼区間でもない。集団構成に依存する記述統計であり、胚を独立単位とした推測統計も行っていない。
モデルの出力が0.8でも、刺激濃度が0.4の2倍だとはいえない。原著では出力確率の空間的な勾配が既知のモルフォゲン勾配と整合する例が示されるが、それは濃度への校正を済ませたという意味ではない。分類の確信度、刺激の強さ、応答が続いた時間を一つの数字に背負わせない方がよい。
推定を培養条件の変更で確かめる
原著の図4では、推定した応答を培養への介入につないでいる。
マウス前腸のデータにIRISを適用すると、呼吸器の間葉細胞でWNTとBMPの応答が多く推定された。そこで、胚の前腸を取り出した培養でWNTを活性化・阻害し、呼吸器間葉のマーカーを調べている。WNT活性化ではTbx4やFoxf1の発現領域が広がり、阻害ではTbx4発現が失われた。(原著の図4)
さらに、ヒト幹細胞から呼吸器間葉を作る条件を変更した。従来の条件は7日間の分化の最後の24時間にWNT刺激を加えていた。変更後は4日目から早く、長く刺激する。
ただし、Methodsまで読むと濃度も異なる。従来条件は最後の1日にCHIR 2 µM、変更後は3日間CHIR 3 µMである。他経路の条件を保った比較ではあるが、この対比だけで「開始時刻だけの効果」を分離したわけではない。
また、強くすればよいという結果でもない。WNT活性が高い条件ではFOXF1発現が下がり、主要なマーカーを保つには中間の活性がよかったと報告されている。複数のhES・hiPS細胞系で改善を確かめた点は心強い。ただし評価の中心は分化マーカーであり、できた細胞が生体の呼吸器間葉と機能的に同等だと示し切ったわけではない。著者らもWNTの調整だけでは十分でないと述べている。
これは、仮想的にすべての刺激履歴を試して最適条件を確定した話ではない。アトラスから候補を絞り、培養で介入して、次の条件を選んだ研究として読むと、むしろ強みがはっきりする。
同じRNAに至る刺激履歴は一つとは限らない
RNAが似ていても、短い強刺激と長い弱刺激が同じ入力だったことにはならない。入力を止めた後の減衰速度が不明なら、弱い最近の刺激と強い古い刺激も区別しにくい。測定遺伝子を増やすだけで、この非一意性が消えるとは限らない。
IRISでは、発現応答から刺激候補を推定する部分と、細胞を並べて過去の順序を復元する部分が異なる。さらに、培養条件の改善は推定値だけで主張せず、実際に刺激を変えて確かめている。現在の応答の分類、履歴の復元、条件変更の効果を、それぞれの証拠の範囲で読む必要がある。
データとコードの公開状況
集計コードと入力カウントに、閾値の組合せ別の件数、出典と元ファイルのSHA-256、集計・描画コード、検証用テストをまとめた。公開データから算出した件数を再集計するもので、モデルの学習済み重みや原著の図は含めていない。元のExcelから抽出し直す手順はREPRODUCE.mdを参照。
参照
1. Hutchins NT, Meziane M, Lu C, Mitalipova M, Fischer DS, Li P. Reconstructing signaling histories of single cells via perturbation screens and transfer learning. Nature Methods. 2026;23:1973–1983. doi:10.1038/s41592-026-03213-8.
2. Massachusetts Institute of Technology. AI model decodes the language cells use to communicate. MIT News. 2026 October 15. Article.