GWAS候補変異をどの細胞で試すか。GEMSの分母を読む
GEMSの公開集計値を分母から読み直す。細胞への注釈、ATACとRNAの対応、実験系を選ぶ根拠の違いを整理する。
On this page
疾患に関係しそうな変異が見つかった。配列モデルも、その変異には影響があると言う。では、次の実験には何の細胞を使うか。
ここが案外、決まらない。遺伝子の名前が出ても、作用する細胞や状態が違えば、測るべき応答も変わる。仮想摂動に進むにしても、入力する細胞の選び方が曖昧なままでは困る。
2026年10月16日に公開されたプレプリントGEMSは、この手前の問題を扱う。GWAS(ゲノムワイド関連解析)の候補変異に、作用しそうな細胞・組織を結び付ける研究だ。まだ査読前である (1)。
私は、標的を一発で決める道具としてより、候補変異を検証する実験系の選択に、どこまで根拠を足せるかという読み方が面白いと思った。ただ、細胞の候補が付いた割合だけを見ると、その根拠を強く読みすぎる。確認した範囲は、bioRxiv版1の本文(Results、Discussion、Methods)とTable 2である。補足表・補足図は読んでいない。以下の原著の数値は、この本文と表から取った。
配列からの予測を疾患との関連で読み直す
GEMSは、配列からATAC-seq(クロマチンの開きやすさ)やRNA-seq(遺伝子発現)の信号を予測するBorzoi (2) を使う。参照配列と変異配列の予測を比べ、絶対log2 fold changeをz標準化した値を特徴量にする。疾患ごとのRandom Forest (3) で、fine-mapping(SuSiE (4) を使用)の事後包含確率PIPが0.1を超える候補変異と、同一染色体の±500 kb内でPIPが0.01未満の対照変異(候補1個につき5個)を識別する (1)。入力の段階で差の符号を落としているので、この分類器への寄与から発現の増減方向まで読んではいけない。PIPもfine-mappingの仮定に依存する値であり、0.1を超えれば因果変異と確定するわけではない。
この分類器の識別力は大きくない。4形質と3種類の入力(ATAC、RNA、両方)を通じて、AUROCの中央値は0.63(範囲0.58–0.68)、AUPRCのランダム基準に対する倍率は1.2(T2D)から1.6(MS)だった (1)。著者らも、Borzoiの出力は細胞型間で相関が強く、候補と対照を分ける信号は小さいと述べている (1)。後の「付与」は、この弱い分類器の寄与から導かれたものである。
対象は喘息、LDLコレステロール、多発性硬化症(MS)、2型糖尿病(T2D)。品質管理後の特徴はATACが111トラック、RNAが160トラックで、ATACのみ、RNAのみ、両方を使うモデルを別々に作る (1)。ATACの111特徴は、単一核ATAC-seqのアトラスCATlas (5) の細胞型に対応する。RNAにはバルク組織も含まれる。「細胞型の予測」という言葉だけでは、この解像度の違いが抜ける。
その後、SHAP(Shapley値に基づく、特徴ごとの寄与の指標 (6, 7))で各特徴の寄与を調べる。100回の反復モデルとラベルを入れ替えた帰無モデルを比較し、変異ごとにBenjamini–Hochberg法 (8) で多重検定補正したp値(FDR調整済みp値)が0.05未満の対応を残す (1)。これはモデルが候補変異を識別するとき、どの細胞・組織の予測特徴を使ったかという統計的な対応付けである。細胞の遺伝子を操作して効果を実測した結果ではない。「少なくとも一つの細胞に付いた」とは、111または160の特徴のうち一つ以上が閾値を超えたという意味であり、付いた細胞が正しい確率を表す数ではない。
論文には、ATACによる変異と細胞型の対応について、学習に使っていない実験のシス制御領域(cRE)との濃縮解析もある (1)。各形質で最も多く付与された細胞型(MSは微小グリアも追加)の7検定について、その細胞型に付与された変異が、残りの候補変異よりcREと重なりやすいかを片側のFisherの正確確率検定 (9) で調べている。オッズ比は3.7から28.7、2検定(CD4陽性T細胞とメモリーB細胞のcaQTLピーク集合、いずれも約3.6万ピーク)は名目有意に届かなかった。学習元のATACピークと重なる変異を除いても、有意だった検定では濃縮が残る(オッズ比2.7–10.1)。これは、単に既存のピーク表を引き直しているだけではない、という裏付けになる。ただし、比較の背景は残りの候補変異であり、細胞型を取り違えたcRE集合や対照変異との比較は、私が読んだ範囲では見当たらない。強い予測効果を持つ変異が一般に開いた領域にあるだけでも、濃縮は生じうる。領域の濃縮と、個々の変異についての因果的な細胞の確定は別の段階だ。
モデル評価の範囲にも留意したい。Methodsは5分割交差検証を行い、held-out accuracyが上位37.5%の設定からinformativity scoreで最終モデルを選ぶと記す。したがって、そのheld-out成績は少なくとも設定選択に関与しており、選択後に完全に未使用の外部評価があるとは、この記載から確認できない。また、近傍の変異を対照に使うため、LD領域をまたいで分離した評価かどうかも、読んだMethodsだけでは確定できなかった (1)。
さらに、相関の強い細胞型トラックの間では、予測に使う情報を複数の特徴が共有しうる。SHAPによる付与は、そのモデルの説明であって、よく似た細胞型のうち一つを実験的に識別したものではない。100回の乱数反復も、独立したGWAS集団や機能実験を100回追加する操作ではない。
「78%」の前に何を選んだか
抄録では、単独モダリティの解析により、少なくとも一つの細胞・組織を付与できた候補変異の割合が、4形質の中央値でATAC 58.7%、RNA 65.9%と報告されている (1)。注釈を広げる結果としては興味深い。比較として、同じ文献ではCATlasのピークと重なる候補変異は26%とされる (1)。
ただ、この二つの割合を掛けたり引いたりして、同じ変異で両者が一致した率を求めることはできない。形質間の中央値であり、変異の重なりも分からない。さらに、以下の原著のTable 2は、別に学習したマルチモーダルモデルの結果だ。
原著のTable 2の数値を転記し (1, Table 2)、分母を二通りにそろえた。
表1. マルチモーダル解析の候補変異と最多細胞組合せの分母。
| Trait | All candidates N | Significant associations in both modalities B | Largest combination K | K / B | K / N |
|---|---|---|---|---|---|
| Asthma | 547 | 167 | 100 | 59.9% | 18.3% |
| LDL | 985 | 191 | 149 | 78.0% | 15.1% |
| MS | 273 | 80 | 50 | 62.5% | 18.3% |
| T2D | 497 | 10 | 3 | 30.0% | 0.6% |
Bは、ATACとRNAにそれぞれ少なくとも一つ有意な対応がある変異数である。Table 2の定義に従い、RNAのmononuclear cell特徴を除いた集計だ。この条件だけでは、両者が生物学的に同じ細胞を指すとは限らない。Kは、RNA組織とATAC細胞型の組合せを共有変異数で並べたときの最大値だ。変異が一つの細胞にだけ割り当てられたという意味でもない。
LDLの最多の組合せはRNAの肝臓とATACの肝細胞。149 / 191 = 78.0%なので、両モダリティに対応が付いた集団の中では、ここに強く集まる。一方、全985候補から見れば149 / 985 = 15.1%になる。
\[ \frac{K}{N}=\frac{B}{N}\times\frac{K}{B} \]
LDLなら19.4% × 78.0% = 15.1%。集中の強さと、その組合せが全候補のどこまでを覆うかは、同時に見たい。15.1%は精度でも正解率でもなく、最多の一組が両モダリティの有意な対応として拾う、報告された候補集合内の割合だ。
78.0%の読み方にはもう一つ注意が要る。原著Table 2は、ATACとRNAの対応が独立に割り当てられた場合の期待共有変異数も載せている。LDLでは期待が87.0変異、観測が149変異で倍率は1.71である。期待値を観測されたB = 191で割ると87.0 / 191 = 45.5%になる。ただし、これは観測された分母で期待共有数を尺度変換しただけであり、独立な割り当てを行ったときの条件付きK / Bの期待値ではない。割り当てを変えれば、いずれか一つ以上の対応が両モダリティに付くB自体も変わりうるためだ。喘息は期待45.8変異に対し観測100変異(倍率2.18)、MSは期待17.7変異に対し観測50変異(倍率2.82)である (1, Table 2)。三形質で、観測は期待を超え、倍率は1.71から2.82である。ただし、超過の大きさは倍率で見る必要があり、K / Bだけを集中の強さとして比べるのは適切でない。
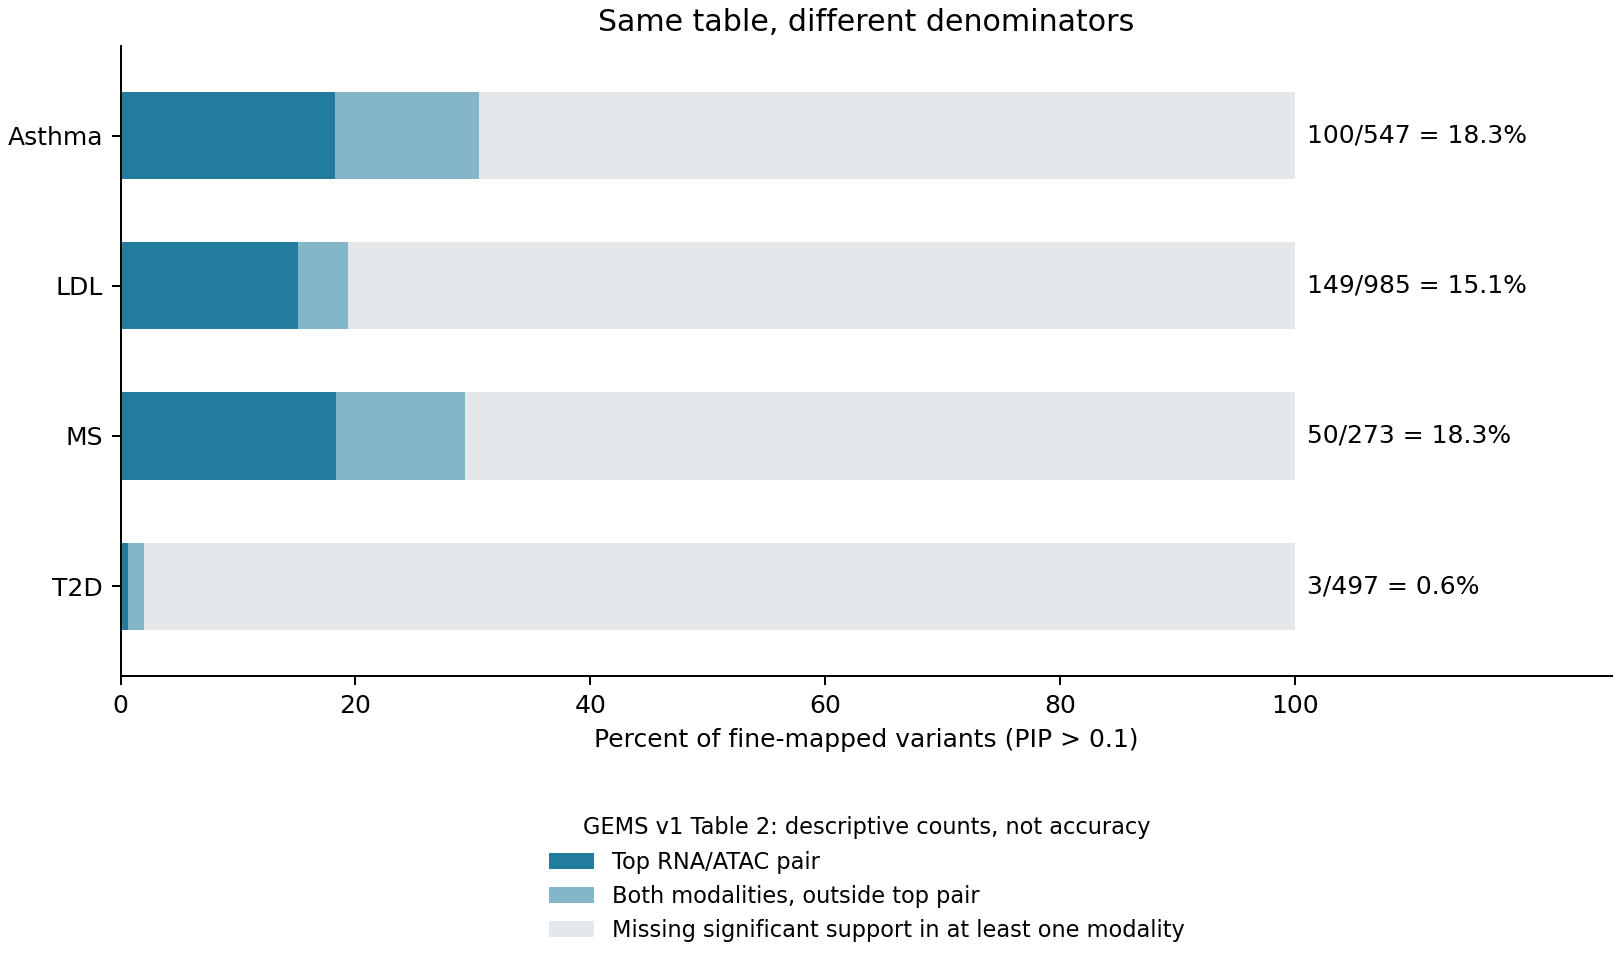
図1. 公開集計値から作った独自の図であり、GEMSを再学習した性能比較ではない。灰色には、片方だけに対応がある変異も、どちらにもない変異も含む。作用がないと判定された変異ではない。また、濃色以外にも実験価値のある細胞はありうる。この図で「肝細胞実験の成功率」を計算することはできない。
T2Dの2%をそのまま失敗とは呼べない
T2Dでは、両モダリティに対応が付くのは10 / 497 = 2.0%。最多の組合せも3変異にとどまる。原著Table 2の期待共有変異数は4.8、倍率は0.63で、原著の超幾何検定では名目有意でない。ただし、非有意は独立性の証明ではない。T2Dの首位に膵臓RNAとdelta+gamma細胞ATACが表示されているが、注記では結腸と結腸粘膜のRNAも3変異で並ぶとされる (1, Table 2)。組み合わさるATAC細胞型は、この注記だけからは読み取れない。共有変異の重なりも分からず、3 + 3 + 3と足してはいけない。10変異のうちの3変異で順位を付けているので、首位の細胞名が安定とは言えない。
気になるのは、単独モデルの膵島ATACへの対応26.0%、膵臓RNAへの対応51.5%を見た後で、この2.0%を「両者の不一致率」に読み替えてしまうことだ。モデルも条件も違う。原著では、マルチモーダルモデルのT2DでATACの有意な対応がある変異が21 / 497(4.2%)にとどまる一方、RNAは63.4%と説明されている。他の三形質ではATACが31.0–41.0%で、T2Dだけが低い (1)。T2Dでは、ATACのみのモデルも基準に対する改善が最も小さく、AUPRCの倍率は1.1だった (1)。ATACの対応が少ないことと、ATACのみの分類器が基準に近い性能にとどまることは、並んで観察されている。分類器の識別力の低さが付与の少なさの一因である可能性はあるが、この二つの観察から原因は特定できない。
著者らは、学習元の膵島細胞の少なさを一因として挙げる。膵島ATACトラックは約15,000核、delta+gammaのような希少な内分泌細胞は約710核に基づく (1)。ただし、この説明自体が、細胞数を増やす介入で確かめられたわけではない。候補が付かない理由を、生物学的な無関係と観測・モデル側の感度不足に分けられない点が残る。
私はここで、ATACとRNAが同じ生物学的な実験系を支持することを、全形質共通の必須条件にするのをためらう。データの薄い細胞ほど、研究対象から落ちやすくなるからだ。逆に、RNAだけで膵臓と出た結果から、特定の膵島細胞まで決めるのも飛躍になる。
対応する細胞が付いたことと実験での妥当性は違う
GEMSの対応には、変異候補そのもののPIP、ATACとRNAの区分、組織と細胞型の解像度が重なる。首位の細胞名だけを抜き出すと、複数候補や未付与の変異、モダリティ間の不一致が見えなくなる。著者ら自身も、変異は単一の因果細胞型ではなく、機能的に近い複数の細胞型に付くのが普通だと述べている (1)。
今回の集計は、特定の細胞を選ぶルールの効果を実証したものではない。したがって、LDLなら肝細胞、T2Dなら特定の膵島細胞というように、この集計だけから次の実験の細胞を決めることはできない。GEMSの対応は、実験系を選ぶ際の手がかりの一つにとどまり、その妥当性は別の実験で確かめる必要がある。両モダリティに対応が付いた割合も、選んだ細胞での機能実験の成功率とは異なる。候補細胞の付与は、変異の作用や薬剤介入の結果がその細胞で確かめられたことを意味しない。
この集計から読み取れる点を、原著の評価に沿って整理する。
第一に、トレイトレベルの細胞型の優先順位は、既存の方法と同じ方向を向く。GEMSは、同じ111細胞型のCATlas注釈を用いた層別化LDスコア回帰(sLDSC (10))と、喘息のCD4陽性T細胞、LDLの肝細胞を首位とする点で一致した。T2Dでは首位の膵島細胞亜型が異なり(sLDSCはbeta 1、GEMSはdelta+gamma)、MSも上位の細胞型が完全には重ならない (1)。ただし、評価に用いた基準は、AI支援の文献検索と手作業の確認で作った「シルバースタンダード」である (1)。この基準でLDLのATACはAUROCが0.66にとどまり、基準に含まれるのは111細胞型中3個だった (1)。既知の細胞型が上位に出たことは、既存の期待と整合する証拠にはなるが、期待に反する細胞を新たに選べる証拠にはなっていない。
第二に、変異ごとの付与には新しい情報が加わるが、その大きさは測り方に依存する。LDLでは、肝細胞ATACへの単独の付与率は45.7%、肝臓RNAは40.0%である (1)。一方、肝臓RNAと肝細胞ATACの両方を要求したときの最多組合せの被覆は、全候補の15.1%に下がる。同一の候補集合に対して、どの基準を課すかで「肝細胞の実験で扱える変異」の見かけの割合が約3倍変わる。この二つは別のモデルの出力であり、差し引きはできない。それでも、実験系の選択に使う数としては、基準を明示した被覆でなければ比較にならない。
第三に、GEMSの位置付けを関連研究と照らす。eQTLは、GWASのシグナルの一部しか説明しないと報告されており (11, 12)、配列モデルによる付与が補完として期待される。Borzoiを、fine-mappingの事前確率の推定に使う方向の研究もある (13)。これは要旨のみ確認した。GEMSは逆に、fine-mappingの結果を教師にして特徴の寄与を読む。どちらも、実験での細胞選択の妥当性そのものを検証してはいない。
以上から、冒頭の問いに対する答えは次のようになる。LDLでは肝臓・肝細胞を候補に含める根拠は複数の見方で一致する。ただし、最多組合せの共有数は独立割り当ての期待値に対して1.71倍であり、78.0%そのものが両者の独立性を超えた情報量ではない。45.5%は期待共有数を観測Bで割った記述値なので、78.0%との差を機能的な上乗せ効果として扱わない。その細胞が最適な実験系かどうかも示されていない。T2Dでは、この集計は細胞の選択を絞り込む情報をほとんど与えない。
限界
- 本文とMethods、Table 2のみを確認し、補足表・補足図は未確認である。変異ごとの付与や、cRE濃縮の元の2×2表は再構成していない。
- Table 2は4形質4行の集計であり、変異単位の表(補足表)は読んでいない。K / NとK / Bは、公開された集計値からの再計算にとどまる。
- 評価の基準(シルバースタンダード)が、既知の細胞型の想定に近い。期待に反する細胞の選択が妥当かどうかは、この枠組みでは検証できない。
- cRE濃縮の背景が残りの候補変異であり、一般的な開いた領域との重なりという別の説明を除けていない(本文で確認した範囲)。
データとコードの公開状況
今回の解析は、original Table 2 (v1)にある4行の数値について、分母の変換と集合の分割を再計算したものだ。候補集合の記述なので、標本抽出を仮定した信頼区間は付けていない。変異間の連鎖不平衡(LD)もあり、独立な試行としての区間を足すのは適切ではない。
本文に記載されたFigshare DOIは、2026年10月20日の確認時点では解決せず、公開APIも404だった。したがって、変異ごとの順位、候補数、PIP加重の被覆率は再解析していない。この状態は確認日時点の記録であり、その後の公開状況を示すものではない。
再集計コード・入力数値・再現手順を添付する。原著の図やPDFは再配布していない。
参照
- Xie X, Qian S, Chang D, Bhangale T, McCarthy MI, Eraslan G, et al. GEMS (GWAS Effect Mechanisms via Sequence-to-Function): Unveiling cell type-specific mechanisms for GWAS variants [Preprint]. bioRxiv; 2026. Version 1, posted 2026 Oct 16. doi:10.64898/2026.10.14.759213. Not peer reviewed. Main text, Methods and Table 2 read; supplementary tables and figures not read.
- Linder J, Srivastava D, Yuan H, Agarwal V, Kelley DR. Predicting RNA-seq coverage from DNA sequence as a unifying model of gene regulation. Nat Genet. 2025;57(4):949–961. doi:10.1038/s41588-024-02053-6.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32. doi:10.1023/A:1010933404324.
- Wang G, Sarkar A, Carbonetto P, Stephens M. A simple new approach to variable selection in regression, with application to genetic fine mapping. J R Stat Soc Series B Stat Methodol. 2020;82(5):1273–1300. doi:10.1111/rssb.12388.
- Zhang K, Hocker JD, Miller M, Hou X, Chiou J, Poirion OB, et al. A single-cell atlas of chromatin accessibility in the human genome. Cell. 2021;184(24):5985–6001.e19. doi:10.1016/j.cell.2021.10.024.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions [Preprint]. arXiv; 2017. arXiv:1705.07874. Persistent URL. Published in: Advances in Neural Information Processing Systems 30 (NIPS 2017).
- Lundberg SM, Erion G, Chen H, DeGrave A, Prutkin JM, Nair B, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56–67. doi:10.1038/s42256-019-0138-9.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Methodol. 1995;57(1):289–300. doi:10.1111/j.2517-6161.1995.tb02031.x.
- Fisher RA. On the interpretation of χ2 from contingency tables, and the calculation of P. J R Stat Soc. 1922;85(1):87–94. doi:10.2307/2340521.
- Finucane HK, Bulik-Sullivan B, Gusev A, Trynka G, Reshef Y, Loh PR, et al. Partitioning heritability by functional annotation using genome-wide association summary statistics. Nat Genet. 2015;47(11):1228–1235. doi:10.1038/ng.3404.
- Mostafavi H, Spence JP, Naqvi S, Pritchard JK. Systematic differences in discovery of genetic effects on gene expression and complex traits. Nat Genet. 2023;55(11):1866–1875. doi:10.1038/s41588-023-01529-1. Abstract read.
- Connally NJ, Nazeen S, Lee D, Shi H, Stamatoyannopoulos J, Chun S, et al. The missing link between genetic association and regulatory function. eLife. 2022;11:e74970. doi:10.7554/eLife.74970. Abstract read.
- Srivastava D, Korsakova A, Wang Q, Ruiz L, Yuan H, Kelley DR. Borzoi-informed fine mapping improves causal variant prioritization in complex trait GWAS [Preprint]. bioRxiv; 2025. Posted 2025 Jul 14. doi:10.1101/2025.07.09.663936. Not peer reviewed; abstract read.